
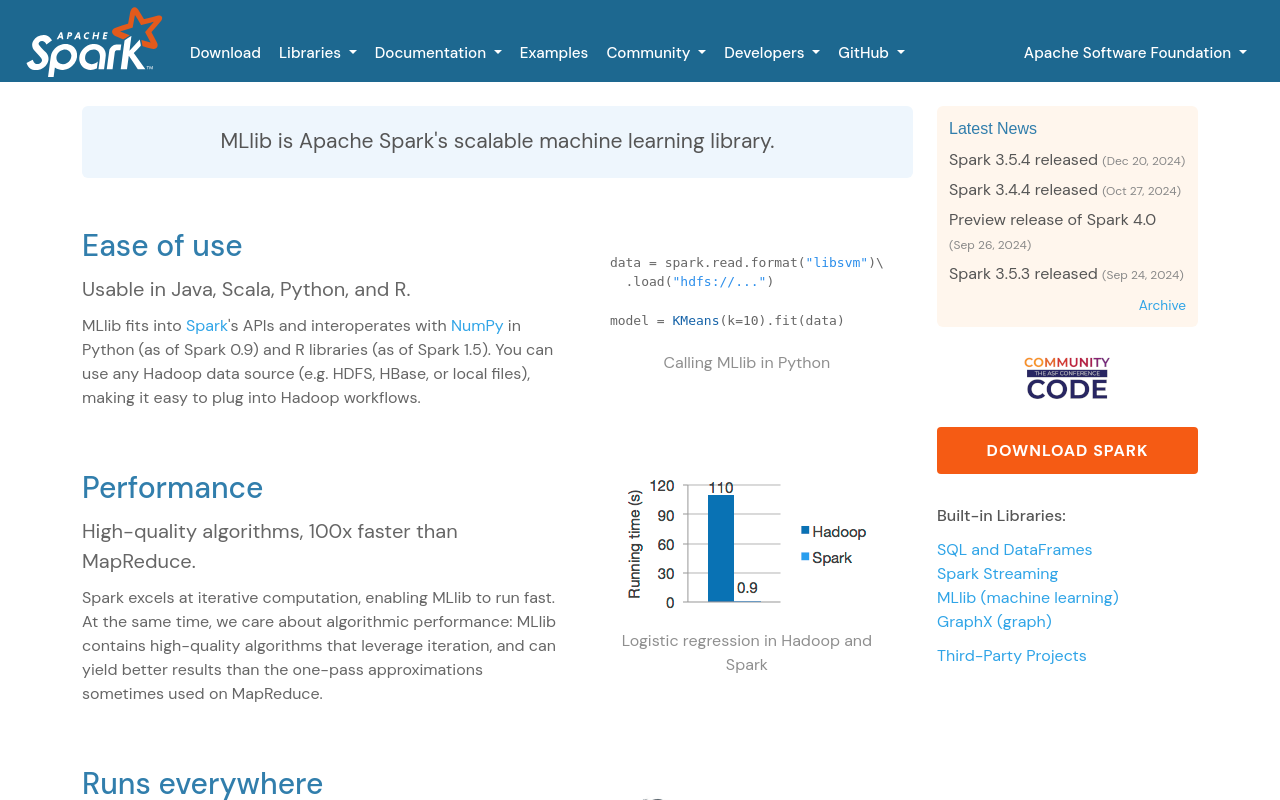
- 适用对象
- 大数据开发工程师 基于Spark链路做机器学习相关业务开发
- 主要功能
- 分布式算法支持、特征工程工具集
- 平台
- 网页
- 已收录
- 2026.10.18(12 天)
阅读目录
MLlib(ApacheSpark)是什么,怎么使用?
约 4 分钟MLlib(ApacheSpark),MLlib是 Apache Spark 的可扩展机器学习库
MLlib是Apache Spark生态下的可扩展机器学习库,面向分布式数据处理场景下的机器学习需求而生。不少开发者处理TB级以上的大规模数据集时,常规单机机器学习工具会出现内存不足、运算耗时过长的问题,MLlib依托Spark的分布式计算架构,把机器学习的各类运算拆解为可并行执行的任务,开发者可以沿用Spark通用的作业调度逻辑,不用额外适配复杂的分布式底层框架,就能在集群上跑通机器学习相关流程。
它覆盖了常用的机器学习算法、特征工程工具、模型评估模块等基础能力,适配Spark支持的各类分布式数据源。如果你的日常工作已经基于Spark做大数据处理,需要在现有数据处理链路里加入机器学习相关环节,优先选它可以减少额外的框架适配成本。如果你的数据集规模很小,用单机机器学习库就能完全承载,它的分布式特性反而不会体现出明显优势。
主要功能
- 分布式算法支持:提供分类、回归、聚类等常用机器学习算法,可在多节点集群并行运行,适配大规模数据集运算需求
- 特征工程工具集:内置标准化、特征提取、特征选择等常用处理工具,可直接对接Spark的分布式数据格式
- 模型评估模块:自带多类通用的模型效果校验指标,支持在分布式场景下完成模型性能的批量测算
- 开发接口兼容:提供多语言调用接口,熟悉Spark常规开发语法的用户可快速上手编写相关逻辑
怎么使用
- 打开浏览器输入MLlib官方网址,查看对应Spark版本的配套安装指引文档
- 根据自身使用的开发环境,配置对应依赖包,完成库文件的引入操作
- 基于已有的Spark作业逻辑,调用MLlib提供的对应API,编写机器学习流程代码
- 提交Spark集群作业,运行编写好的代码,查看运算输出结果与模型相关产出
- 参照官方文档的示例调整参数,优化模型效果,最终导出符合需求的可用模型
适合什么人群
- 大数据开发工程师 基于Spark链路做机器学习相关业务开发
- 算法工程师 处理超大规模数据集的分布式模型训练
- 数据分析师 在现有大数据处理流程中加入预测类分析环节
- 高校相关方向研究者 基于分布式框架做机器学习相关实验
用 MLlib(ApacheSpark) 做大规模用户行为数据聚类分析
从Apache Spark官方文档导航栏找到MLlib模块入口,跳转至对应代码示例与运行环境指引页面,先导入已上传至Spark分布式存储系统的用户行为数据集,调用MLlib内置的K-Means聚类算子配置聚类簇数、迭代次数参数,提交分布式运算任务。运算完成后可直接输出标注好聚类类别的结构化结果表,支持直接导出为CSV格式或对接后续可视化组件生成用户分群看板。
用 MLlib(ApacheSpark) 做海量日志数据异常行为检测
在已部署的Spark集群中引入MLlib依赖包,加载清洗完成的全量服务器日志特征数据集,选用内置的孤立森林算法组件配置异常比例、采样数参数,启动分布式训练流程。训练完成后可批量标记日志流中的异常访问、异常操作记录,输出带异常置信度分值的全量日志标注结果。
开始使用 MLlib(ApacheSpark)
打开官网https://spark.apache.org/mllib,在页面顶部导航栏找到下载入口,获取对应版本的Spark安装包,完成集群环境配置后即可调用MLlib所有组件,无需单独注册账号。平台未标注定价相关内容,所有使用涉及的费用规则以官网公示为准。
首次上手可先从官网提供的小型公开样例数据集入手,跟着官方给出的代码片段逐行运行验证效果,熟悉分布式机器学习任务的提交逻辑后,再对接自有业务数据集开展运算,所有参数配置细节可查阅官网对应版本的API说明文档。
优点与不足
优点
- 依托Spark生态,可直接对接现有大数据处理流程的各类数据源
- 支持多节点并行运算,能承载常规单机工具跑不动的大规模数据集
- 开源协议宽松,商用场景下使用不会产生额外的版权相关成本
不足
- 依赖Spark环境运行,单独部署使用需要额外配置整套分布式集群
- 仅覆盖通用机器学习能力,不提供深度学习相关的预训练模型支持
能帮你做的 7 件事
- 01分布式算法支持
- 02特征工程工具集
- 03模型评估模块
- 04开发接口兼容
- 05开发框架场景的常用方案
- 06大数据开发工程师 基于Spark链路做机器学习相的日常效率工具
- 07在网页等多端直接使用
更新历史
- MLlib(ApacheSpark) 收录进 Toolifai 目录
- 页面资料核验与信息更新
常见问题
没有Spark使用基础容易上手吗
有一定门槛。它的运行逻辑完全依托Spark生态,你需要先掌握Spark基础开发语法,才能顺利调用MLlib的各类功能,完全没有Spark使用经验的用户,需要先补充相关前置知识再使用。
使用MLlib需要支付费用吗
无需额外付费。它属于Apache Spark开源生态下的组件,本身完全开源免费,相关使用规则与配套服务说明,全部以官网公示的最新内容为准。
训练数据的隐私安全有保障吗
数据全程在你自己部署的Spark集群内流转,不会上传至第三方服务器,你可以自主管控所有训练数据的存储与运算权限,数据安全规则可自行在集群层面配置。
小数据集场景选它合适吗
不合适。它的设计目标是适配大规模分布式数据集,小数据集场景下它的分布式调度开销反而会拖慢运算速度,用常规单机机器学习库效率更高。
开始使用 MLlib(ApacheSpark)
从官方入口了解最新功能与使用方式。
由 Toolifai 编辑维护
欢迎产品方补充截图、功能介绍与官方资料。更新和纠错由编辑审核后发布。


