Webᵀ Crawl by Web Transpose
将网站内容高效转化为适用于大型语言模型(LLM)的数据集
将网站内容高效转化为适用于大型语言模型(LLM)的数据集,提供精准、高质量的数据处理服务。
- 适用对象
- 大模型训练工程师 批量获取公开网页训练素材
- 主要功能
- 网页内容定向爬取、LLM适配格式转换
- 已收录
- 2026.10.18(21 天)
阅读目录
编辑评测与站内热度
全站热度排名
待评估
分类内排名
待评估
累计站内点击
3
近 7 日点击
1
排名与点击为站内真实统计口径,反映 Toolifai 用户行为,非编辑评分。
Webᵀ Crawl by Web Transpose是什么,怎么使用?
约 7 分钟Webᵀ Crawl by Web Transpose,将网站内容高效转化为适用于大型语言模型(LLM)的数据集,提供精准、高质量的数据处理服务。
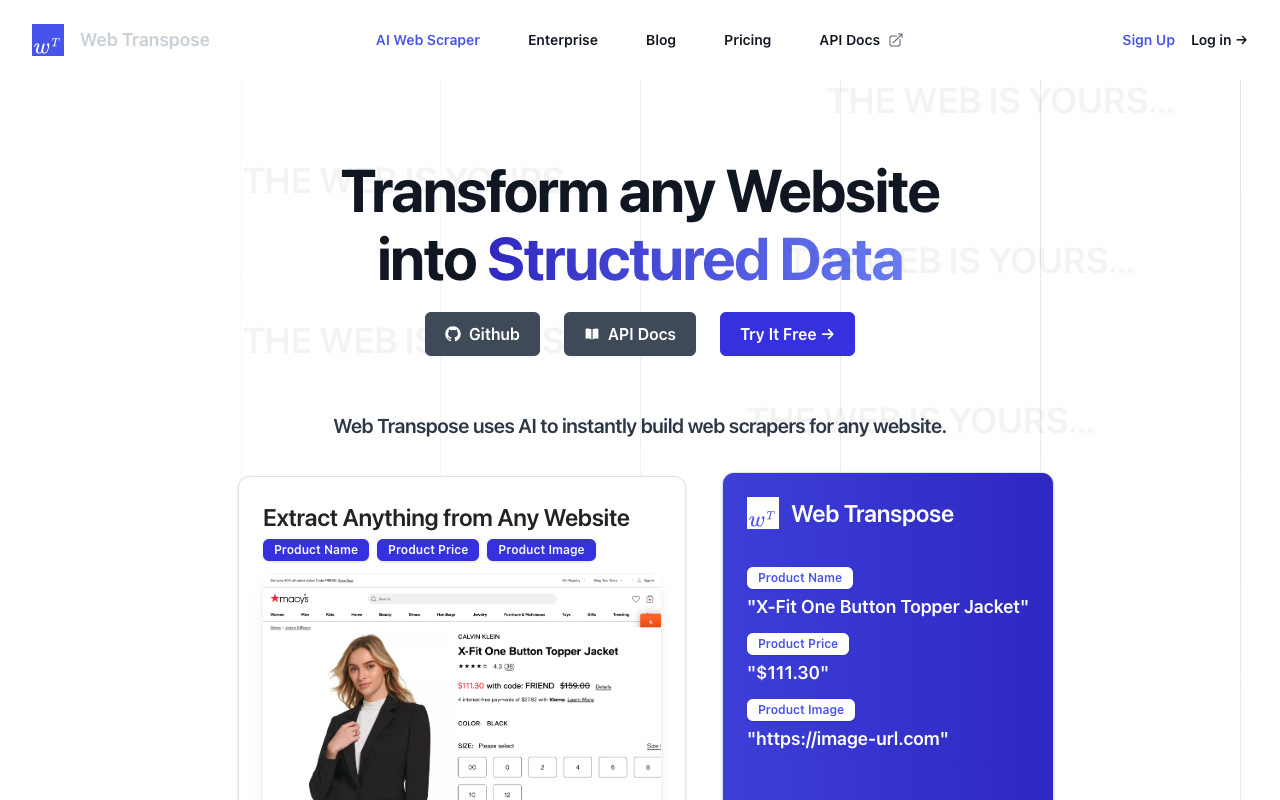
Webᵀ Crawl by Web Transpose是面向LLM训练场景的专用AI网络爬虫工具,核心解决普通爬虫抓取的网页内容格式杂乱、冗余信息多,无法直接喂给大模型做训练数据集的痛点。它不需要用户手动清洗页面里的广告、导航栏、弹窗等无关元素,可直接将抓取到的原始网页内容做定向规整,输出适配大模型输入要求的结构化内容,省去大量人工整理网页素材的重复劳动。
它的能力边界集中在网页内容到LLM可用数据集的转化环节,不额外提供爬虫规则自定义、深度嵌套站点批量爬取等拓展功能。如果你正在搭建领域专属的问答大模型,需要批量获取垂直站点的公开内容做训练素材,不想在内容清洗环节耗费过多人力,这款工具的适配性会比通用爬虫高很多。
主要功能
- 网页内容定向爬取:可批量抓取指定站点的公开有效内容,过滤页面无关冗余元素,直接输出规整的原始素材
- LLM适配格式转换:将爬取得到的网页内容做结构化调整,输出符合大模型输入规范的数据集格式,减少后续调整成本
- 高质量数据校验:对转换后的数据集做基础合规校验,剔除不符合LLM训练要求的无效片段,保障输出内容可用度
- 轻量网页端操作:无需本地部署复杂爬虫环境,打开浏览器即可完成全流程操作,降低工具使用的硬件门槛
怎么使用
- 打开浏览器,输入Web Transpose官方网址进入工具对应的Webᵀ Crawl操作页面
- 在操作界面的输入框中,填写需要爬取的目标站点地址,确认爬取范围相关参数
- 提交爬取任务,等待系统自动完成网页内容抓取、冗余信息过滤与格式转换全流程
- 任务处理完成后,在结果页查看生成的适配LLM的数据集,按需导出对应内容即可
适合什么人群
- 大模型训练工程师 批量获取公开网页训练素材
- 垂直领域AI问答开发者 搭建知识库专用数据集
- AI数据标注从业者 减少网页内容清洗重复劳动
- 独立LLM爱好者 低成本制作小体量训练数据集
Webᵀ Crawl by Web Transpose 是什么
Webᵀ Crawl by Web Transpose 是一款面向LLM开发场景的AI网络爬虫工具,运行于Web端,核心作用是将公开网站的内容转化为适配大语言模型训练、微调或推理调用的结构化数据集。官方介绍中,该工具将自身定位为衔接公开网页内容与LLM数据需求的中间处理服务,不需要用户手动编写爬虫规则即可完成全链路内容采集与标准化转换。
它解决了普通通用爬虫输出内容杂乱、存在大量无关噪声,后续需要投入大量人力清洗才能适配LLM输入格式的痛点。普通爬虫采集的网页内容往往混杂导航栏、广告、页脚等冗余元素,直接导入LLM会占用token配额、干扰模型输出准确性,Webᵀ Crawl by Web Transpose的核心设计目标就是跳过冗余人工清洗环节,直接输出符合LLM使用标准的高质量数据。
核心能力
定向网页内容精准提取能力,运行时仅针对用户指定的目标站点范围做内容扫描,自动识别网页中的正文文本、结构化列表、表格等有效信息块,过滤掉页面内嵌的广告、侧边栏导航、重复页脚、弹窗提示等无关元素。该能力依赖用户提前划定的爬取域名范围与内容筛选规则,使用时不需要用户手动标注每个页面的有效内容区块,输出的内容纯净度远高于普通爬虫的原始抓取结果。该能力的边界在于,对于做了强反爬验证、需要登录才能访问的非公开页面,默认配置下无法完成内容提取,相关特殊场景的适配规则以官网公示的功能说明为准。
LLM适配格式自动转换能力,抓取到的纯净网页内容不会直接以原始HTML或纯文本形式输出,工具会按照LLM训练、微调阶段常用的数据集规范,自动完成内容分段、元数据挂载、格式对齐处理。用户不需要额外编写格式转换脚本,拿到的结果可直接导入主流LLM训练框架使用。该能力的边界在于,暂不支持自定义小众LLM框架的专属数据集格式,预设的输出格式列表可在官网帮助中心查询。
批量站点并行爬取调度能力,支持用户同时提交多个目标站点的爬取任务,工具内置的调度机制会自动调整请求频率,避免短时间内大量请求对目标站点造成访问压力,也能降低触发站点反爬机制的概率。用户不需要手动配置请求间隔、代理池等参数,任务提交后可在后台查看实时爬取进度。该能力的边界在于,单批次可提交的最大站点数量、单站点最大爬取页面数以官网当前生效的服务规则为准。
工作方式
用户进入Web端操作界面后,第一步提交需要爬取的目标站点域名,划定是否包含子域名、是否限制特定路径的爬取范围,第二步设置内容过滤规则,指定需要保留或排除的内容类型,提交任务后工具自动启动爬取流程。任务运行过程中用户可随时查看已完成爬取的页面数量、有效内容占比、异常页面报错信息,不需要全程值守等待。
任务全部执行完成后,用户可直接预览生成的数据集样例,确认内容符合预期后直接导出文件。产出物为已完成去重、去噪、结构化标注的标准化数据集文件,附带每条内容对应的原始页面URL、采集时间戳等元数据字段,可直接用于后续LLM相关的数据处理流程。
典型场景与产出
垂直领域知识库构建场景,面向细分行业的LLM应用开发者,需要批量采集某类技术文档站点的全部公开教程内容,用于微调行业专属大模型。使用该工具提交目标文档站点域名后,可自动过滤掉文档页侧边的社区讨论区、顶部导航栏等无关内容,最终输出带章节标注的结构化问答数据集,省去手动整理上千份文档内容的重复劳动,对应产出的数据格式可直接接入微调流水线。
内容聚合类LLM插件开发场景,SaaS产品开发者需要对接多个资讯类站点的公开内容,为LLM插件提供实时参考信息源。使用该工具批量爬取指定站点的最新资讯内容,自动挂载每条资讯的发布时间、来源链接元数据,输出的结构化数据可直接同步到插件的向量数据库中,不需要额外做数据清洗处理。
适用边界
它不适合需要采集登录后非公开内容、涉及用户隐私数据的爬取任务,这类场景下工具没有内置账号权限模拟、验证码自动破解的相关功能,无法绕过站点的身份验证机制。对于需要自定义高度复杂爬虫逻辑、对接私有数据处理系统的技术团队,该工具的预设规则无法覆盖全部定制化需求,需要搭配自行开发的爬虫组件使用。
该工具的所有服务均通过Web端提供,没有本地部署版本,所有爬取任务的执行过程均在服务商云端完成,涉及高敏感数据的采集任务不建议直接使用。工具当前无公开定价标注,具体服务对应的收费标准、数据存储周期、隐私保护规则,可在官网定价页与隐私政策页面查询,提交付费任务前建议先查阅对应条款确认符合自身数据安全要求。
编辑点评
Webᵀ Crawl by Web Transpose精准击中了LLM开发流程中网页数据处理的核心痛点,跳过了普通爬虫到LLM数据集之间多步人工清洗的环节,降低了非专业爬虫开发人员获取高质量训练数据的门槛。短板在于功能灵活性不如自定义开发的爬虫框架,特殊反爬场景、高度定制化的数据处理需求无法通过现有配置完成。本内容基于官方公开材料整理,功能与价格以官网为准。
优点与不足
优点
- 输出内容直接适配LLM训练要求,无需额外做大量格式调整
- 全流程在网页端完成,不需要用户本地部署爬虫运行环境
- 定向过滤网页冗余元素,减少人工清洗网页内容的工作量
不足
- 暂未标注公开定价,使用前需到官网查询对应收费规则
- 无自定义爬虫规则功能,复杂站点爬取灵活度不足
- 仅支持网页端访问,没有本地客户端可离线使用
能帮你做的 6 件事
- 01网页内容定向爬取
- 02LLM适配格式转换
- 03高质量数据校验
- 04轻量网页端操作
- 05聊天问答场景的常用方案
- 06大模型训练工程师 批量获取公开网页训练素材的日常效率工具
更新历史
- Webᵀ Crawl by Web Transpose 收录进 Toolifai 目录
- 页面资料核验与信息更新
常见问题
没有爬虫使用经验能快速上手吗
可以,这款工具的核心操作集中在填写目标站点地址,不需要用户编写复杂的爬虫规则,操作路径短。具体操作指引可查看官网帮助中心的图文说明,新手按照指引走完全流程即可完成基础任务。
使用这款工具的费用是多少
该工具当前定价未做公开标注,不同的爬取任务量级对应不同的收费规则,具体费用明细以官网公示的定价页面信息为准,提交大额爬取任务前建议先确认对应收费标准。
爬取得到的数据隐私怎么保障
工具默认仅处理用户指定的公开网页内容,不会私自留存爬取得到的站点原始数据,相关数据处理规则可查阅官网隐私政策页面,涉及敏感站点的爬取建议提前做好合规校验。
能爬取需要登录的私有站点内容吗
不能,这款工具的定位是处理公开网页内容的转化,暂不支持需要身份验证的非公开站点爬取。有这类需求的用户可到官网功能更新公告页查看后续的功能迭代计划。
开始使用 Webᵀ Crawl by Web Transpose
从官方入口了解最新功能与使用方式。
由 Toolifai 编辑维护
欢迎产品方补充截图、功能介绍与官方资料。更新和纠错由编辑审核后发布。