

GLEE
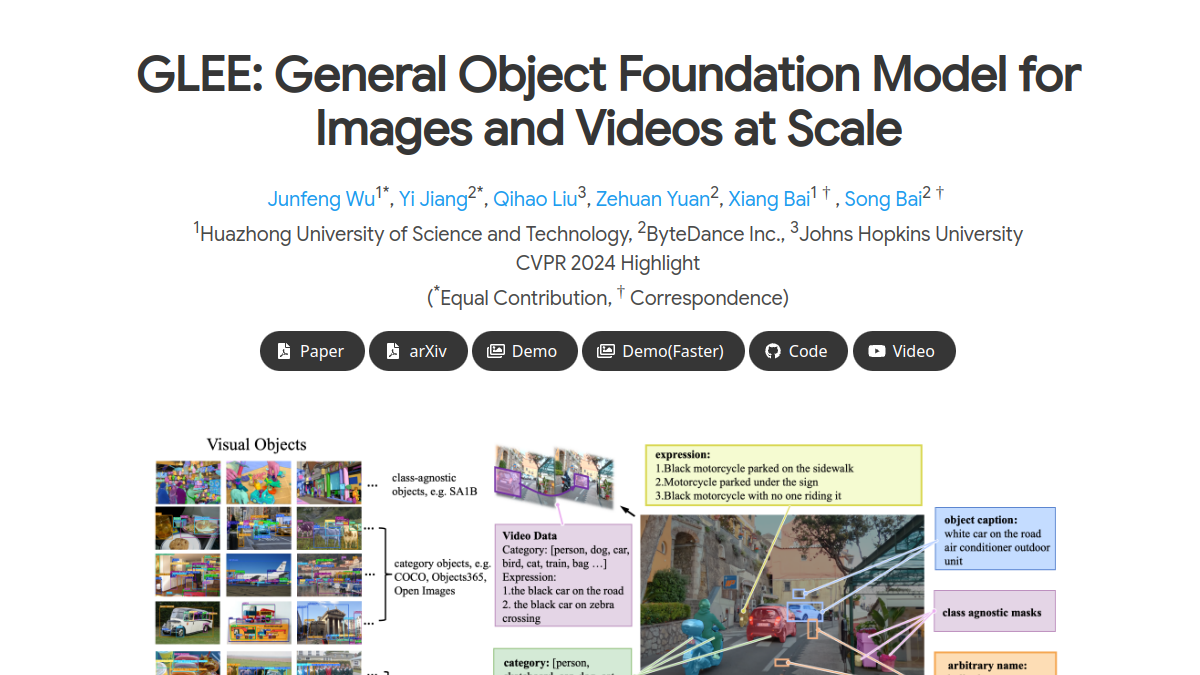
GLEE是一个面向图像与视频处理场景的通用对象基础模型服务平台,核心定位是为各类对象感知任务提供统一的技术支持。平台可实现多模态输入的对象定位与识别功能,支持零样本迁移适配不同任务场景,还具备多数据源联合训练的通用对象表示能力。目标用户覆盖计算机视觉领域的科研人员、AI应用开发工程师、内容生产行业的视频处理从业者、安防领域的智能分析从业者等,可应用于视频内容结构化标注、图像对象检测、多场景智能识别、零样本任务迁移等多种场景。

ToastyRoast
ToastyRoast是一款基于人工智能的趣味图片评分网站,核心定位是为用户提供带有调侃风格的人像图片分析服务。平台支持人像照片上传分析,可基于外貌特征给出差异化的趣味评价,同时支持评价结果一键分享到社交平台。目标用户覆盖年轻社交用户、内容创作者、休闲娱乐群体等,适用于朋友聚会互动、社交账号内容创作、日常休闲解压等多个场景,满足用户趣味互动与内容产出的需求。
How normal am I?
How normal am I是一个由Tijmen Schep开发、欧盟支持的艺术实验项目,核心围绕面部检测算法展开对“正常度”的量化探索。项目主打零数据收集的隐私保障机制,用户可自主体验算法对面部特征的评判过程,也可选择匿名提交数据参与项目研究。该项目面向对算法伦理、人脸识别技术感兴趣的群体,适用于技术伦理研究、人工智能科普展示、数字艺术体验等多个场景,帮助用户直观感知算法判断体系的运作逻辑与潜在偏向。
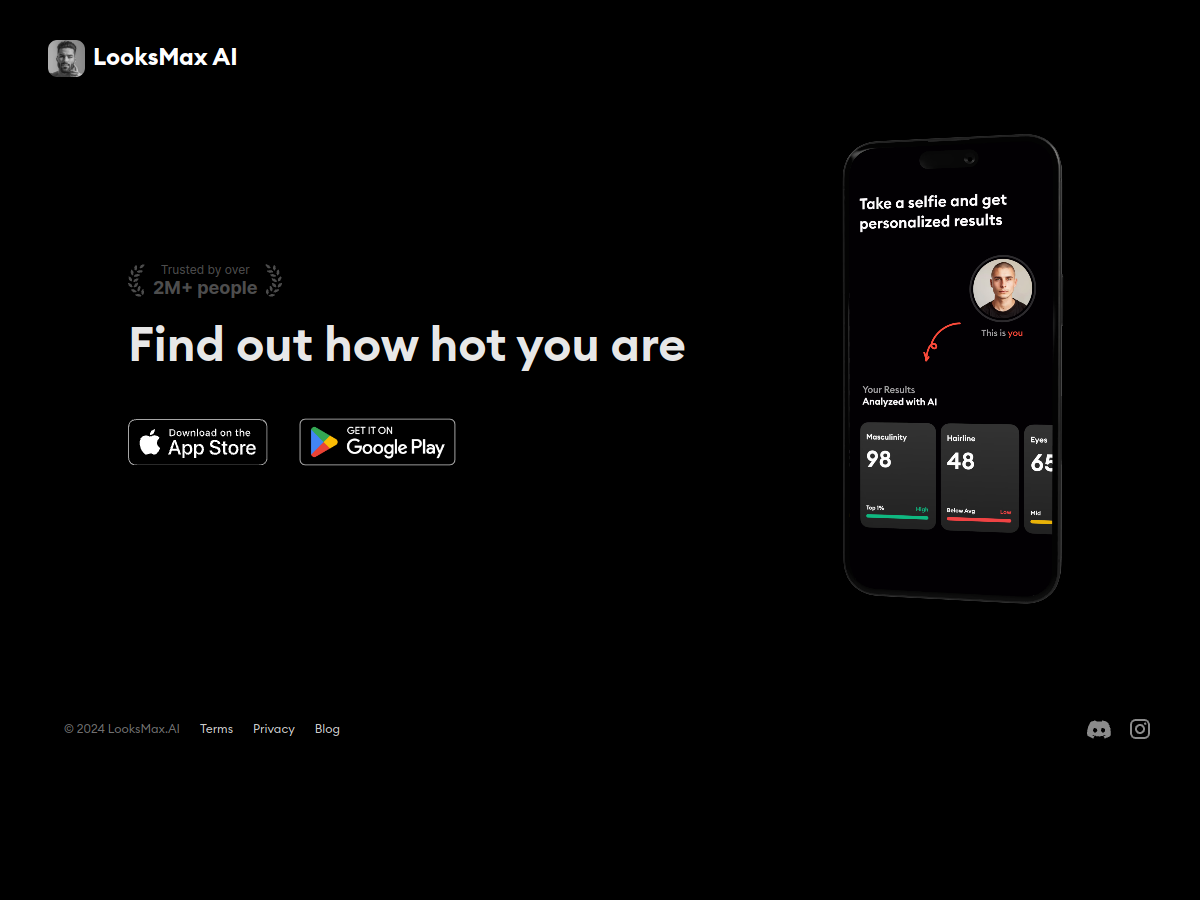
LooksMax AI
LooksMax AI是专注于外貌魅力提升的AI服务平台,以人工智能技术为基础为用户提供外貌相关的分析与优化参考方案。核心功能包括面部特征量化分析、身体形象评估、个性化风格改造建议,同时搭建了同好交流社区,方便用户分享提升经验。平台主要面向有外貌提升需求的用户,可应用于日常形象管理、重要场合造型准备、长期外貌提升规划等多种场景,帮助用户获得更清晰的自我形象认知,找到适合自身的魅力提升方向。
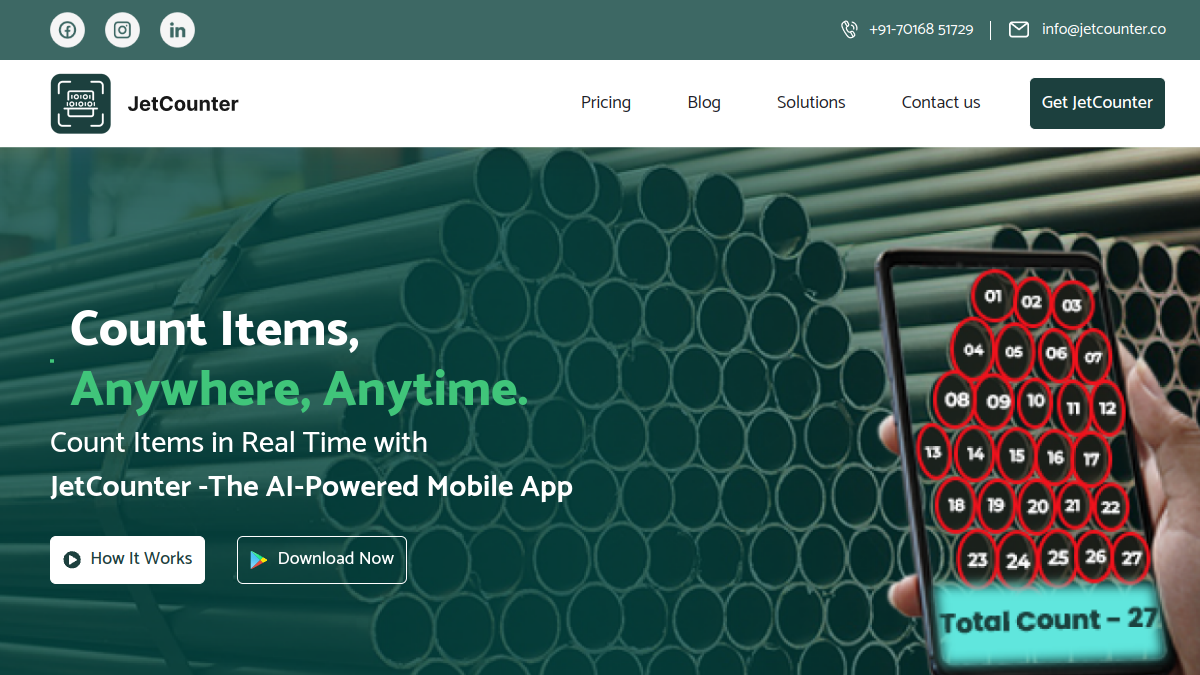
Jetcounter
Jetcounter是一款基于人工智能的物体计数工具,核心定位是通过图像识别技术帮助用户完成各类物品的自动化统计工作。其核心功能包括内置多场景物体计数模板、自定义模板训练、批量图片计数处理,可识别工业零件、医疗耗材、食品原材料等多种类别的物品。目标用户覆盖制造业库存管理人员、医疗物资统计人员、餐饮行业仓管人员、零售商户等,适用于日常库存盘点、货物出入库统计、生产流水线计件、医疗物资清点、食品原料批次统计等场景,能够降低人工计数的出错概率,提升统计工作效率。

Airparser
Airparser是基于GPT技术的自动化数据提取工具,核心定位是帮助用户从非结构化文档中高效获取标准化结构化数据。核心功能包括:支持多类型文档OCR识别与数据提取,可对接6000+第三方应用实现数据流转,支持多格式结构化数据导出。目标用户覆盖企业行政、财务、市场、法务、运营及独立开发者等群体,适用于发票信息录入、客户邮件线索整理、合同关键信息提取、纸质档案数字化、手写笔记信息归集等场景,能够降低人工数据录入的重复工作量,提升数据处理的准确性与效率。
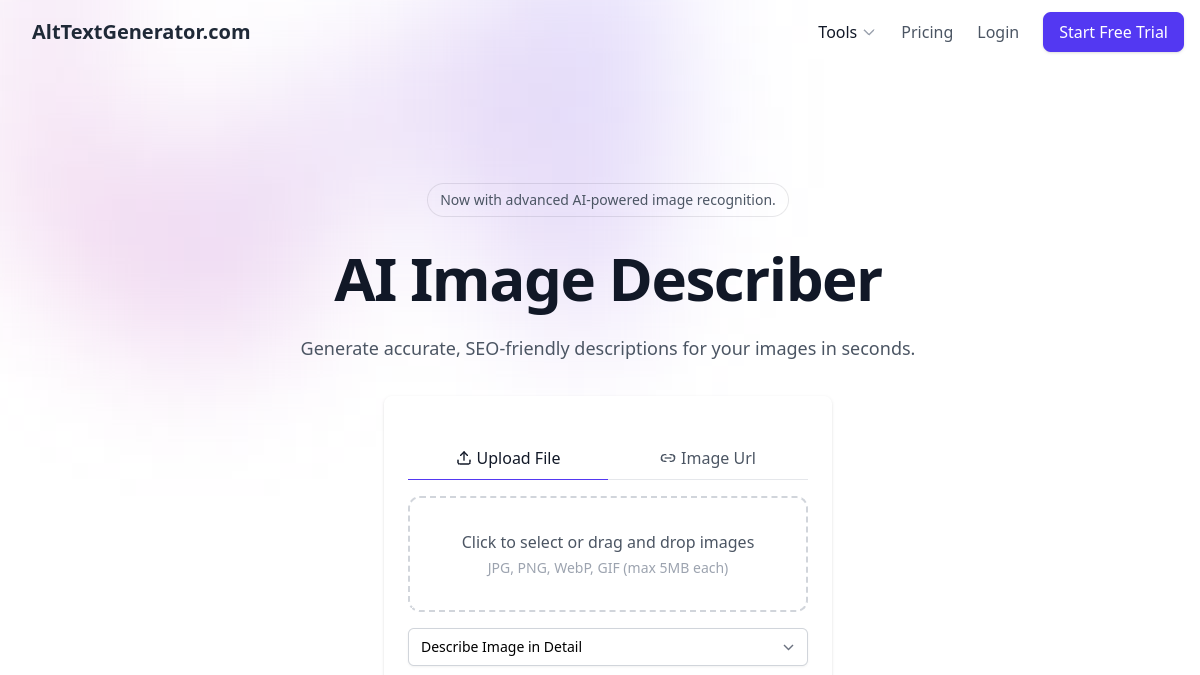
AI Describe Pictures
AI Describe Pictures是基于人工智能大模型打造的图片内容识别与描述生成平台,核心定位是为各类用户提供高效的图片文字转写服务。平台支持多场景图片识别,可生成不同风格的描述文本,同时支持中文等多语言输出。目标用户涵盖视觉障碍群体、内容创作者、电商运营人员、教育工作者等,可应用于无障碍信息适配、内容素材整理、商品详情撰写、教学资料制作等多种场景,帮助用户降低图片信息提取的人工成本,提升文本产出效率。

即刻动态开盒Bot
即刻动态开盒Bot是一款基于AI技术的社交媒体内容分析工具,核心定位是为即刻平台用户提供动态内容的趣味解析服务。其核心功能包括即刻动态截图内容识别、用户兴趣标签生成、社交行为特征总结,能够对上传的动态截图中的文字、图像元素进行多维度分析,输出贴合内容的个性标签和行为特征总结。目标用户覆盖即刻平台普通用户、内容创作者、社交互动爱好者等群体,可用于日常社交互动、个人兴趣梳理、好友趣味互动等多个场景,为社交媒体使用过程增添互动乐趣。

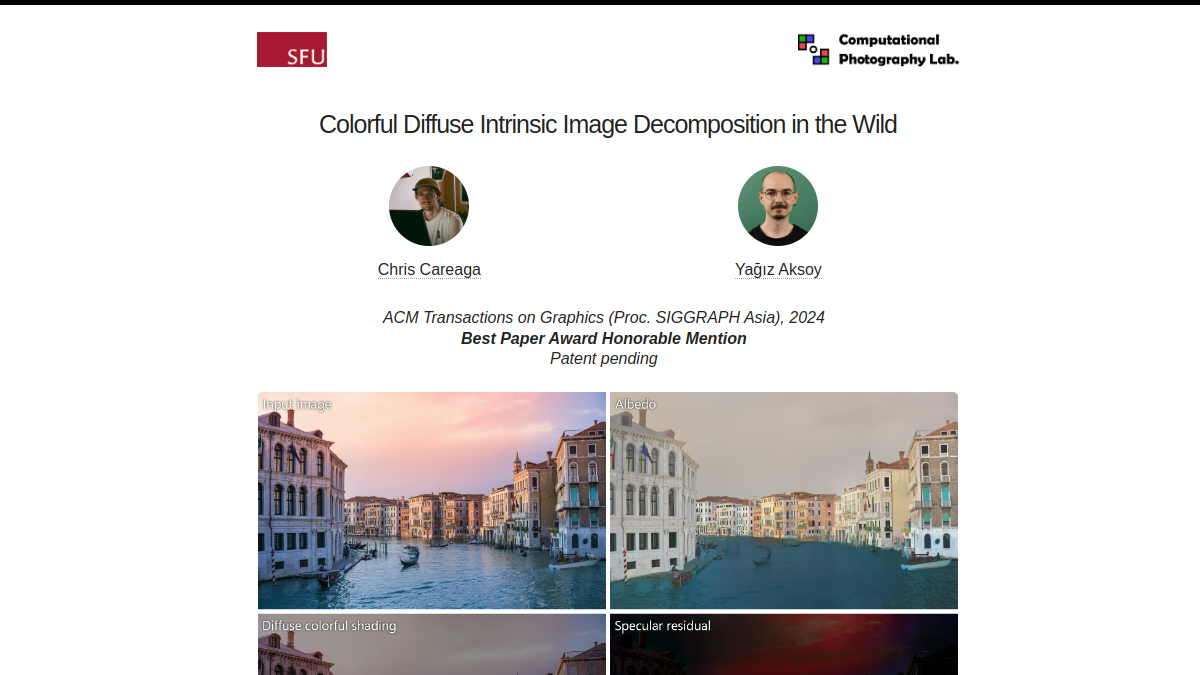
Colorful Diffuse Intrinsic Image Decomposition
Colorful Diffuse Intrinsic Image Decomposition 是专注于固有图像分解的在线技术演示平台,核心定位是为图像处理领域提供高精度的自然场景图像成分拆分服务。平台支持将野外实拍照片分解为反照率、漫反射阴影、非漫反射残留三类独立成分,可适配多光源、存在二次反射的复杂场景,同时能识别并分离镜面反射与可见光源。该平台面向计算机视觉研究者、数字图像编辑从业者、高校图形学相关专业师生等群体,可应用于图像去反光、像素级白平衡调整、场景光照重建、老照片修复等多个工作场景,为图像处理相关工作提供底层技术支撑。

Hasty
Hasty是面向计算机视觉领域的一站式视觉AI开发平台,核心定位是帮助用户从原始图像、视频素材出发,快速完成数据处理到生产级模型部署的全流程工作。平台支持AI辅助自动化标注,能自动识别图像中的常见目标并生成标注框,大幅降低手动标注的工作量;内置智能质量校验功能,可自动检测标注错误、标注缺失等问题,减少人工审核的重复劳动;还提供端到端模型训练能力,无需复杂的MLops配置即可完成模型迭代优化。目标用户覆盖计算机视觉算法开发人员、数据标注团队、AI项目产品经理等,可应用于自动驾驶图像数据集构建、工业缺陷检测模型开发、安防视频分析系统搭建等多个场景,降低视觉AI项目的落地门槛。
Face++旷视
Face++旷视是人工智能开放服务平台,面向开发者、企业客户提供计算机视觉相关的AI技术服务。平台核心功能包含人脸识别、人像处理、文字识别三大类能力,支持公有云API、离线SDK等多种接入方式,能够满足不同开发环境下的集成需求。目标用户覆盖应用开发者、企业技术团队、智能硬件厂商等群体,可用于身份核验场景、智能安防项目、内容审核系统搭建、移动端智能功能开发等多种业务场景,帮助用户降低AI技术研发成本,缩短相关功能的落地周期。

Gemini Pro Vision Invoice Reader
Gemini Pro Vision Invoice Reader是一款基于Google Gemini Pro Vision大模型开发的发票识别处理工具,核心定位为帮助用户高效完成发票信息提取与结构化整理。其核心功能包括多语言发票OCR识别、发票关键信息自动提取、识别结果多格式导出,可满足不同用户的发票处理需求。该工具面向企业财务人员、个体经营者、行政采购人员、自由职业者等群体,适用于日常报销整理、企业账务录入、跨境贸易发票处理、个人消费凭证归档等场景,无需下载安装,通过网页端即可完成全流程操作。
GenSAM
GenSAM是面向迷彩目标分割领域的技术演示与工具站点,核心定位是为相关领域研究与开发人员提供无需额外训练的迷彩目标分割方案。站点支持用户上传含迷彩伪装目标的图像,通过跨模态思维链提示技术提取视觉特征,配合渐进式掩膜生成模块输出精准的目标分割结果。目标用户覆盖计算机视觉研究人员、军事伪装检测开发人员、野生动物监测从业者等群体,可应用于迷彩伪装效果评估、野外隐藏目标识别、遥感图像目标提取等多种场景。
DOConvert
DOConvert是专注于企业级智能文档处理的服务平台,核心定位是帮助企业降低文档数据处理的人力成本,提升流程运转效率。平台支持多类型文档数据自动提取、主流ERP系统无缝对接、定制化实施部署三大核心功能,面向企业行政、财务、供应链、IT运维等多个岗位的工作人员,可应用于发票信息录入、采购订单处理、客户合同归档、业务数据同步等多种办公场景,帮助企业减少人工录入产生的错误,优化文档流转全链路流程。
Lexy
Lexy是一款基于AI技术的在线图像文字提取工具,核心定位是为用户提供便捷的图像文字识别与提取服务,无需复杂配置即可完成OCR识别需求。核心功能包括多格式图片文字提取、手写字体识别、多语言文字识别三大类,支持用户快速将图片中的文字内容转化为可编辑的文本格式。目标用户覆盖学生、职场人士、内容创作者、行政人员、自由职业者、小微企业运营者等群体,适用于课件文字转录、合同信息提取、手写笔记电子化、外文资料翻译、纸质文档归档等多种日常及工作场景,有效降低手动录入文字的时间成本。
Photor AI
Photor AI是基于图像识别与机器学习技术打造的智能照片筛选与分析工具,核心定位是为用户提供高效的照片质量评估与优化辅助服务。其核心功能包括AI照片打分、自动筛选优质照片、AI生成摄影标题,可识别照片中的主体元素、构图表现与情感氛围,帮助用户快速从大量照片中挑出合适的内容。该工具面向摄影爱好者、内容创作者、电商运营者、职场人士、普通个人用户等群体,可应用于旅行照片整理、作品集筛选、商业产品图挑选、社交平台内容准备、活动照片归档等多个场景,降低人工筛选照片的时间成本,提升照片选择的效率。

Revisit Anything
Revisit Anything 是基于视觉位置识别技术搭建的图像检索系统,核心定位是实现跨图像的位置匹配与识别。核心功能包括图像片段位置检索、SAM与DINO技术融合识别、多场景视觉特征比对。目标用户覆盖计算机视觉研究人员、机器人开发从业者、自动驾驶技术测试人员、空间测绘工程师等。适用于机器人自主导航场景的位置重定位、自动驾驶车载视觉的场景匹配、多视角图像的相同位置识别、视觉SLAM系统的闭环检测等工作场景,能够帮助用户快速完成不同图像中相同位置的匹配验证,提升视觉识别相关项目的研发效率。

Imagga
Imagga是专注于计算机视觉领域的图像识别API服务平台,核心为开发者、企业提供可集成的图像分析能力。核心功能包括图像内容标签生成、智能分类、颜色信息提取,同时支持内容审核、智能裁剪、视觉搜索等扩展能力。目标用户覆盖互联网产品开发者、电商平台运营方、内容社区管理者、数字资产管理团队等,可应用于图片库标签标注、电商商品自动分类、UGC内容合规审核、智能相册分类等多种业务场景,帮助使用者降低图像内容处理的人工成本,提升内容管理效率。


Parseflow
Parseflow是专注于文档数据结构化提取的自动化平台,依托OCR与AI技术帮助用户完成非结构化文档的数据自动识别、整理与输出。核心功能包括多类型文档数据提取、多语言识别支持、第三方应用生态集成,目标用户覆盖企业财务、行政、人力资源、法务等多个部门人员,可应用于发票批量录入、合同关键信息归档、简历数据筛选、电子邮件信息汇总等多个日常办公场景,降低手动数据录入的人力投入,减少人为录入误差。
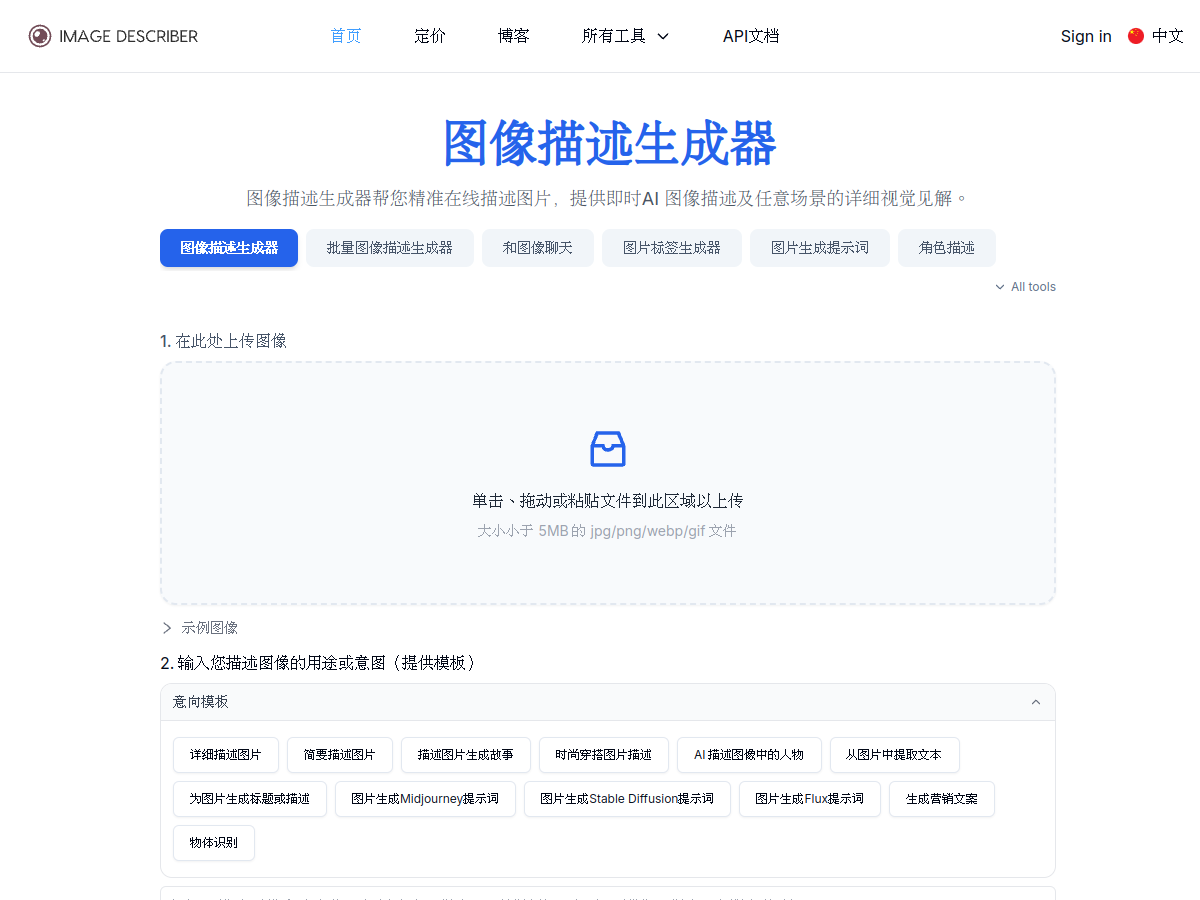
Image Describer
Image Describer是一款基于人工智能技术的图像描述生成工具,核心定位是为用户提供自动化的图像内容解析与文本生成服务。其核心功能包括本地图片上传解析、自定义描述风格调整、多语言描述内容输出,可根据用户输入的提示词生成符合特定场景需求的描述内容。工具面向内容创作者、电商运营人员、视障群体、教育工作者、新媒体从业者等用户群体,可适用于社交媒体配图配文、商品详情页素材描述、视障用户图片内容感知、课件配图说明撰写等多种场景,帮助用户降低人工撰写图片描述的成本,提升图像内容的传播可及性。