

Datalab.to
Datalab.to是专注于文档智能处理的开源AI工具平台,核心定位是为开发者、企业及相关从业者提供高性能的文档处理AI模型服务。平台核心功能包括高精度OCR识别、文档布局智能分析、PDF格式转Markdown导出,支持批量处理多类型文档文件。目标用户覆盖学术研究人员、企业办公人员、内容运营人员、前端开发人员、数据处理工程师等,可应用于学术文献批量整理、企业合同数字化归档、扫描文档内容提取、旧文档格式转换等多个场景,帮助用户降低文档处理的人力投入,提升内容流转效率。
llama-ocr
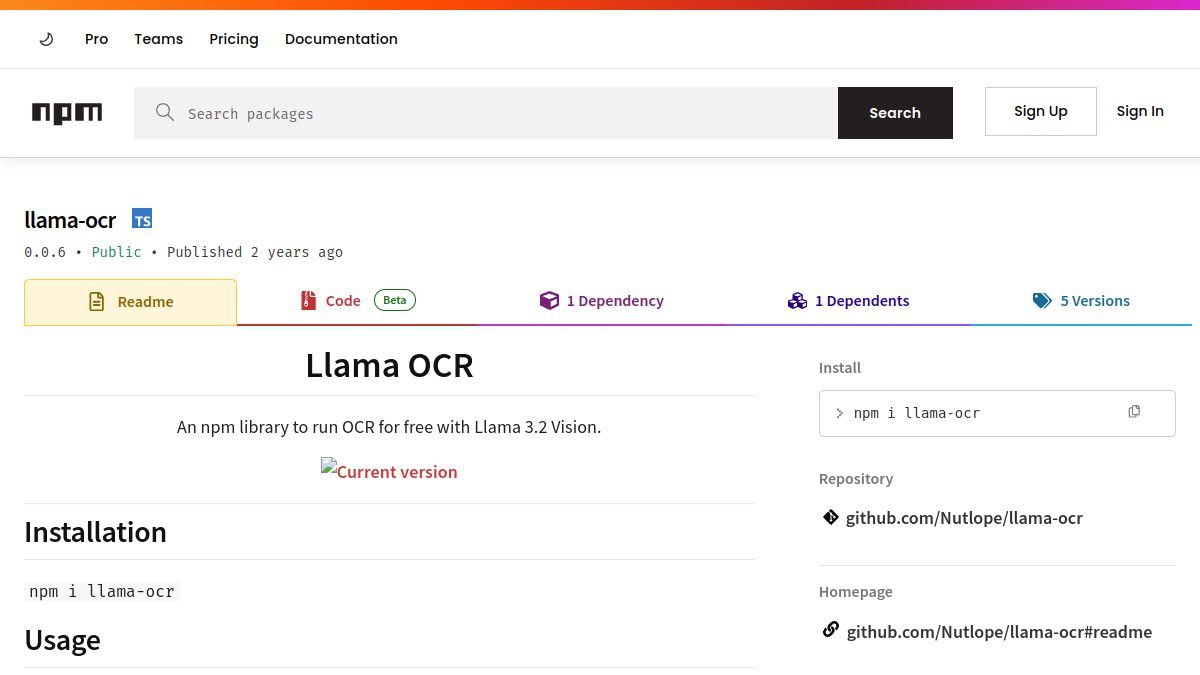
llama-ocr是一款开源npm库,核心定位为基于Llama 3.2 Vision模型的光学字符识别工具,可帮助开发者快速集成文本识别能力到项目中。核心功能包括支持本地与远程图像的OCR识别、提供免费与付费两种接口调用方案、后续规划支持PDF格式文件的内容提取,项目设计受Zerox启发,整体结构轻量化易集成。目标用户覆盖前端开发人员、Node.js后端开发者、小型工具开发团队等,可应用于文档数字化、图像内容转写、批量文本提取、小票信息录入等多种开发场景,降低OCR功能的接入门槛。
关于AI 文字识别
AI文字识别类工具依托光学字符识别与大语言模型融合技术,解决传统人工录入纸质文档、扫描件、图片类文字信息效率低、易出错的问题,典型使用场景涵盖办公文档数字化、票据证件信息提取、古籍手写内容转写、课堂板书素材整理等多个领域,可快速将非结构化的图文内容转换为可编辑的电子文本格式。
当前这类工具可分为通用型与垂直场景型两类,通用型工具支持常规印刷体图文、普通手写内容的基础识别,多数提供基础免费额度,超出额度后可按需选购不同档位的付费服务;垂直场景型工具针对票据、医疗单据、古籍等特定领域做了定向优化,识别准确率更高,大多采用按调用量或订阅制的付费模式,部分工具还额外提供识别后内容校对、格式还原、多语言翻译等延伸功能。
选型时可优先匹配自身核心使用场景,常规办公文档处理选择通用型工具即可满足需求,处理特定行业专属单据则优先选垂直优化的产品。日常低频轻度使用可先测试多款工具的免费额度,对比识别精度后再做选择。有批量大文件处理需求的用户,可优先支持批量导入、格式批量导出功能的产品,减少后续手动调整的工作量。
AI 文字识别常见问题
AI文字识别工具怎么选
先明确自身核心使用场景,常规办公选通用款,特定行业单据选垂直优化款,低频使用可先测试多款工具的免费额度对比精度后再确定。
AI文字识别工具免费还是收费
多数工具提供基础免费识别额度,超出额度后可选购不同档位付费服务,垂直场景定向优化的专业工具大多以付费订阅或按调用量计费为主。
AI文字识别工具适合谁用
适合办公人群处理文档数字化、财务人员提取票据信息、学生整理板书笔记、古籍爱好者转写手写旧资料等有图文转文本需求的各类用户。