

AnyV2V
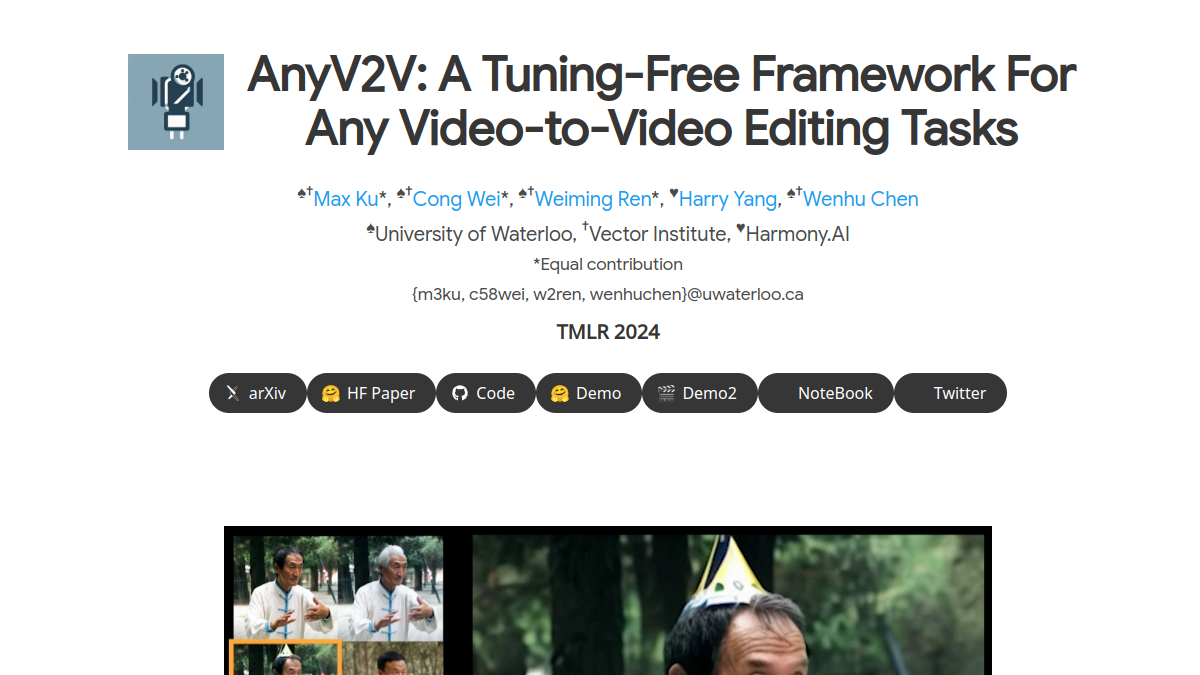
AnyV2V是由Tiger AI Lab推出的视频到视频编辑框架,核心定位为降低视频风格化与内容编辑的技术门槛,支持用户借助现有图像编辑工具完成视频首帧修改后,依托图像到视频生成模型重建完整编辑后视频。核心功能包括通用首帧编辑适配、多类型视频重建、多场景编辑任务支持,目标用户覆盖视频创作者、设计从业者、AI内容研发人员、新媒体运营人员等,可应用于短视频风格化改造、影视样片内容调整、创意动画生成、AI内容实验等多个场景,无需用户掌握复杂的视频生成模型微调技术即可完成个性化视频编辑需求。
万兴喵影 2023
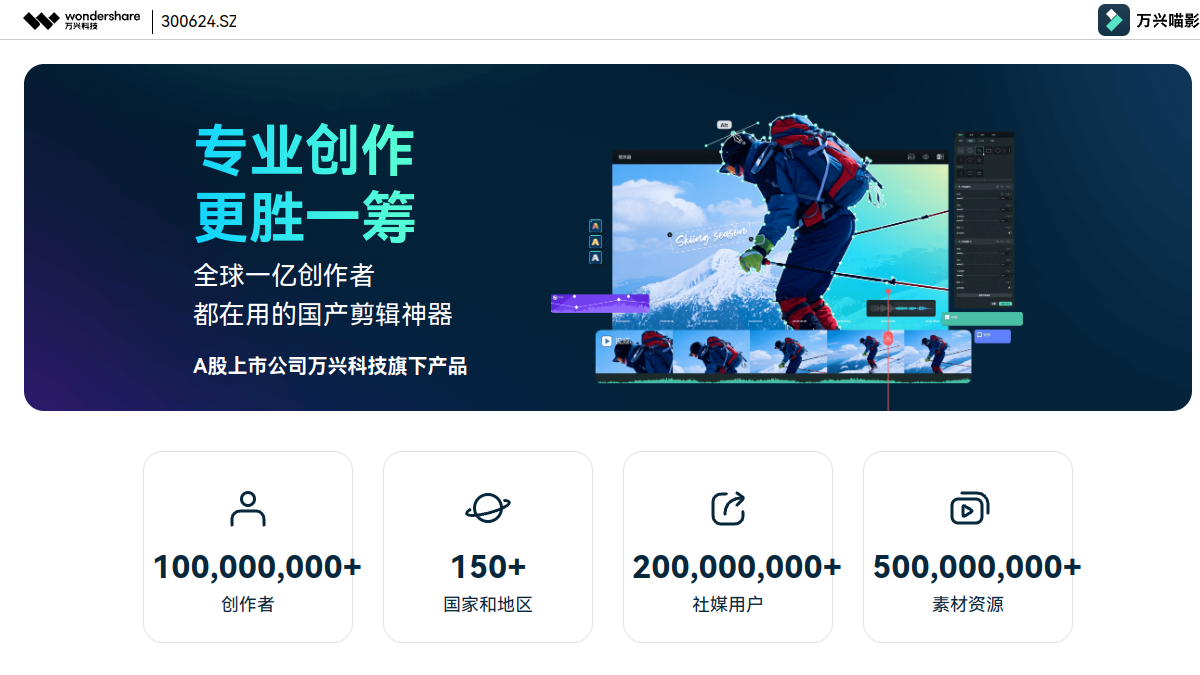
万兴喵影2023是万兴科技旗下的视频剪辑软件站点,面向不同剪辑基础的用户提供桌面端视频剪辑工具服务。核心功能包含多轨道时间轴剪辑、AIGC智能创作辅助、海量正版素材资源库,同时支持多格式视频导出与跨设备项目同步。适合内容创作者、自媒体从业者、高校学生、企业宣传人员等群体使用,可满足短视频制作、vlog剪辑、活动宣传片制作、课程课件录制剪辑等多场景创作需求,帮助用户完成从素材导入到成品输出的全流程剪辑操作。

ShortMake
ShortMake是一款基于AI技术的视频编辑工具,核心定位是降低短视频制作的技术门槛,帮助用户将创意转化为可传播的视频内容。平台核心功能包括AI脚本自动生成、智能素材匹配、一键视频成片,面向内容创作者、品牌运营人员、电商从业者等群体,适用于社交媒体内容产出、产品宣传视频制作、个人账号内容更新等多种场景,无需复杂的专业剪辑基础即可完成短视频的全流程制作。

parmonic.com
Parmonic是一款AI驱动的视频内容处理工具,核心定位是帮助用户将长视频转化为多形式的短内容资产,适配不同传播渠道的内容需求。平台支持自动识别视频核心内容片段、生成多版本剪辑、适配不同平台的画幅规格等功能,同时可配套生成视频对应的文字摘要、话题标签等配套内容。目标用户覆盖市场营销团队、内容创作者、企业培训部门、线上教育机构等群体,可应用于品牌活动回放剪辑、课程内容拆分传播、内部会议资料整理、产品演示视频多渠道分发等多个场景,帮助提升视频内容的制作和传播效率。

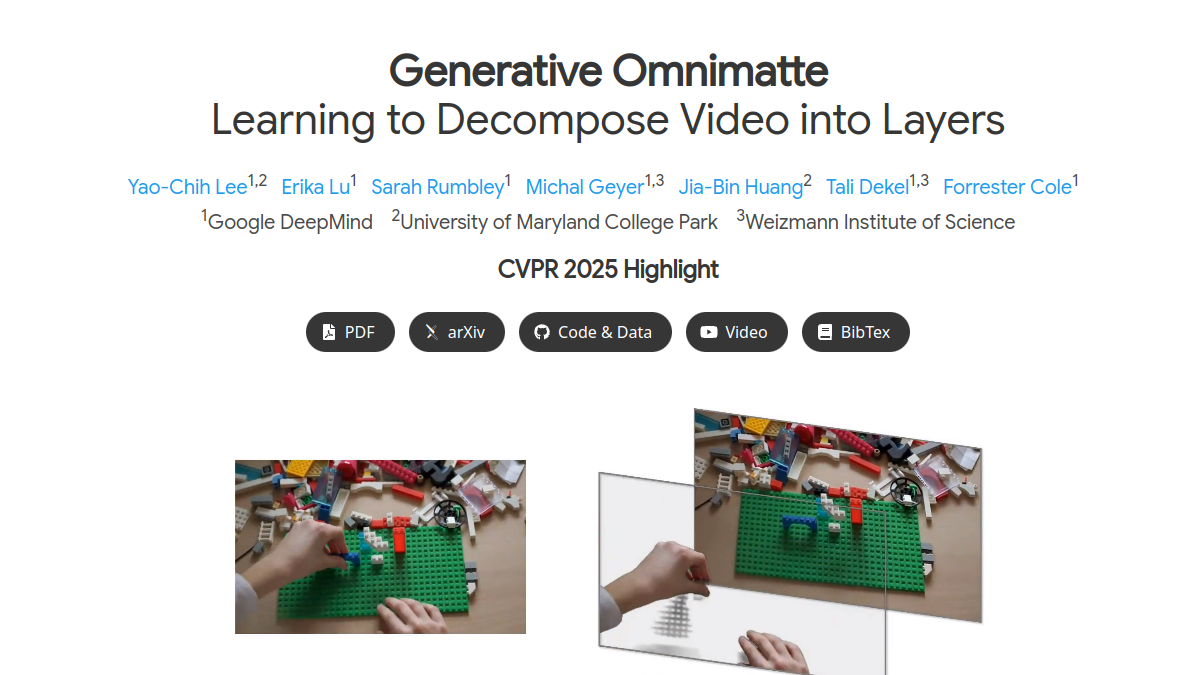
Generative Omnimatte
Generative Omnimatte是专注于视频分层处理的学术技术展示站点,核心定位为向公众展示基于生成式AI的视频RGBA分层技术成果。核心功能包括视频对象与关联效果分层提取、分层结果可视化预览、分层素材导出支持,同时提供技术论文与实现原理说明。目标用户覆盖视频创作者、影视后期从业者、计算机视觉研究者、高校相关专业学生。适用场景包括影视特效制作中独立调整对象效果、老视频修复中分层优化特定元素、学术研究中验证视频分层技术效果、短视频二次创作中快速提取素材等。

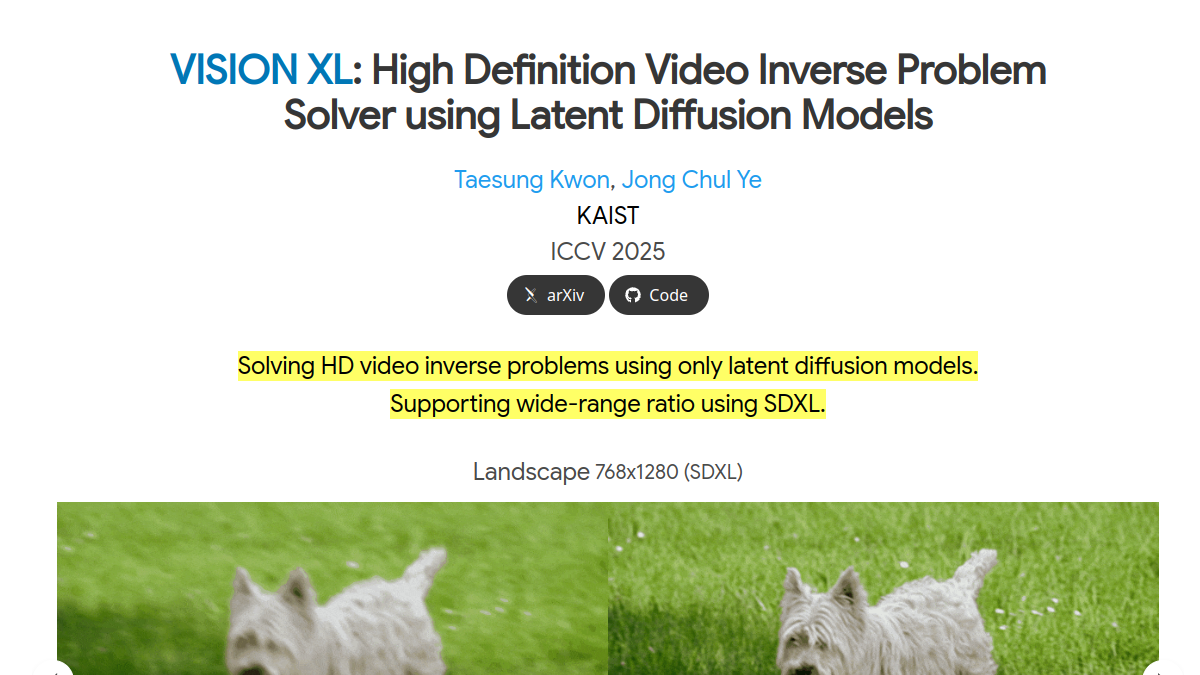
VISION XL
VISION XL是基于潜在扩散模型打造的高清视频逆问题处理框架,核心定位是为视频修复与画质提升场景提供技术解决方案。核心功能包括多比例高分辨率视频重建、伪批量一致性采样优化、批量一致性反演计算,能够适配去模糊、超分辨率、视频修复等多种场景。目标用户覆盖计算机视觉研究人员、视频制作从业者、AI算法开发工程师等群体,可应用于学术研究实验、老旧视频画质修复、专业影视内容后期处理、监控视频内容增强等多个场景,依托开源SDXL模型的技术底座,实现稳定的视频重建效果。

Monologue
Monologue是聚焦视频与播客创作领域的AI内容生产工具,依托人工智能技术为创作者提供一站式内容制作支持。核心功能包括音视频素材智能剪辑、口播内容自动生成与校对、多语言字幕自动生成与对齐,可针对不同平台的内容规范完成格式适配。目标用户覆盖独立内容创作者、中小自媒体团队、企业品牌内容运营人员等,适用于日常vlog剪辑、知识类播客制作、品牌宣传视频产出、线上课程音视频优化等多种场景,助力创作者降低内容生产门槛,缩短制作周期。

VideoReTalking
VideoReTalking是基于深度学习的说话人面部视频编辑系统,核心定位是实现音频与视频的唇形精准同步,同时支持面部表情统一调整与画面质量增强。核心功能包含面部表情标准化处理、音频驱动的唇形同步生成、身份感知的面部画质增强三类,目标用户覆盖视频创作者、新媒体运营人员、影视后期从业者、数字内容开发者等群体,可应用于口播视频二次配音、多语言译制视频口型匹配、虚拟数字人内容生成、老旧人物访谈视频修复等多个场景,无需复杂人工操作即可完成视频面部内容的自动化调整。

FLATTEN
FLATTEN是一款面向文本到视频编辑场景的光流引导注意力插件,核心定位为解决扩散模型视频编辑过程中的帧间一致性问题。其核心功能包括光流引导的注意力机制适配、无训练集成适配、帧间编辑一致性优化三类,无需额外训练即可对接现有基于扩散的文本到视频编辑方法,帮助研究人员、视频创作者提升编辑后视频的帧间连贯性,降低画面闪烁、元素偏移等问题出现概率,适用于学术研究验证、创意视频制作、短视频二次编辑等多种场景。
AnyClip, The Genius Platform
AnyClip, The Genius Platform是面向企业的AI视频智能服务平台,核心定位是帮助企业将静态视频资源转化为可交互、可检索的智能视频资产。平台核心功能包括AI驱动的视频内容结构化解析、全场景智能视频播放器、品牌定制化流媒体搭建,以及互动视频转化工具。目标用户覆盖企业市场部、内容运营团队、内部培训部门、电商运营团队、知识库管理团队等。可应用于企业对外品牌内容传播、产品演示视频互动转化、内部培训视频知识点检索、电商直播间视频实时互动导购、企业知识库视频内容分类管理等多种场景,帮助企业提升视频资产的复用效率与转化价值。
BlurOn
BlurOn是一款专注于视频敏感元素自动打码的工具插件,核心定位是为视频创作者、内容审核人员、后期制作从业者提供高效的画面隐私保护解决方案。其核心功能包括AI自动识别多类敏感元素、自定义打码参数设置、批量处理多段视频,能够大幅降低人工逐帧打码的时间成本。目标用户覆盖广播电视制作人员、短视频创作者、政务宣传内容编辑、安防视频处理人员、教育课程录制者、法务证据整理人员等,可应用于节目后期隐私保护、短视频敏感信息遮挡、公开影像合规处理、安防记录人脸脱敏、课程出镜人员隐私保护、证据视频信息隐藏等多种场景,帮助用户快速完成视频敏感内容的合规化处理。

度加剪辑
度加剪辑是百度推出的在线视频剪辑平台,核心定位是为内容创作者提供轻量化、智能化的视频编辑服务。平台具备基础剪辑操作、智能字幕生成、百度网盘素材联动三大核心功能,面向泛知识创作者、自媒体从业者、学生群体等用户,可满足课程制作、vlog剪辑、短视频内容产出、校园活动视频编辑等多种场景的使用需求,无需下载重型客户端,打开浏览器即可完成全流程剪辑操作。
Video Editor AI
Video Editor AI是一款以人工智能技术为核心的在线视频编辑工具,核心定位是降低视频编辑的操作门槛,用户无需掌握复杂的专业剪辑软件操作逻辑,仅通过自然语言描述需求即可完成剪辑操作。其核心功能包括AI智能剪辑、自动素材匹配、多场景风格适配,支持文字叠加、滤镜调节、背景音乐添加等常规编辑需求,目标用户覆盖内容创作者、自媒体从业者、小型企业运营人员、学生群体等,可应用于短视频制作、产品宣传视频剪辑、课程演示视频制作、生活记录视频加工等多种场景,满足不同用户的轻量化视频编辑需求。

SNAPVID
SNAPVID是基于AI技术的智能视频编辑工具,核心定位是降低视频创作的技术门槛,帮助用户完成视频内容的后期加工处理。其核心功能包括AI自动生成字幕、智能添加动画表情素材、一键剪辑片段拼接,可适配短视频创作、课程内容制作、营销物料产出等多种内容生产需求。目标用户覆盖内容创作者、教育从业者、品牌运营人员、个人生活记录爱好者等群体,用户无需掌握专业剪辑软件的复杂操作,即可在网页端完成视频的全流程编辑,输出符合不同平台发布规范的视频内容,提升内容的传播效果和互动性。

ClipZap.AI
ClipZap.AI是基于自动化AI工作流的视频创作服务平台,依托成熟的图像和视频建模技术,为用户提供AI驱动的视频处理相关功能。核心功能包含AI智能视频剪辑、多语言视频翻译、AI视频创意生成三类,面向视频创作者、市场营销人员、内容运营从业者等群体,可应用于短视频账号内容生产、品牌营销物料制作、跨语言内容传播、企业内部培训视频优化等多种场景,帮助用户降低视频创作的技术门槛,提升内容生产效率。

AIVLOG
AIVLOG是主打AI驱动的视频编辑工具,核心定位是降低vlog制作门槛,为不同创作基础的用户提供高效视频产出方案。核心功能包括AI智能高光识别、多端同步创作、内置素材库调用三类:AI可自动分析上传的 raw 视频内容,标记人物出现、场景切换、情绪波动等节点,筛选适合作为vlog内容的片段;支持iOS、Android、桌面端数据互通,用户可在不同设备上衔接创作流程;内置千余款商用授权音乐、字体、转场特效资源,无需额外跳转其他平台下载。目标用户覆盖无专业编辑基础的生活记录者、需要快速产出内容的兼职vlog创作者、学生群体以及中小商家的内容运营人员,适用场景包括日常出行vlog剪辑、聚会活动影像整理、个人生活记录发布、商家短宣传视频制作等多种需求。

MatAnyone
MatAnyone是由南洋理工大学与商汤科技研究团队联合开发的视频抠像技术展示平台,核心定位为提供稳定、高精度的视频语义抠像服务。平台搭载区域自适应记忆融合模块,可实现跨帧语义一致性保持,支持目标指定分割图输入适配,能处理复杂背景下的动态视频抠像需求。目标用户覆盖视频编辑从业者、影视特效制作人员、短视频内容创作者、AI视觉技术研究者等群体,可应用于影视后期人物抠像换背景、短视频创意内容制作、直播素材预处理、计算机视觉算法迭代测试等多种场景,助力用户获取边界清晰、语义连贯的抠像结果。

Light-A-Video
Light-A-Video 是专注于视频重光照处理的在线技术工具,核心定位为面向视频创作、视觉设计等领域的无需训练视频重光照服务。它支持渐进式光照融合实现帧间平滑过渡,提供多光源风格自定义配置,支持主流视频格式直接上传处理。目标用户覆盖视频创作者、影视后期从业者、动画制作人员、高校计算机视觉相关专业师生等,可用于短视频风格调整、影视片段光照效果优化、动画素材氛围渲染、科研实验数据预处理等多个场景,无需复杂的AI模型训练流程即可完成专业级视频光照效果调整。


Kawara AI
Kawara AI是面向视频创作者的AI视频素材管理与辅助编辑工具,核心定位为提升视频创作全流程效率。其核心功能包括AI驱动的素材智能检索,支持通过自然语言描述快速定位对应视频片段;AI辅助自动剪辑,可根据内容主题批量完成粗剪、转场添加等基础操作;多平台创作工具无缝集成,可直接对接主流剪辑软件调用素材。目标用户覆盖短视频创作者、影视剪辑师、自媒体运营者、广告内容制作人等,适用于日常素材归档、项目粗剪制作、多素材内容整合等多个创作场景,帮助用户减少素材查找与基础剪辑的时间消耗。

DynVFX
DynVFX是一款基于Transformer文本到视频扩散模型与视觉语言模型的视频内容编辑工具,核心定位是帮助用户通过文本指令完成动态内容的视频植入。核心功能包括文本驱动的动态元素插入、复杂场景运动适配、视频内容自然增强,无需额外训练即可实现零样本内容生成,面向视频后期创作者、内容运营人员、独立影视制作者、广告创意设计师等群体,可广泛应用于短视频特效制作、影视后期补拍、广告内容植入、创意视频二次创作等场景,降低动态特效制作的技术门槛。