

MeshUP
MeshUp是基于混合得分蒸馏技术的3D网格变形工具,核心定位是为3D创作、科研人员提供精准可控的网格局部编辑能力。核心功能包括文本/图像驱动的多概念变形、自定义顶点选择的局部区域控制、3D一致掩码的概念混合效果生成。目标用户覆盖3D建模从业者、计算机图形学研究者、游戏美术设计师、数字内容创作者。可应用于3D模型局部风格调整、多风格融合的角色模型制作、科研场景下的3D网格变形算法验证等场景,无需复杂的手动网格调整操作,即可实现高精度的网格形态修改。
ComfyUI Desktop V1
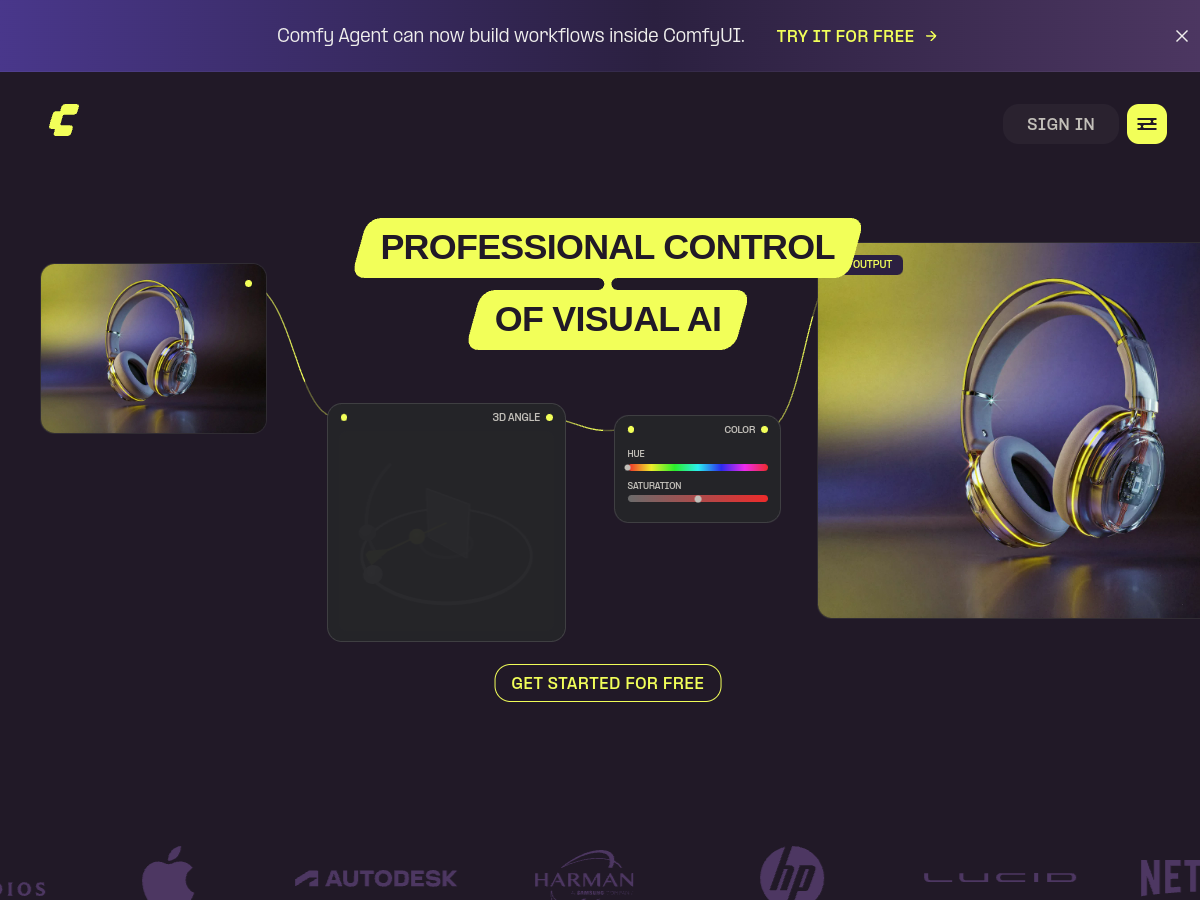
ComfyUI Desktop V1是Comfy Org组织开发的开源AI图像生成桌面客户端,适配Windows与macOS操作系统,核心定位是为用户提供低门槛的Stable Diffusion工作流搭建与运行环境。其核心功能包括一键式环境部署、可视化节点拖拽编辑、本地模型资源管理,无需用户手动配置Python环境、依赖库与CUDA驱动,大幅降低AI图像生成的使用门槛。目标用户覆盖AI绘画爱好者、数字创作者、设计从业者、AI技术研究者等群体,可应用于日常创意绘图、商业设计素材生成、AI工作流原型测试、批量图像内容生产等多种场景,目前用户可通过官网提交信息加入等待名单获取早期访问权限。

Long-LRM
Long-LRM是面向3D大场景高斯重建的技术展示项目,核心定位是实现高效的大规模3D场景从图像到三维模型的转化。核心功能包括多输入图像的3D高斯快速重建、大场景一次性完整建模、低算力成本下的高速度处理。目标用户涵盖计算机视觉研究人员、3D内容创作者、自动驾驶场景建模人员、数字孪生开发人员等。可应用于城市场景三维复刻、文物数字化存档、影视虚拟场景构建、自动驾驶仿真环境搭建等多种场景,解决传统3D重建耗时长、无法一次性处理大场景的痛点。

GenXD
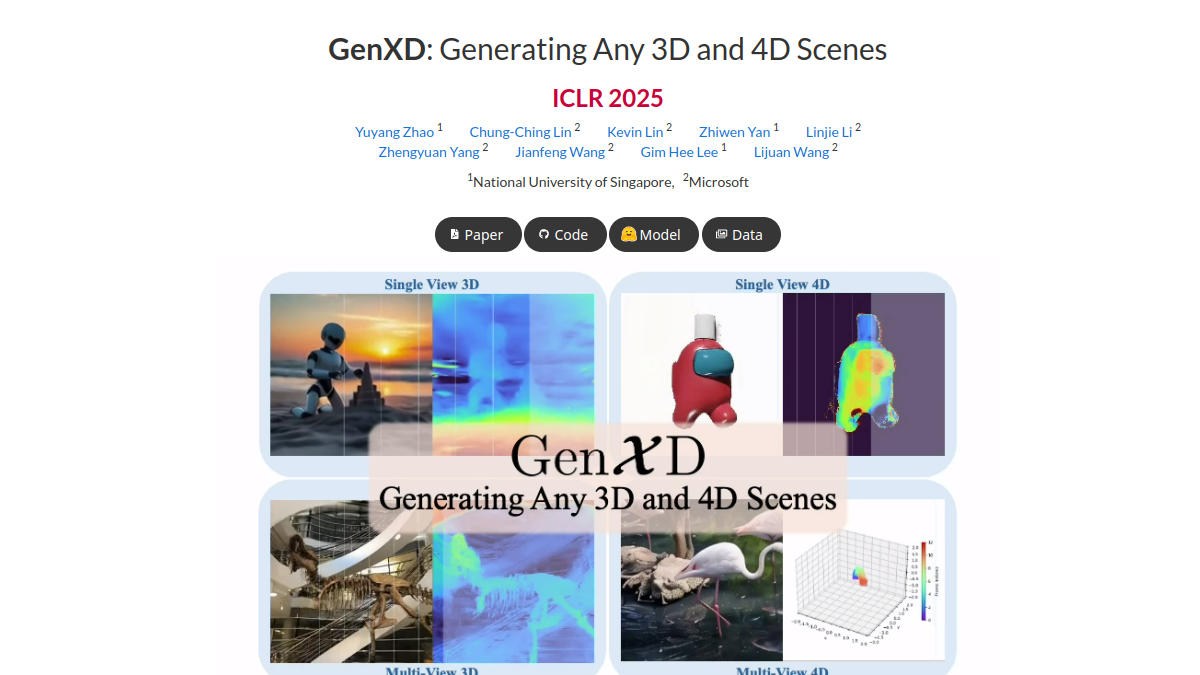
GenXD是一个专注于3D与4D场景生成的开源研究框架,核心面向计算机视觉领域的研究者、开发人员及相关方向学生,旨在解决当前4D生成领域数据稀缺、运动与相机参数耦合的行业问题。核心功能包含专业4D数据策划流程,可从普通视频中提取相机姿态与物体运动强度参数;自研CamVid-30K大规模现实世界4D场景数据集,覆盖多类真实场景样本;多视图-时间模块,可实现相机与物体运动参数的分离学习,兼容3D与4D两类数据训练。目标用户覆盖高校计算机视觉实验室研究员、3D内容开发工程师、元宇宙场景搭建人员、AI生成算法开发者、数字孪生项目从业者、图形学相关专业学生等。使用场景包括学术研究中4D生成算法的基准测试、元宇宙项目中动态场景的批量生成、数字孪生项目的真实场景复刻、3D内容创作中的多视图一致素材生成等。

PanoHead
PanoHead是专注于360°全头部3D合成的学术研究项目站点,核心定位为面向计算机视觉领域的3D人头生成技术展示与资源输出平台。核心功能包括360°几何感知的全头合成技术演示、非结构化图像训练方案说明、视图一致的3D头部生成效果展示。目标用户覆盖计算机视觉研究人员、3D内容开发者、数字人制作从业者、高校图形学相关专业师生。可应用于数字人模型快速生成、影视虚拟角色原型制作、VR/AR虚拟头像定制、人脸相关算法研究验证等场景,帮助用户降低3D头部模型的制作门槛,提升生成内容的视角一致性与几何细节精度。

DiffHuman
DiffHuman是一个面向3D人体重建领域的学术项目展示网站,核心呈现基于扩散模型的概率式光度逼真3D人体重建方案。该网站支持单张RGB图像输入的3D人体分布预测、多采样高细节人体模型生成、加速推理效果对比三大核心功能,主要服务于计算机视觉研究人员、3D内容开发者、动画制作从业者、数字人研发团队等群体,可应用于学术研究验证、动画角色快速建模、数字人素材生成、3D重建算法效果比对等多种场景,帮助用户直观了解非确定性3D人体重建技术的实现逻辑与实际应用效果。
PhysAvatar
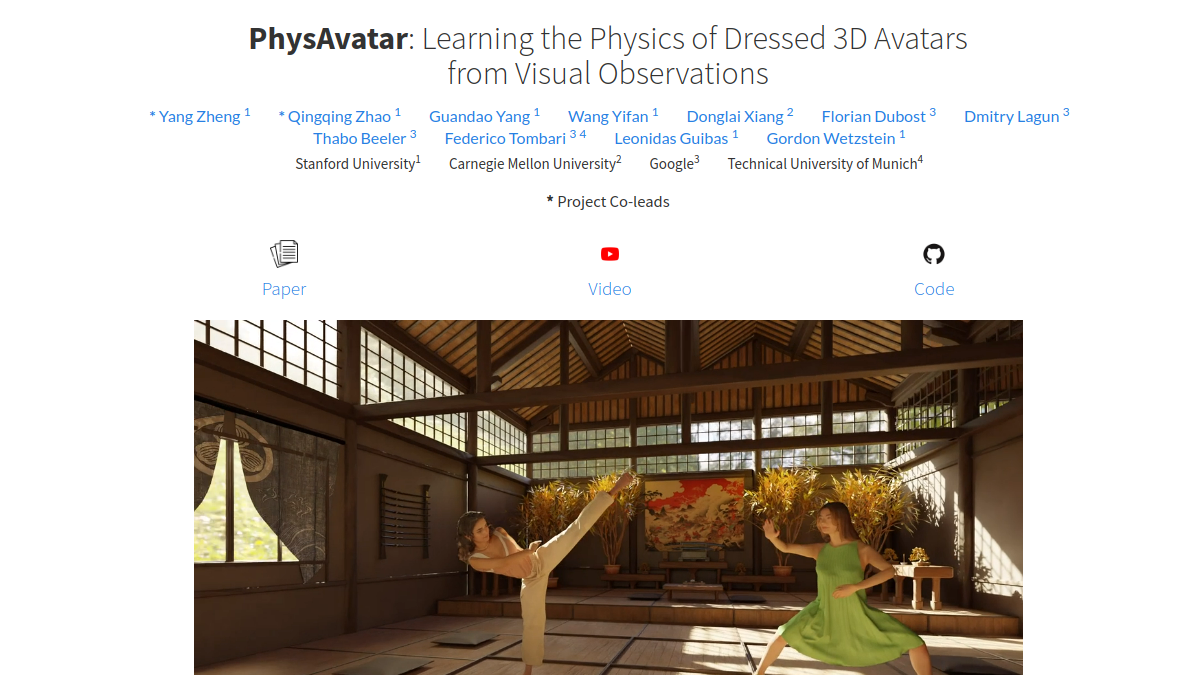
PhysAvatar是一个结合逆向渲染与逆向物理技术的研究型框架,核心作用是从多视角视频数据中自动提取人体相关的三维与物理属性。其核心功能包括多视角视频驱动的人体属性估计、服装物理参数逆向求解、跨场景新视角内容渲染三类,主要面向计算机图形学研究者、数字内容创作者、虚拟形象开发人员等群体,可应用于虚拟人制作、影视动画角色建模、数字服装仿真等多个专业场景,帮助用户降低高精度人体虚拟形象的制作成本,提升虚拟形象在不同场景下的渲染真实度。
CAP4D
CAP4D是基于可变形多视图扩散模型打造的4D人像化身生成技术平台,核心面向数字内容创作、3D建模相关从业者与研究人员。平台支持多参考图像输入生成不同视角、表情的人像画面,可将生成内容适配为可控4D化身,同时提供开源代码供技术研究与二次开发。用户可在游戏角色制作、虚拟主播形象定制、VR场景数字人搭建等场景中使用该技术,降低4D数字人创作的技术门槛,提升数字人建模的还原度与渲染效率。

Prompt Depth Anything
Prompt Depth Anything是聚焦于度量深度估计领域的技术展示与资源开放平台,核心定位为高分辨率、高精度深度估计技术的落地验证和成果共享站点。平台支持4K级度量深度估计在线演示,开放ScanNet++增强深度注释数据集下载,同时提供可扩展训练数据管道的技术文档。目标用户覆盖计算机视觉研究人员、3D内容开发从业者、机器人技术研发人员、移动端AR应用开发人员等,可应用于学术研究验证、3D重建项目落地、机器人感知模块开发、AR场景交互优化等多个场景,帮助相关从业者降低深度估计技术的落地门槛。

StereoCrafter
StereoCrafter是专注于2D视频转立体3D视频的技术框架官方站点,核心面向3D内容创作者、XR开发者、影视制作人员等群体。其核心功能包括基于基础模型先验的立体视频生成、自适应分块长视频处理、大规模3D视频数据集构建,可支持用户将普通2D视频素材转换为适配Apple Vision Pro、3D显示器等设备的沉浸式3D内容,适用于影视3D化制作、XR内容生态搭建、教学科普3D资源制作等多种场景,为3D数字内容生产提供可落地的技术路径。

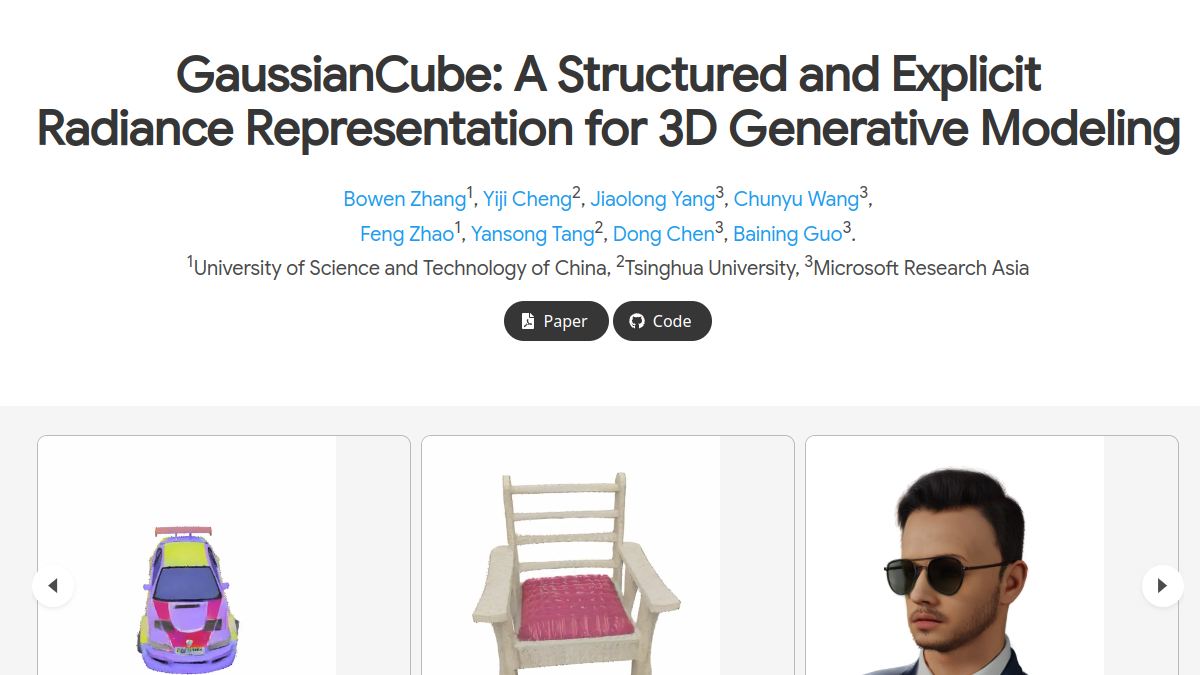
GaussianCube
GaussianCube是一个专注于3D辐射表示技术的学术项目网站,核心定位是展示结构化显式3D辐射表示的相关研究成果与应用资源。核心功能包括提供结构化高斯表示技术的完整技术文档、开源算法代码包下载、3D重建与生成效果演示案例、相关研究论文与实验数据下载、开发者使用教程与常见问题解答。目标用户覆盖计算机视觉领域研究人员、3D内容开发工程师、图形学方向高校师生、元宇宙内容创作者、3D建模从业者。适用场景包括3D内容生成模型研发、高精度3D场景重建、游戏与影视3D资产制作、AR/VR场景内容构建、3D测量与数字孪生建模等多个领域,帮助相关从业者降低3D生成建模的开发门槛,提升3D内容的制作效率与呈现质量。

GaussianCity
GaussianCity是由南洋理工大学S-Lab团队开发的3D城市场景生成框架,基于3D高斯绘制技术打造,核心定位是解决大规模3D城市生成中的内存与计算效率问题。框架内置紧凑3D场景表示模块,可降低城市场景存储占用;搭载空间感知高斯属性解码器,能够实现单步前向传递生成无边界3D城市;配套完整开源代码与预训练模型,支持用户快速自定义场景开发。面向计算机视觉研究人员、3D内容开发者、自动驾驶仿真工程师等群体,可应用于城市规划可视化、自动驾驶训练场景搭建、元宇宙城市内容创作、游戏开放世界构建等多个场景。

Ouroboros3D
Ouroboros3D是面向3D内容创作领域的统一3D生成开源框架,核心是将基于扩散的多视图图像生成与3D重建能力集成到递归扩散流程中,通过自条件机制实现两个模块的联合训练适配。其核心功能包括多视图图像递归生成、3D模型实时重建、几何一致性校验、推理过程可视化、自定义训练参数配置。目标用户覆盖3D算法研究人员、计算机图形学开发者、3D内容创作从业者、高校相关专业师生、AI生成内容技术爱好者。可应用于3D内容批量创作、数字孪生模型构建、游戏素材快速生成、学术研究算法验证、元宇宙场景搭建等多个场景,帮助用户降低3D内容生成的技术门槛,提升3D模型生成的几何稳定性。

StarVector
StarVector 是专注于图像与文本指令转可缩放矢量图形(SVG)代码的开源生成模型平台,核心定位是降低矢量图形生成的技术门槛。平台支持上传图像生成对应SVG代码、输入文本描述生成定制化矢量图、直接预览生成的矢量效果并支持代码导出,同时兼容多种风格的图形设计需求。目标用户覆盖平面设计师、技术文档编辑、前端开发人员、插画创作者等群体,可应用于UI图标设计、技术示意图绘制、印刷素材制作、网页矢量元素开发、插画草稿快速转矢量文件等多种场景,助力用户减少手动绘制矢量图的重复工作量。