

Spirit LM
Spirit LM是由研究团队推出的基础多模态语言模型,核心定位是实现文本与语音模态的自由混合交互。核心功能包括文本语音统一令牌流处理、少样本跨模态任务适配,以及两种不同特性的版本选择适配不同需求。目标用户涵盖自然语言处理研究人员、语音技术开发人员、多模态应用开发者、AI模型研究学习者等群体。使用场景包括语音识别模型优化、语音合成方案研发、多模态对话系统搭建、语音情感分析项目开发、跨模态任务迁移研究等多个方向,可帮助用户探索文本与语音模态融合的技术落地路径。
C3PO
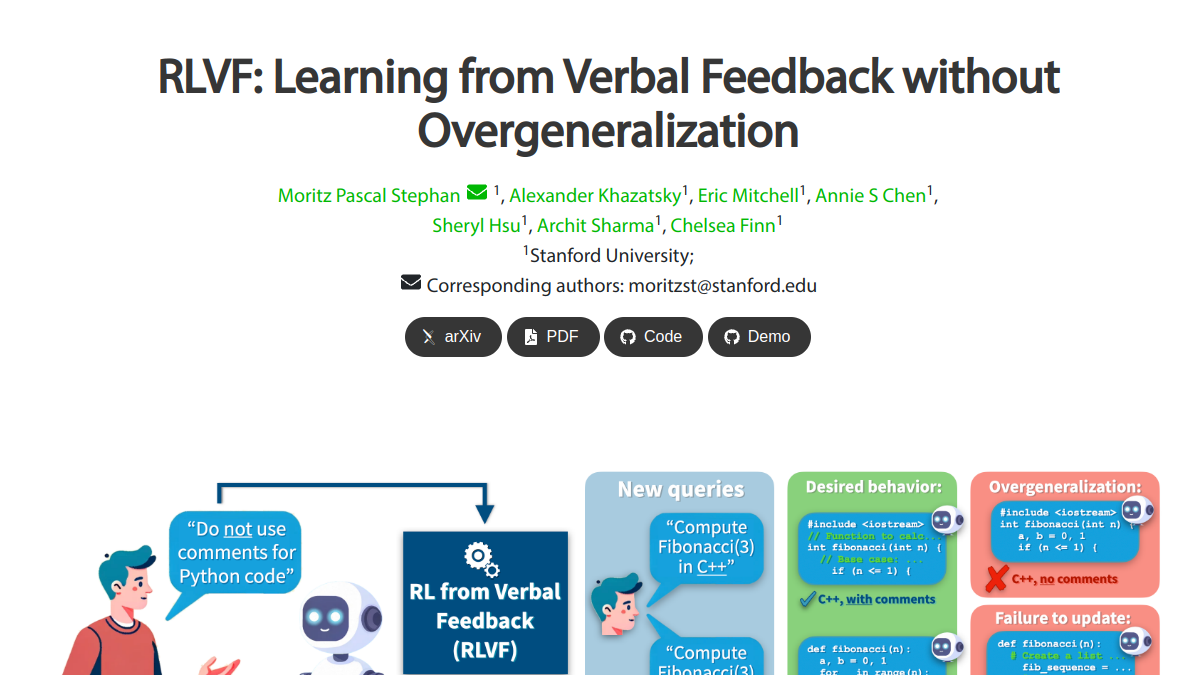
C3PO是面向大语言模型对齐领域的技术资源站点,核心功能包括提供基于单条用户反馈的LLM对齐技术参考实现、配套基准测试数据集、完整技术组件库,主要服务于人工智能领域的科研人员、算法工程师、高校相关专业师生,可用于学术研究中的模型对齐实验、工业场景下小样本模型微调优化、对齐技术效果对比测试等场景,帮助用户解决传统RLHF技术依赖大量标注数据、容易出现过度概括的问题。
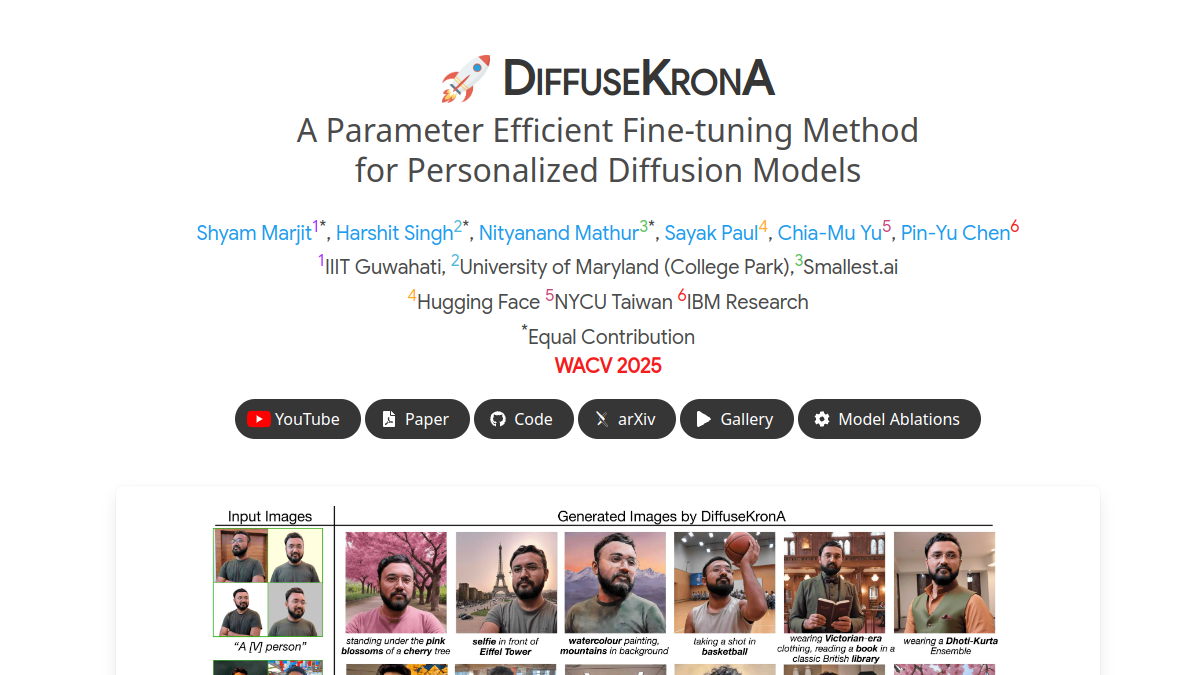
DiffuseKronA
DiffuseKronA是聚焦参数高效微调技术的学术项目站点,核心定位为个性化扩散模型微调方案的成果展示与资源分发平台。站点提供完整的算法原理详解、可运行的代码仓库入口、多场景实验对比数据,支持研究人员快速复现文本到图像生成的微调效果。目标用户覆盖AI生成图像领域的学术研究者、算法开发工程师、高校计算机相关专业师生,可用于学术论文实验验证、扩散模型落地项目优化、课程实践作业开发等场景,帮助用户在有限计算资源下完成扩散模型的个性化适配,同时保障图像合成的输出质量。
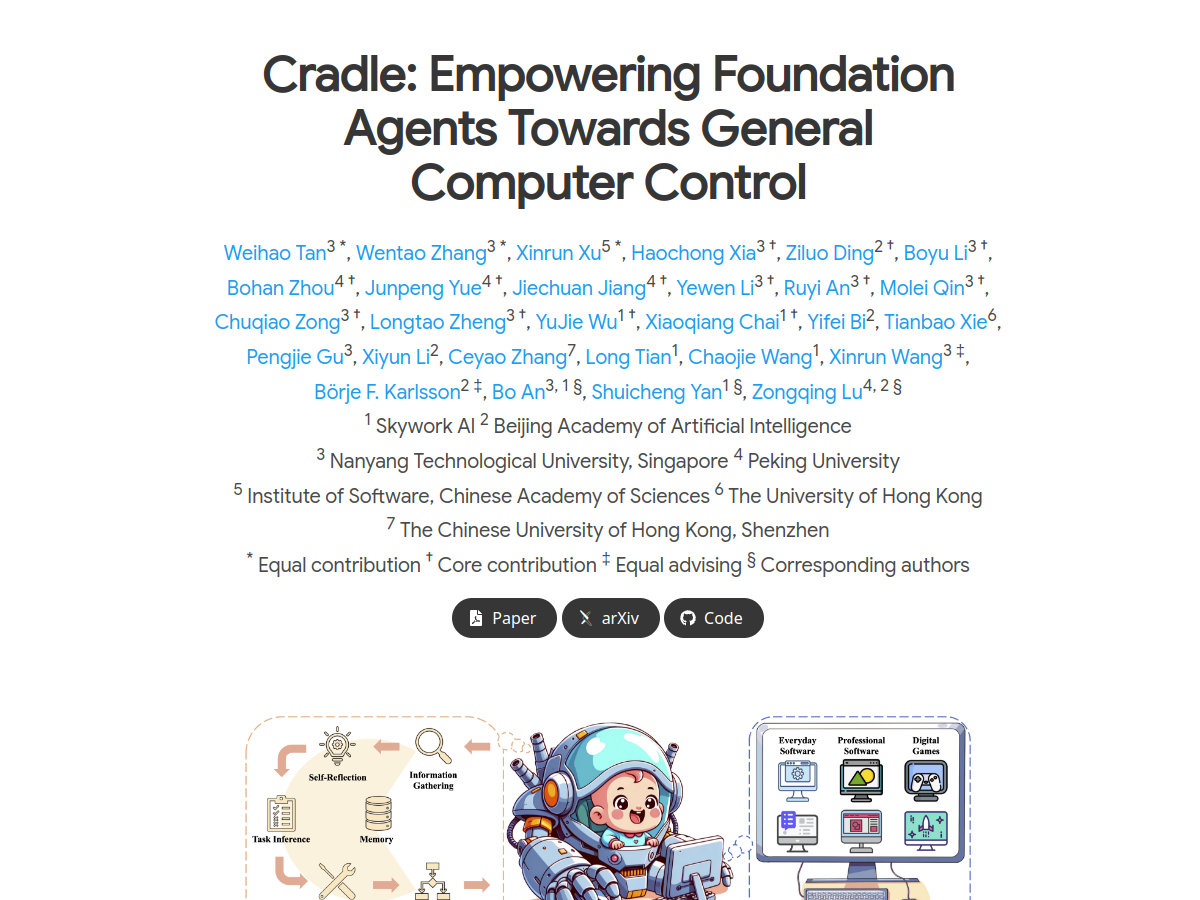
Cradle框架
Cradle框架是由北京智源人工智能研究院推出的通用具身智能框架,核心定位为让大语言模型通过与人类一致的视觉和键鼠交互接口完成复杂计算机任务。其核心功能包括通用人机交互接口适配、复杂环境推理决策、多模态感知信息处理三大模块,支持多场景下的智能体自主操作。该框架面向人工智能研究者、游戏AI开发者、具身智能研究人员为主要目标用户,可应用于游戏AI开发、自动化办公流程研发、通用具身智能算法验证、复杂软件自动化测试等多个场景,目前已通过《荒野大镖客2》游戏任务执行案例验证了其环境泛化与自适应能力。

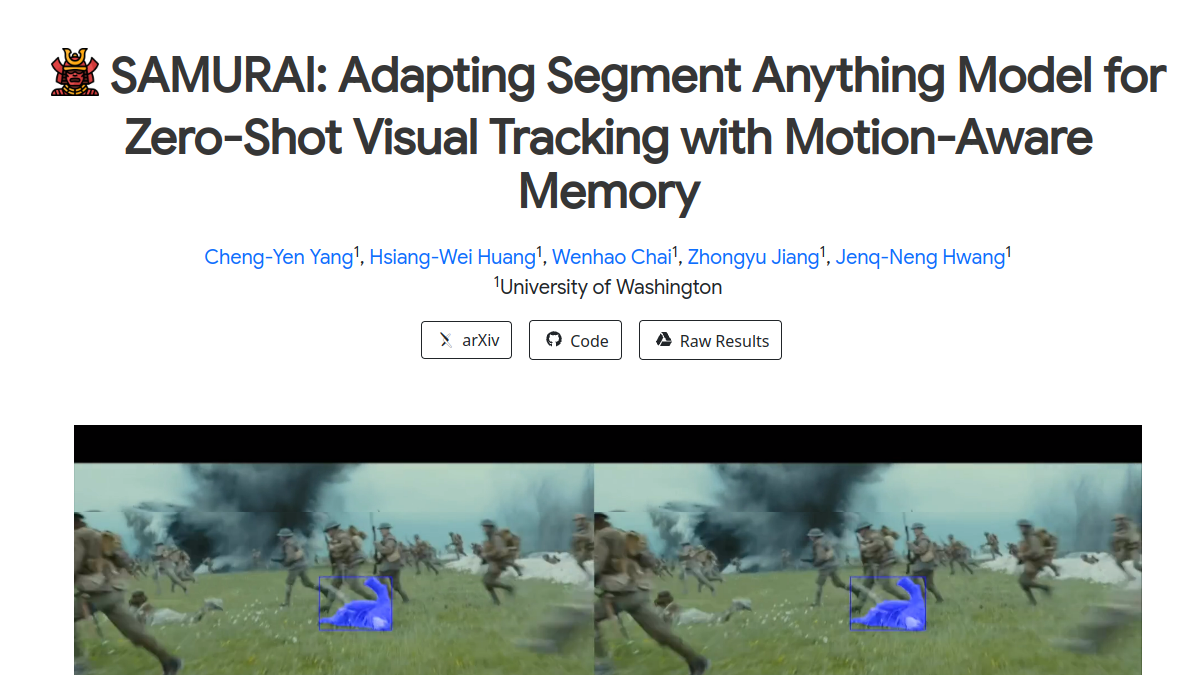
SAMURAI
SAMURAI是基于Segment Anything Model 2(SAM 2)开发的视觉对象跟踪模型项目官网,核心定位是为视觉跟踪领域提供无需微调的零样本目标跟踪解决方案。核心功能包括运动感知记忆选择机制、时间运动线索融合、多基准数据集效果验证等,支持用户快速了解模型架构、复现跟踪效果、下载相关测试资源。目标用户覆盖计算机视觉领域研究人员、AI算法开发工程师、智能监控系统开发者、自动驾驶感知模块研发人员等,可用于学术研究对比、工业级视觉跟踪系统搭建、复杂动态场景跟踪方案选型等场景,帮助用户降低视觉跟踪模型的开发和适配成本。
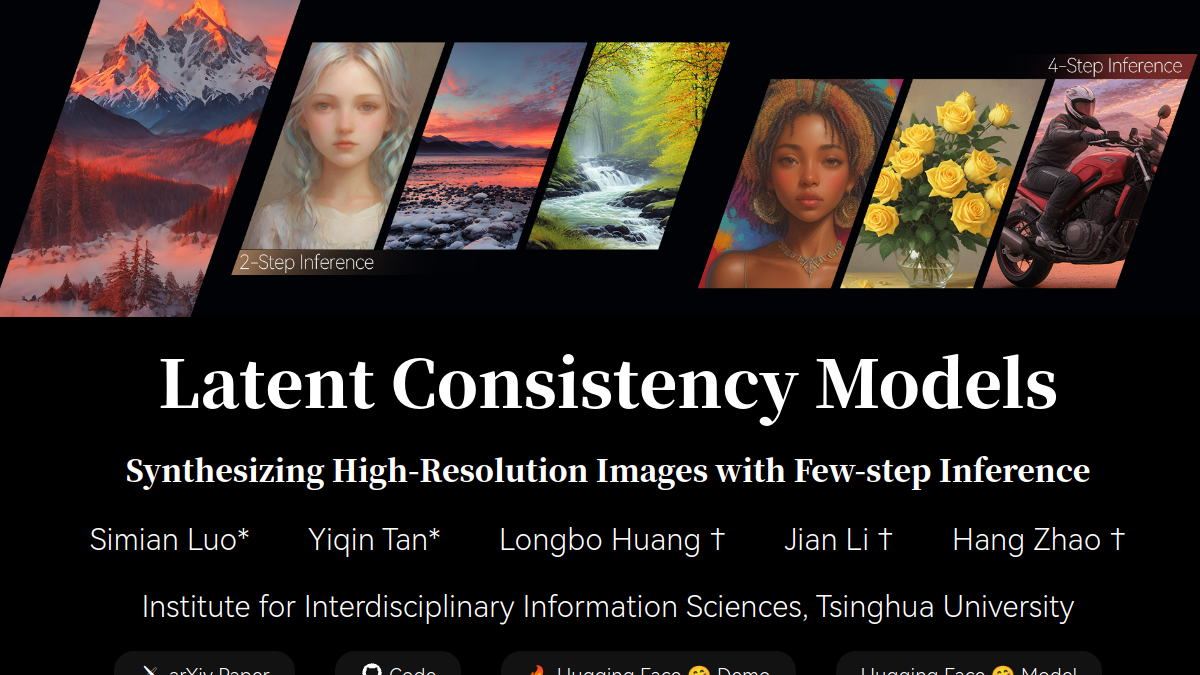
Latent Consistency Models
Latent Consistency Models(简称LCMs)是面向AI图像生成领域的开源技术项目网站,核心定位是提供低推理成本的高分辨率图像生成技术方案。其核心功能包括预训练稳定扩散模型适配能力,可从现有成熟的稳定扩散模型中快速衍生出LCMs版本;支持少步推理生成高保真图像,无需多轮迭代即可输出清晰画面;提供Latent Consistency Fine-tuning(LCF)自定义微调方法,适配个性化图像生成需求。目标用户覆盖AI算法研发人员、图像生成工具开发者、内容创作从业者等,可应用于AI图像工具研发、批量图像内容生产、个性化图像模型训练等场景。

Chinese Tiny LLM
Chinese Tiny LLM(简称CT-LLM)是面向中文场景优化的开源轻量大语言模型项目官网,核心定位为低资源门槛下的中文自然语言处理工具支持。项目核心功能包括20亿参数规模的中文大模型下载、全流程训练与评估数据集开放、多场景任务测试结果查询。目标用户覆盖NLP领域研究人员、中小团队AI开发人员、高校人工智能相关专业师生。可应用于轻量化中文对话系统开发、垂直领域小模型微调、大语言模型训练方法论研究等场景,同时支持英文、编程代码类相关任务的适配验证。
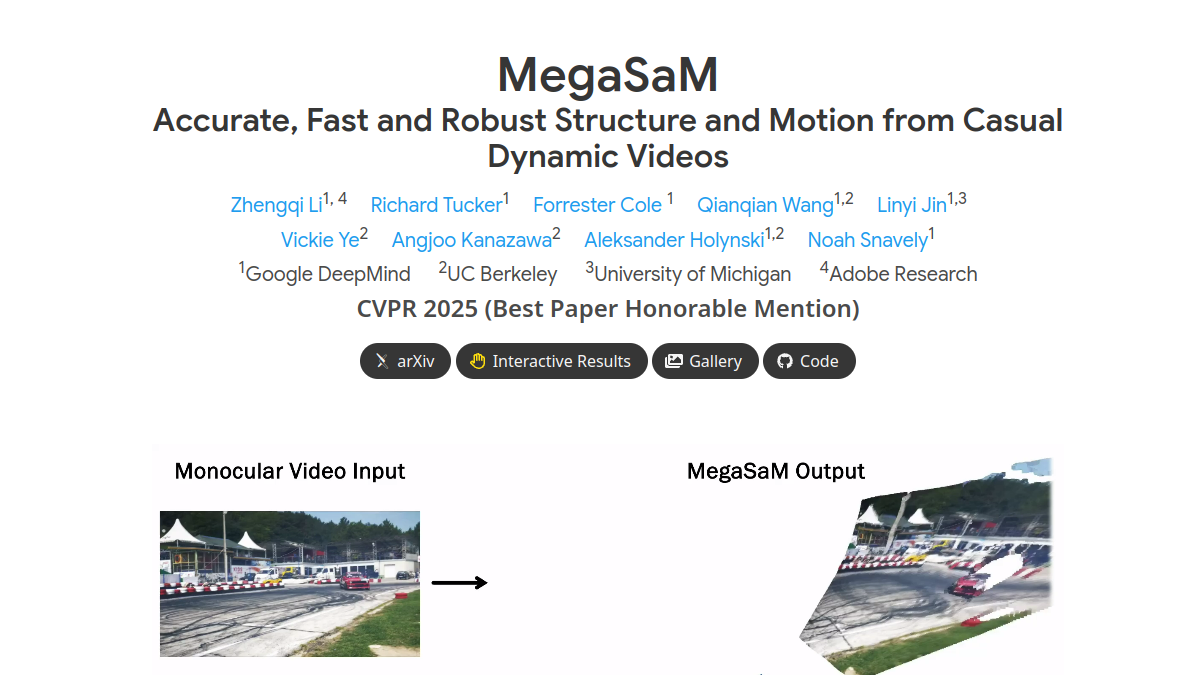
MegaSaM
MegaSaM是一个面向动态场景单目视频处理的视觉SLAM技术系统,核心定位为从单目视频中快速稳健估计相机参数与深度图。其核心功能包括动态场景相机姿态估计、高精度深度图生成、不受限相机路径适配。目标用户覆盖计算机视觉研究人员、自动驾驶算法开发者、三维重建从业者、影视特效制作人员、AR/VR技术开发者等群体,可应用于动态街景三维重建、移动设备空间定位、动态场景虚实融合、影视镜头三维信息提取、机器人环境感知等多个场景,解决传统SLAM技术仅适用于静态场景、对相机路径限制较多的问题。
Genesis AI
Genesis AI是面向机器人学、具身AI与物理AI领域的物理仿真平台,核心定位是为相关研发场景提供高拟真度的物理模拟与数据生成支持。平台搭载自研通用物理引擎,可实现多类型材料与物理现象的模拟,同时内置真实感渲染系统与生成数据引擎,支持自然语言转多模态数据的需求。平台适配Python开发习惯,目标用户覆盖机器人研发工程师、具身AI研究者、高校相关专业师生、仿真技术开发人员等,可应用于机器人运动测试、具身智能模型训练、物理场景仿真实验、AI训练数据集生成等场景,帮助用户降低物理实验成本,提升研发测试效率。

Synaptic.js
Synaptic.js是一款面向前端开发者的开源JavaScript神经网络库,核心定位是降低在浏览器环境中构建、训练神经网络的技术门槛。其核心功能包括支持多种经典神经网络结构搭建、内置模块化训练优化工具、提供可直接运行的实战案例演示。目标用户覆盖前端开发人员、AI入门学习者、教育领域从业者、小型项目开发团队,可用于网页端交互AI功能开发、神经网络原理教学演示、轻量级AI原型快速验证、前端技术栈AI应用探索等多种场景。
Keras
Keras是一个由Python编写的开源神经网络API,核心定位是为开发者提供简洁一致的深度学习开发框架,降低模型构建的复杂度。核心功能包括支持TensorFlow、JAX、PyTorch多后端切换,提供模块化的神经网络层快速搭建模型,内置常见数据集与预训练模型支持快速迭代。目标用户覆盖机器学习研究者、应用开发工程师、高校相关专业学生等,适用于图像识别、自然语言处理、语音识别等深度学习项目的开发、训练与跨平台部署场景。

Video Prediction Policy
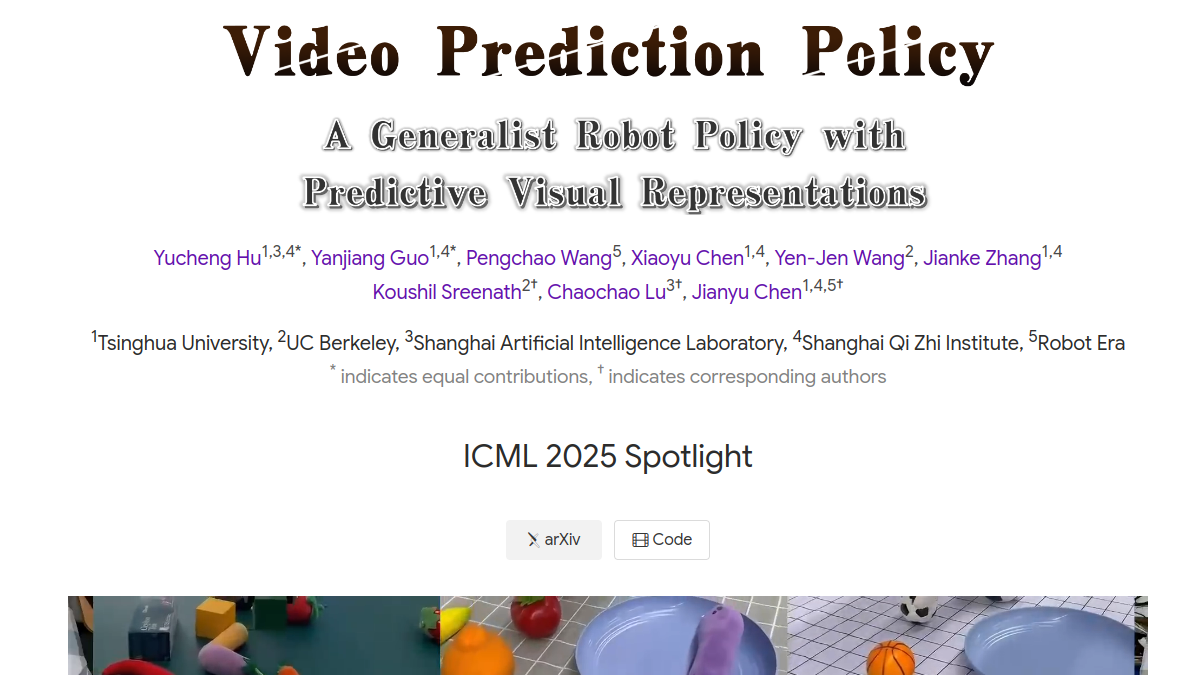
Video Prediction Policy(简称VPP)是专注于机器人视觉预测策略研究的学术展示平台,核心展示基于视频扩散模型的机器人操控技术方案。平台提供完整的VPP技术原理讲解、实验基准测试数据、预训练模型开源资源,以及相关论文成果和数据集获取渠道。目标用户覆盖机器人学研究者、计算机视觉方向科研人员、机器人开发工程师、人工智能领域高校师生、具身智能项目研发团队、工业自动化方案设计人员。可用于机器人操控算法性能对比参考、具身智能视觉预测模块开发、相关学术研究的实验基线搭建、视频扩散模型跨领域应用探索等场景。

Valley 2.0
Valley 2.0是字节跳动开发的多模态大型模型官方体验站点,核心定位是为用户提供文本、图像、视频融合的多模态AI能力服务。站点支持多模态内容理解、跨模态内容生成、多轮多模态对话三类核心功能,面向AI技术研究者、内容创作者、电商运营人员、短视频从业者等群体,可应用于学术效果验证、内容素材制作、商品内容解析、视频内容摘要、智能问答交互等多种场景,帮助用户便捷体验开源多模态大模型的实际处理效果。

LlamaChat
LlamaChat是一款开源的本地大语言模型桌面客户端,核心定位为用户提供无需连接云端即可运行主流开源大模型的交互工具。核心功能包括多格式模型导入、多模型兼容交互、本地离线运行、开源可二次开发。目标用户覆盖AI爱好者、科研人员、应用开发者、隐私敏感型办公人群等。可应用于本地模型测试、隐私数据处理、小范围离线AI应用搭建、科研实验对比等场景,所有计算均在本地设备完成,无需上传数据至第三方服务器。

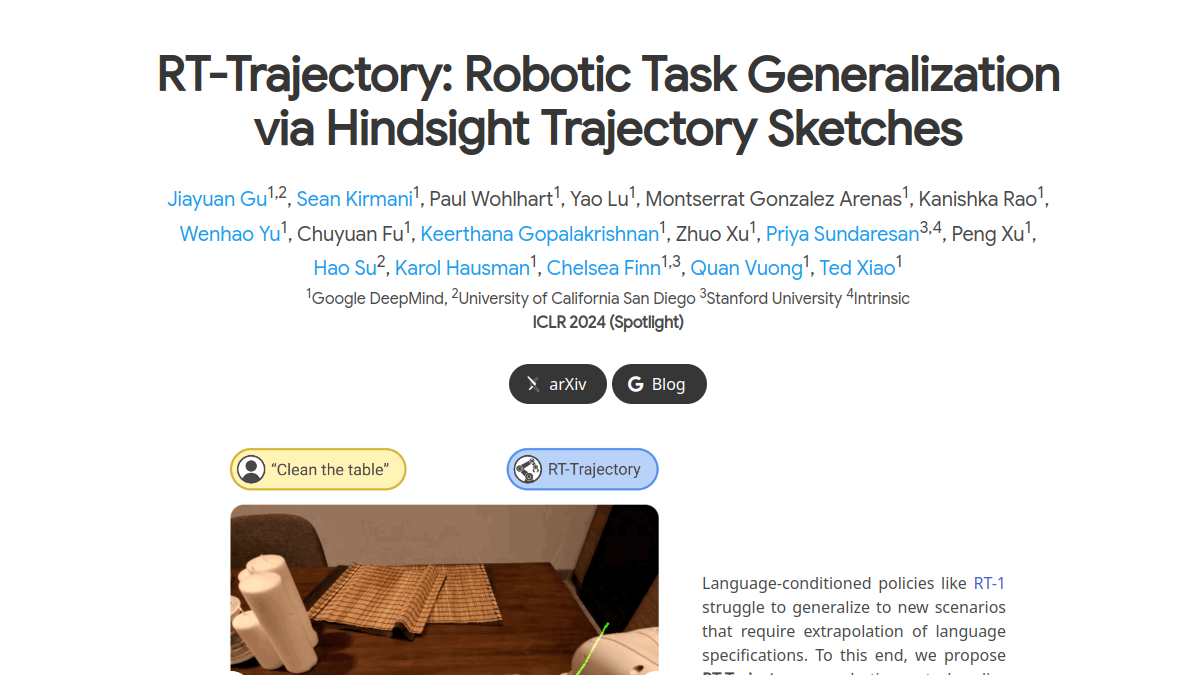
RT-Trajectory
RT-Trajectory是专注于机器人轨迹控制与任务泛化的技术项目官网,核心定位是为机器人控制领域提供基于轨迹草图的策略实现方案。平台支持多源轨迹草图生成、机器人任务泛化验证、真实场景效果评估、多模态输入适配等核心功能,同时提供完整的技术文档与开源代码支撑,方便相关从业者快速落地相关方案。该项目面向机器人研发工程师、人工智能研究者、高校自动化专业师生、机器人赛事参与者、工业自动化方案开发者、具身智能创业团队等用户群体,可应用于工业机器人任务调试、服务机器人新功能开发、具身智能算法研究、机器人教学实验、多模态机器人控制方案验证等多个场景,帮助用户降低机器人新任务适配的开发成本,提升不同场景下的任务执行适配性。

FireRedASR
FireRedASR是开源工业级普通话自动语音识别工具,依托Encoder-Decoder与LLM集成架构开发,提供两种适配不同需求的模型变体,可实现多场景下的语音内容转文字处理。核心功能包含多语言语音识别、离线推理支持、批量音频处理、自定义热词优化、低资源音频适配,目标用户覆盖AI应用开发者、音视频内容创作者、企业技术研发人员、高校科研团队等,可用于智能助手语音交互、长视频字幕批量生成、会议录音内容转写、方言语音内容存档、客服通话质检分析等多类场景,满足工业级应用的集成与二次开发需求。

HOMIEtele
HOMIEtele是一款专注于人形机器人遥操作的开源技术服务平台,核心定位为研究人员、机器人开发团队提供集动作捕捉、远程控制、仿真训练于一体的技术支持体系。平台集成实时人体运动捕捉模块,可将人体肢体动作快速映射至人形机器人关节;内置强化学习训练框架,支持用户自定义训练场景完成机器人行走、操作等任务的模型迭代;提供多端适配的遥操作接口,满足不同硬件环境下的远程控制需求。目标用户覆盖机器人领域研发人员、高校相关专业师生、人形机器人开发团队、人工智能算法研究员等,可应用于人形机器人动作开发、远程作业场景验证、强化学习算法落地测试、机器人教学演示等多个场景。
SRM
SRM是德国马普信息研究所开发的基于去噪生成模型的空间推理框架,核心定位为解决连续变量集合的推理任务,适用于空间数据生成、概率分布建模等研究场景。核心功能包括连续变量分步推理、独立噪声水平分配、生成顺序智能预测、幻觉现象抑制、复杂分布适配,目标用户为人工智能领域研究人员、计算机视觉算法开发者、生成模型从业者、高校计算机相关专业师生、空间数据分析人员,可用于三维空间数据生成、多模态变量推理、生成模型效果优化、空间推理算法实验等场景。