


天翼AI开放平台
天翼AI开放平台是中国电信正式上线的AI技术服务平台。平台以中国电信自研的星辰大模型为技术底座,提供从AI技术能力展示到产品体验、接入使用的全流程服务。


Desearch
Desearch是专注于深度研究和智能分析的平台,帮助用户高效获取有价值的信息并精准建立研究框架。平台提供了多种研究模式,包括普通模式、深度模式和专家模式,适用于快速获取信息、专题调研和跨领域战略分析。


Infinite Mobility
Infinite Mobility 是上海AI Lab推出的可交互物体生成模型,基于程序化生成技术,高效生成高质量的可交互物体数据资产。Infinite Mobility支持22类常见可交互物体的生成,单个物体生成仅需约1秒,且生成数量无上限。


Markable AI
Markable AI 是 AI 电商创作营销助手,为创作者提供一站式变现工具。基于图像与视频识别技术,Markable AI能识别照片和视频中的商品,将用户导流至电商平台。


Aether
Aether 是上海AI Lab开源的生成式世界模型,完全基于合成数据训练。Aether 首次将三维时空建模与生成式建模深度融合,具备 4D 动态重建、动作条件视频预测和目标导向视觉规划三大核心能力。


AI写作猿
AI写作猿是AI智能写作平台,基于AI技术为用户提供多种写作辅助服务。AI写作猿支持AI写作、对话、伪原创、新媒体内容创作等功能,提供学习、医疗、法律等领域的咨询服务。


EAP Talk
EAP Talk 是基于AI技术的英语口语测评应用,专注于学术英语(EAP)的学习与练习。基于大数据、语音识别、自然语言处理等技术,为学生提供实时自动打分和智能反馈。


InstantCharacter
InstantCharacter 是腾讯混元开源的定制化图像生成插件。基于扩散 Transformer(DiT)框架,引入可扩展的适配器(包含多个 Transformer encoder)和千万级样本的大规模角色数据集,实现高保真、文本可控且角色一致的图像生成。


OpenUtau
OpenUtau 是开源的歌声合成工具,兼容 UTAU 音源库和重采样器,支持 VSQX 导入、多语言界面及预渲染功能,帮助创作者快速预览作品节省时间。OpenUtau现代化的界面和丰富的编辑功能,如音素器、颤音编辑器等,让音乐创作更加直观高效。


交交
交交是上海交通大学听觉认知与计算声学实验室推出的全球首个纯学术界自研的口语对话情感大模型。交交具备多人对话、多语言交流、方言理解、角色扮演、情感互动及知识问答等强大功能,支持汉语、英语、日语、法语等多种语言,能精准识别中文方言。


EviMed
EviMed 是基于 AI 智能算法的医学信息平台,主要为医学工作者和科研人员设计。整合了全球七大知名中英文医学数据库,提供多维度搜索、AI 智能分析、科研选题、循证决策等功能。通过深度学习和医学大模型,快速生成精准的医学知识总结,助力医学工作者效率提升。


UniRig
UniRig是清华大学计算机系和VAST联合推出的创新自动骨骼绑定框架,用在处理复杂和多样化的3D模型。基于大型自回归模型和骨骼点交叉注意力机制,生成高质量的骨骼结构和蒙皮权重。


The AI Scientist
The AI Scientist-v2 是 Sakana AI 、不列颠哥伦比亚大学、Vector研究所等机构联合推出的完全自动生成科学发现的端到端人工智能系统,支持自主地提出科学假设、设计和执行实验、分析数据、生成可视化结果,撰写科学论文。


大学搜题酱
大学搜题酱是作业帮旗下针对大学生的AI学习助手,具备多种功能,如AI问答、拍搜答疑、文字搜索、找答案浮窗、资料库、扫码搜书和收藏等。应用涵盖千所高校期末真题,收录四六级、考研考公等各类试题资料,支持多种搜题方式,搜题快、结果准,且资料丰富。

九歌
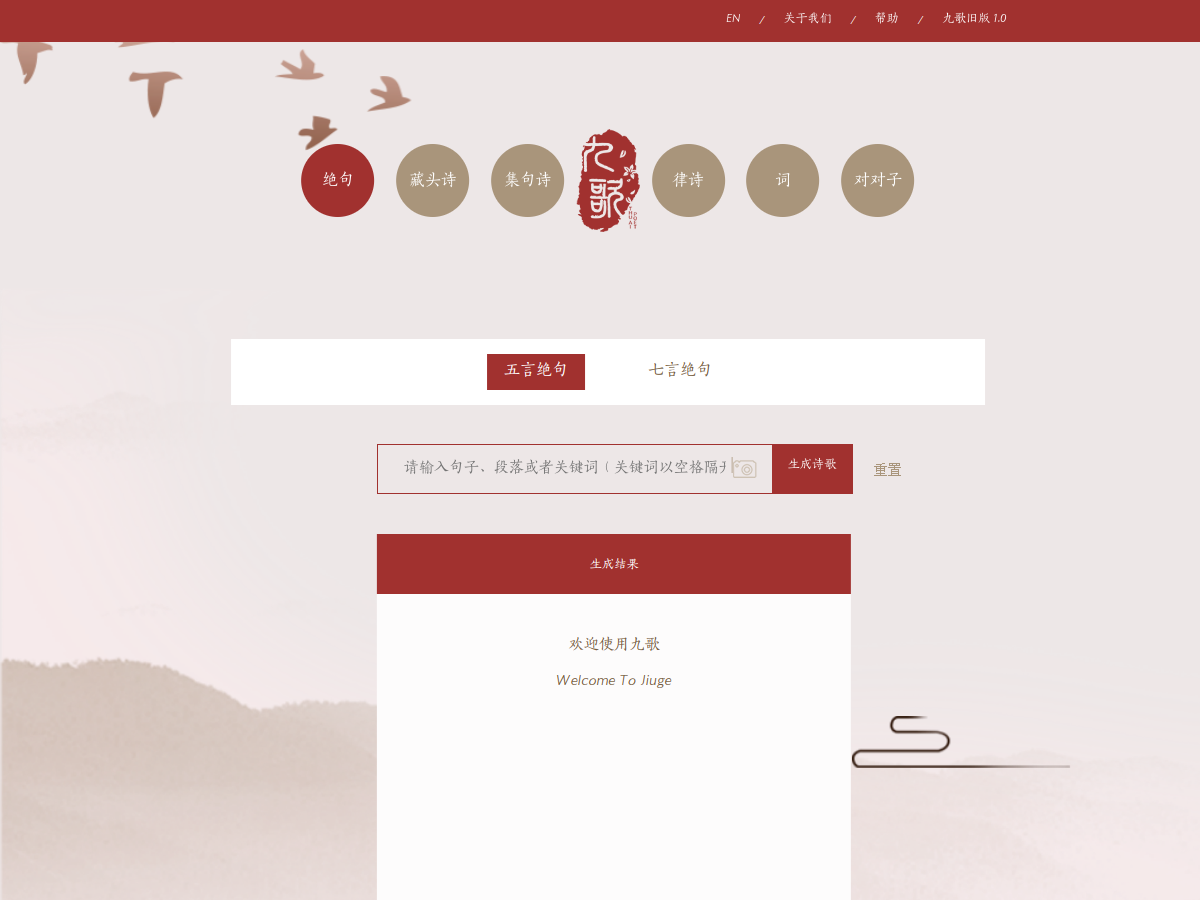
九歌是清华大学自然语言处理与社会人文计算实验室推出的AI诗歌写作系统。九歌基于深度学习技术,用超过80万首人类诗人创作的诗歌进行训练,辅助用户生成符合古诗格律的诗词作品。


UNO
UNO是字节跳动推出创新的AI图像生成框架,突破传统模型在多主体生成中的局限。通过“少到多”的泛化方法,能高质量地生成单主体和多主体图像,解决了多主体场景下的一致性难题。UNO基于扩散变换器生成高一致性的多主体数据,采用渐进式跨模态对齐技术,分阶段训练模型,逐步提升生成效果。


明岐
明岐是上海交通大学计算机学院LoCCS实验室推出的首个精准诊断罕见病的医学多模态大模型。基于“大模型能力矩阵 + 专家路由协同”的双引擎驱动架构,整合医学影像、病历文本及化验指标等数据,为医生提供高精度、可解释的诊断支撑。


Seaweed
Seaweed-7B 是字节跳动团队推出的视频生成模型,拥有约 70 亿参数。Seaweed-7B具备强大的视频生成能力。模型支持从文本描述、图像或音频生成高质量的视频内容,支持多种分辨率和时长,广泛应用于视频创作、动画生成、实时交互等场景。


FlexIP
FlexIP 是腾讯提出的面向图像合成的灵活主体属性编辑框架,平衡图像生成中的身份保持和个性化编辑。框架采用双适配器架构,将身份保持与个性化编辑解耦,通过高层语义概念与低层空间细节确保身份完整性。


FantasyTalking
FantasyTalking 是阿里巴巴 AMAP 团队和北京邮电大学联合提出的新型框架,用于从单张静态肖像生成逼真的可动画化虚拟形象。基于预训练的视频扩散变换器模型,采用双阶段视听对齐策略,第一阶段通过片段级训练方案建立连贯的全局运动,第二阶段通过唇部追踪掩码在帧级别细化唇部运动,确保与音频信号精确同步。