

Generative Powers of Ten
Generative Powers of Ten是专注于多尺度一致图像生成的在线演示平台,核心基于文本驱动的多尺度扩散采样技术,可实现跨尺度的场景语义缩放生成。平台支持连续缩放视频渲染、交互式多尺度场景探索两大核心功能,同时提供生成结果与传统超分方案的对比展示。目标用户覆盖计算机视觉研究人员、数字内容创作者、教育科普工作者、交互设计从业者等群体,可用于图像生成技术研究参考、创意视觉内容制作、多尺度成像原理科普演示等多种场景,帮助用户直观理解文本驱动的跨尺度图像生成逻辑与效果差异。

IP-Adapter
IP-Adapter是面向文本到图像扩散模型的轻量化适配工具,核心为预训练扩散模型提供图像提示支持,助力多模态图像生成任务。其核心功能包括解耦交叉注意力机制设计、多类可控生成工具兼容、多模态提示融合生成三类,目标用户覆盖AI图像生成研究者、AIGC应用开发者、视觉创意设计师、计算机视觉方向学生等群体,可应用于定制化图像生成、多模态创意落地、扩散模型功能扩展、批量图像风格迁移等场景,帮助用户在现有文本生成图像模型的基础上,低成本接入图像参考能力,提升生成结果的匹配度。

Zoo
Zoo是Replicate推出的开源文字转图像模型实验平台,核心定位是为AI图像生成爱好者、创作者及开发者提供多模型并行测试与效果对比的在线环境。平台支持稳定扩散系列及多种开源文生图模型调用,可同步展示同一提示词在不同模型下的生成效果,还支持生成参数自定义调整,方便用户比对不同模型的风格适配性。目标用户覆盖AI艺术创作者、设计从业者、AI模型研究人员、内容创作者等,可用于AI图像创作效果测试、模型选型参考、生成参数调试、创意内容原型产出等场景。

RF-Inversion
RF-Inversion是由德克萨斯大学奥斯汀分校与谷歌研究人员联合开发的图像生成与编辑技术展示平台,核心基于随机微分方程(SDE)实现图像反转与编辑操作,无需额外模型训练、潜在空间优化、提示词调整或复杂注意力处理器即可完成相关任务。平台核心功能包括零样本图像反转、笔画转图像合成、语义图像编辑三类,主要面向计算机视觉研究人员、AI图像技术开发者、数字内容创作者、高校图像处理相关专业学生等群体,可应用于学术研究效果复现、创意图像内容生成、图像属性定向调整、手绘内容数字化转换等多种场景。

PIXART
PIXART是面向文本到图像生成领域的开源项目站点,核心展示并提供PIXART-Σ扩散变换器模型的相关资源。该模型主打4K分辨率图像生成能力,支持用户通过输入自然语言描述生成对应视觉内容,同时提供完整的模型部署教程、预训练权重下载及效果演示案例。站点目标用户涵盖AI图像生成研究者、计算机视觉方向开发者、数字内容创作者等群体,可用于学术研究验证、创意图像产出、模型二次开发等多个场景,为文本到图像生成技术的落地与迭代提供开源技术支撑。

DALL·E Cli
DALL·E Cli是基于OpenAI DALL-E 2 API开发的命令行图像生成工具,核心定位是为有命令行使用基础的用户提供本地可配置的AI图像生成、编辑工作流。其核心功能包括通过命令行调用DALL-E 2 API生成图像、支持对生成图像或本地图像进行亮度/对比度/锐度调整、内置多类图像滤镜效果,同时支持本地配置文件保存OpenAI API令牌,避免重复输入。目标用户覆盖开发者、命令行爱好者、AI图像创作者、技术类内容创作者、开源工具使用者、自动化流程搭建者,可应用于批量AI图像生成、脚本化图像处理、无GUI环境下的图像创作、自动化内容生产等多个场景。
LCM-Lookahead
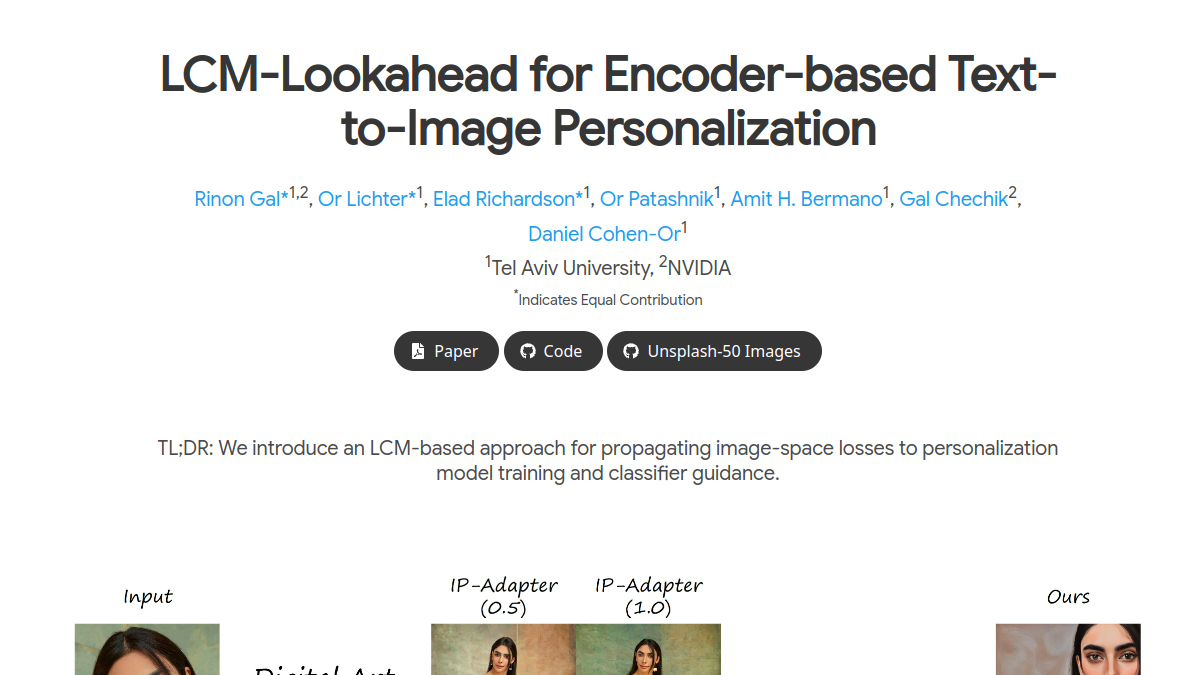
LCM-Lookahead是面向编码器类文本生成图像场景的个性化技术演示站点,核心定位是展示基于前向损失传播机制的图像身份保真优化方案。站点支持上传自定义人脸图像生成指定风格的同身份创作内容,可实时对比普通LCM模型与LCM-Lookahead模型的生成效果差异,还提供技术原理说明文档供开发者参考。目标用户覆盖AI图像生成研究者、数字内容创作者、个性化图像定制服务商等,适用于学术效果验证、定制化头像生成、同角色多场景创作等场景,帮助用户在保证图像布局多样性与提示词对齐度的前提下,提升生成内容的身份还原度。

MoMA
MoMA是一款基于开源多模态大语言模型打造的个性化图像生成工具,核心定位为主题驱动的插件式图像生成适配框架。核心功能包括无需微调即可适配现有扩散模型、保留参考图像目标特征生成定制化图像、提升生成内容的提示词忠实度与细节表现。目标用户覆盖AI图像创作者、设计从业者、学术研究人员、内容运营人员等,可应用于定制化文创设计、概念效果图生成、多模态模型性能优化测试、个性化营销物料制作等场景,无需额外模型训练即可快速实现个性化图像生成需求。

ViewDiff
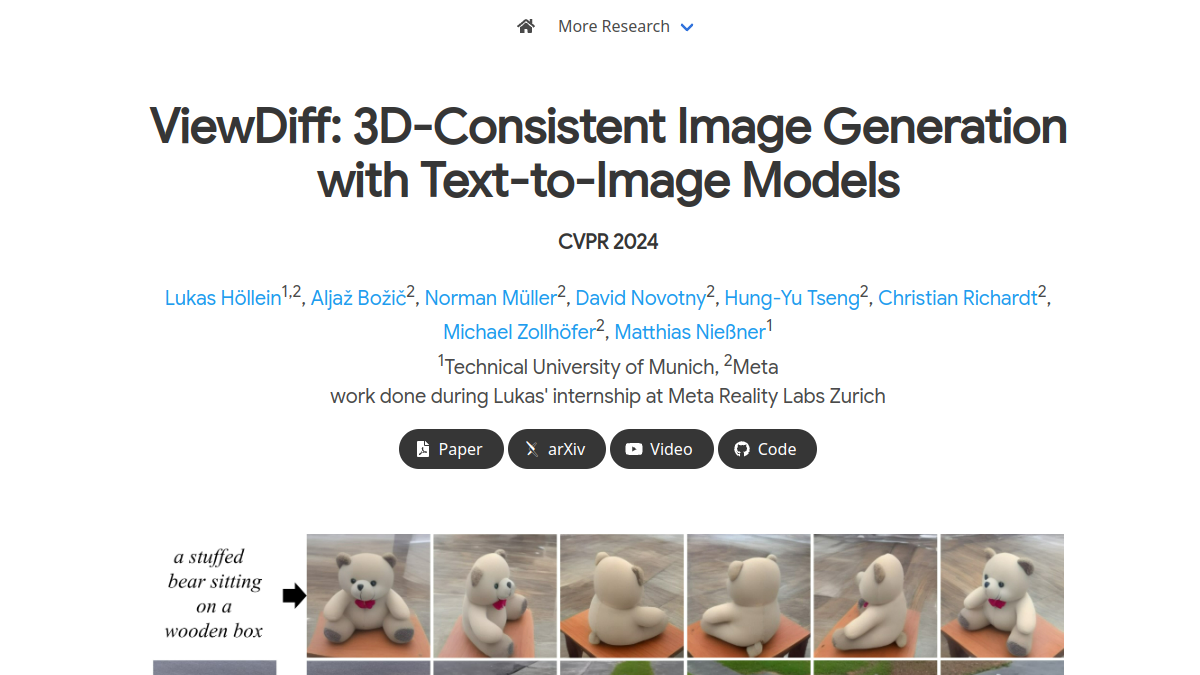
ViewDiff是一个面向3D内容创作、计算机视觉研究领域的在线多视角一致图像生成工具,基于预训练文本到图像模型作为技术基础,结合3D体积渲染与跨帧注意力机制实现3D一致性内容生成。核心功能包括单图生成多视角一致图像、文本引导3D视角内容编辑、自定义相机参数视角渲染三类,目标用户覆盖计算机视觉研究人员、3D建模师、游戏内容创作者、动画制作人员等,可用于快速生成3D资产多视角参考图、小体量3D内容原型制作、学术研究中的3D生成效果对比等场景,帮助用户降低多视角3D内容的制作门槛。

VMix
VMix是面向文本生成图像扩散模型的美学增强技术工具站,核心定位为即插即用的扩散模型美学适配器,通过价值混合交叉注意力技术提升生成图像的美学表现。核心功能包括无需重新训练的社区模型适配、美学质量定向调控、图文对齐度保留三大模块,目标用户覆盖AI图像创作者、扩散模型开发者、内容设计从业者等群体,可应用于插画创作、宣传物料设计、模型性能优化、AI艺术实验等多种场景,帮助用户在不修改原有模型基础逻辑的前提下,提升输出图像的视觉表现。

HyperDreamBooth
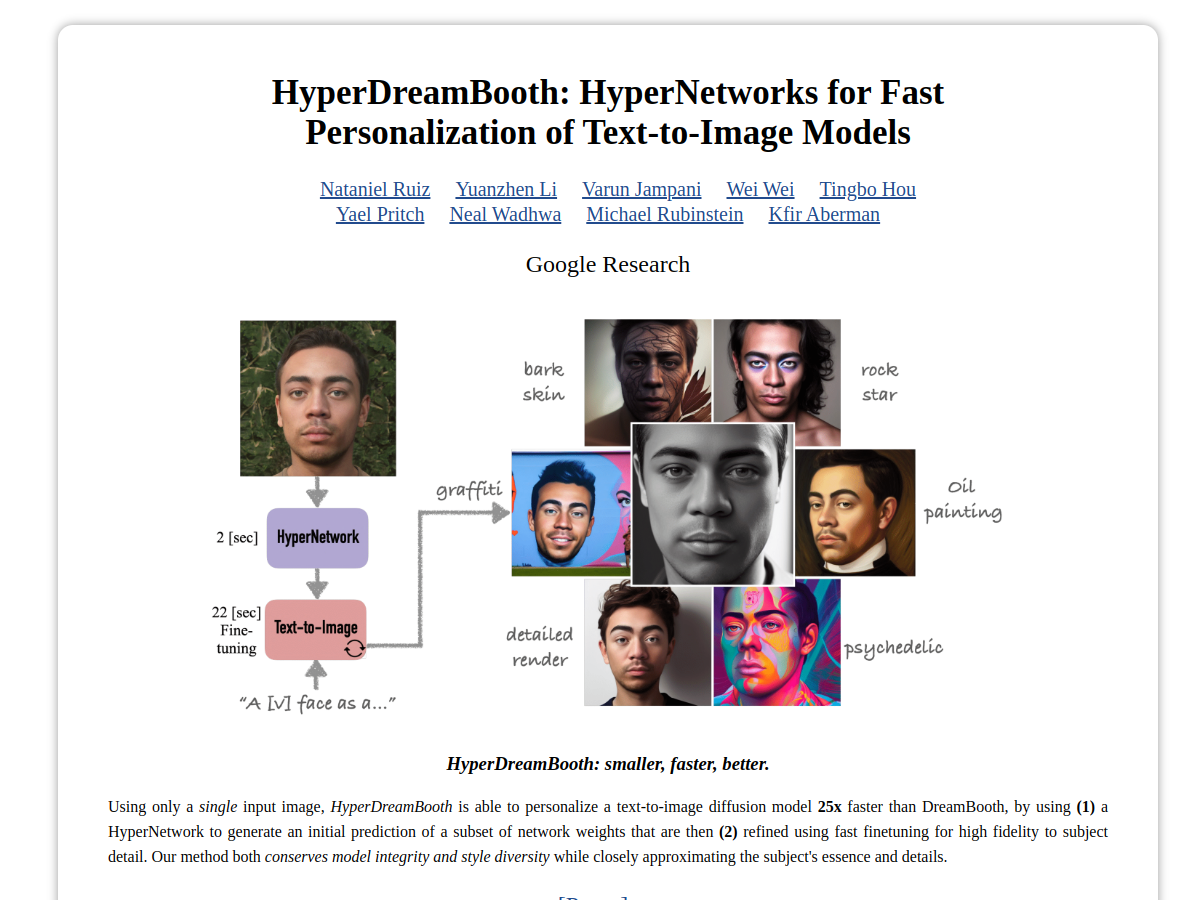
HyperDreamBooth是Google Research推出的文本到图像模型个性化工具,核心定位为依托超网络架构实现人脸图像的快速定制生成。核心功能包括单张人脸权重生成、快速微调适配、多风格上下文生成、语义修改保留四类。目标用户覆盖AI图像研究人员、数字内容创作者、游戏美术设计师、个性化内容开发者等群体,可应用于定制化数字头像制作、影视角色概念设计、个性化文创产品开发、AI人脸生成技术研究等场景,在保留原有文本生成模型的风格适配能力的同时,提升人脸生成的主题匹配度。
关于AI图像生成器
AI 图像生成器是图像与创意设计领域的重要细分方向,专注于Midjourney、DALL-E、Stable Diffusion 等。Toolifai精选该分类下最优质的AI工具,每款工具均经过实际体验和严格评测,提供详细的功能介绍、使用教程、优缺点分析和定价信息,帮助您快速找到适合自己的AI工具,提升工作效率。