
In3D
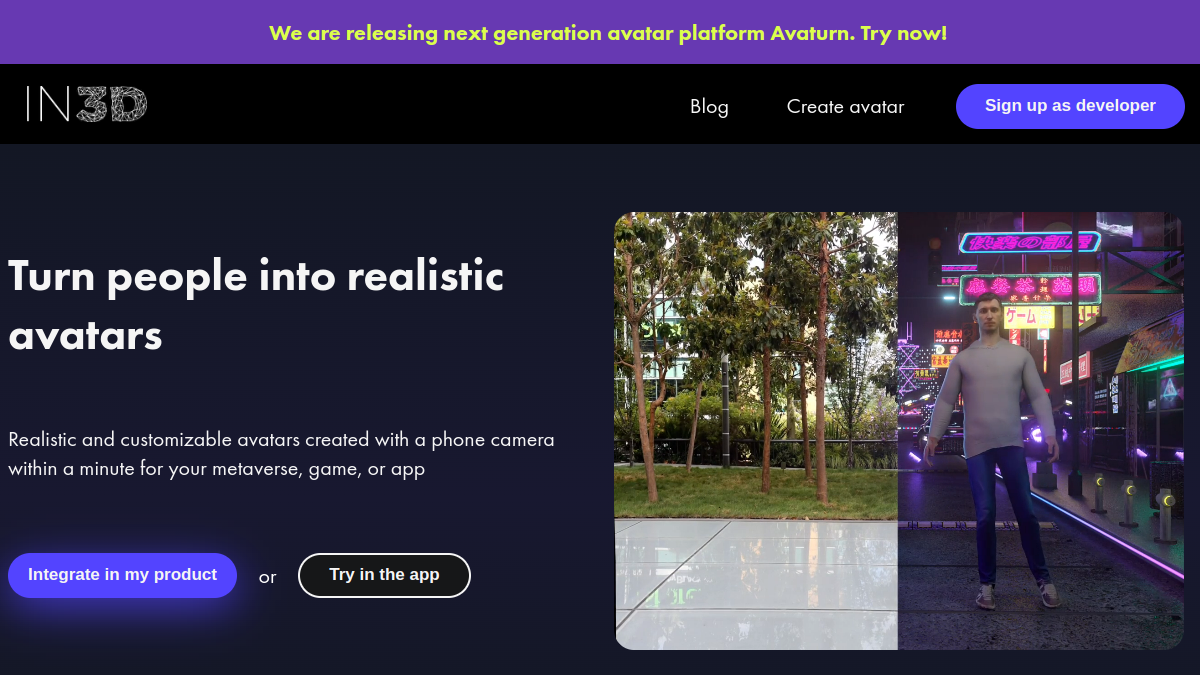
In3D是专注于人体3D数字化生成的服务平台,核心定位是为开发者和内容创作者提供低门槛3D人体模型生成解决方案。平台核心功能包括移动端快速人体扫描建模、高保真3D模型自动生成、可嵌入产品的SDK集成服务,目标用户覆盖游戏开发从业者、元宇宙内容创作者、虚拟社交平台运营方、服饰电商商家等群体,可应用于虚拟角色定制、虚拟试衣场景搭建、元宇宙身份形象创建、VR/AR交互内容制作等多个场景,帮助用户降低3D人体模型的制作成本,缩短生产周期。

Garment3DGen
Garment3DGen是一款面向3D服装创作领域的在线工具,核心定位是为用户提供轻量化的3D服装模型生成服务。其核心功能包括可视化拖放式服装编辑、多维度参数调节、多格式3D模型导出,支持用户无需安装专业客户端软件,即可在浏览器中完成服装模型的基础创作。目标用户覆盖服装设计师、3D建模从业者、游戏美术人员、3D打印爱好者等群体,适用于服装设计原型快速制作、游戏角色服装资产搭建、3D打印服装模型预处理、高校服装相关专业教学实训等多个场景,帮助用户降低3D服装创作的操作门槛。

AnimatableDreamer
AnimatableDreamer是专注于非刚体3D模型生成与重建的技术框架网站,核心定位为面向单目视频输入的可动画3D内容生成工具。核心功能包括从普通单眼视频中提取物体运动规律、生成不同类别的可动画非刚体3D模型、实现4D动态生成效果的时间一致性校验。目标用户覆盖计算机视觉研究者、3D内容创作者、动画制作从业者、元宇宙内容开发人员、学术科研人员。可应用于短视频3D内容转制、角色动画模型快速生成、文物3D动态还原、虚拟数字人模型搭建、动态物体3D存档等多种场景,为非刚体3D内容生产提供技术支撑。
versy
Versy是一款专注于文本生成交互式虚拟空间的AI工具,核心定位为帮助用户通过自然语言描述快速搭建各类虚拟互动场景。其核心功能包括文本转3D虚拟空间生成、内置场景模板快速调用、互动逻辑自定义配置三大类,支持用户无需掌握复杂3D建模技能即可完成场景搭建。目标用户覆盖虚拟活动策划者、产品展示设计师、线上教育从业者、游戏场景创作者等群体,适用于线上展会搭建、虚拟产品演示、沉浸式教学场景制作、轻量级互动游戏开发、元宇宙活动空间设计等多种场景,可有效降低虚拟空间制作的技术门槛与时间成本。
LGM
LGM是专注于3D模型生成的技术框架站点,核心定位是为用户提供从文本提示或单视图图像生成高分辨率3D模型的技术能力。其核心功能包括多视图高斯特征3D表示、非对称U-Net多视图处理、高分辨率3D内容快速生成。目标用户覆盖3D内容创作者、游戏开发人员、AI研究人员、工业设计从业者等群体,可应用于游戏资源制作、元宇宙场景搭建、产品原型3D建模、学术研究实验等多个场景,帮助用户降低3D模型创作的技术门槛,提升生成效率与输出质量。

Long-LRM
Long-LRM是面向3D大场景高斯重建的技术展示项目,核心定位是实现高效的大规模3D场景从图像到三维模型的转化。核心功能包括多输入图像的3D高斯快速重建、大场景一次性完整建模、低算力成本下的高速度处理。目标用户涵盖计算机视觉研究人员、3D内容创作者、自动驾驶场景建模人员、数字孪生开发人员等。可应用于城市场景三维复刻、文物数字化存档、影视虚拟场景构建、自动驾驶仿真环境搭建等多种场景,解决传统3D重建耗时长、无法一次性处理大场景的痛点。

GAGAvatar
GAGAvatar是基于高斯模型的3D头像重建与动画生成技术服务站点,核心定位是为有3D数字头像制作需求的用户提供单图驱动的头像生成与动画方案。核心功能包括单张图片快速生成3D高保真头像、实时面部表情动画驱动、跨身份面部特征泛化适配,目标用户覆盖数字内容创作者、游戏开发人员、虚拟人从业者、计算机视觉研究者等,可应用于虚拟主播形象制作、游戏角色自定义、影视数字替身快速生成、学术研究数据集构建等多个场景,降低3D头像制作的技术门槛与时间成本。
MVDrag3D
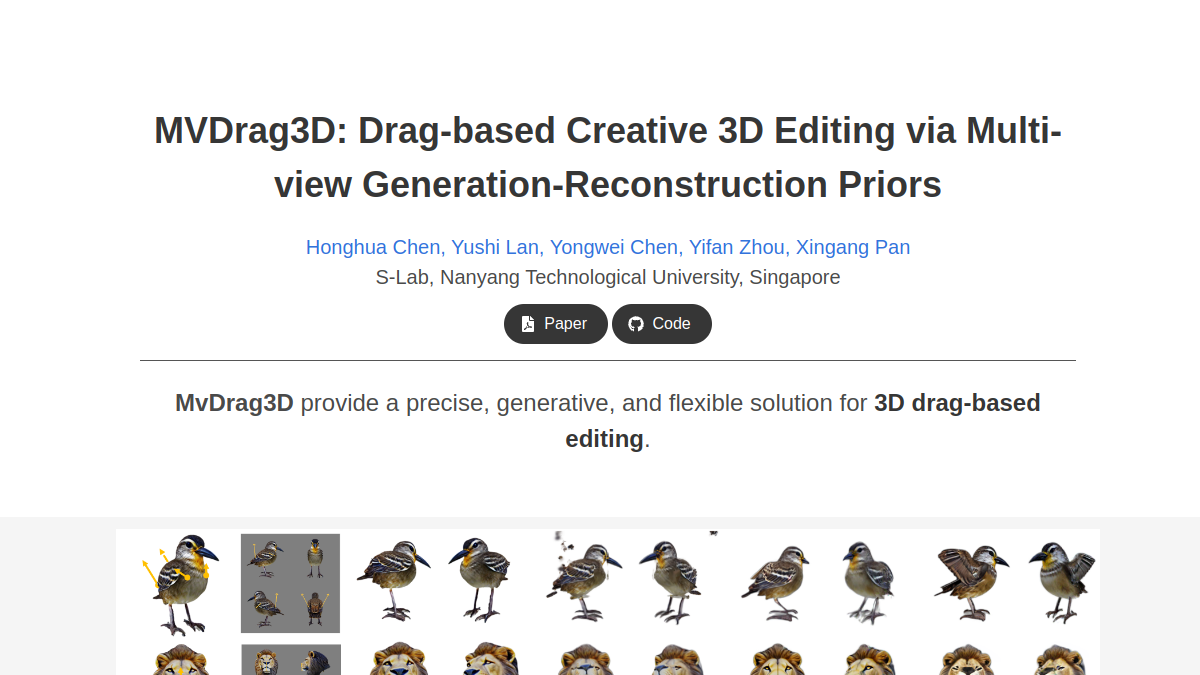
MVDrag3D是基于多视图生成与重建先验技术打造的拖拽式3D编辑框架,核心定位是降低3D内容编辑的操作门槛,实现更灵活的3D对象调整。核心功能包括多视图一致的拖拽式3D变形、3D高斯实时重建与优化、跨视图编辑效果一致性校验。目标用户覆盖3D建模从业者、计算机图形学研究人员、游戏内容开发者、工业设计人员、数字内容创作者等群体,可应用于3D模型局部调整、创意3D造型设计、多视图一致内容生成、3D重建后优化等多种场景,支持多种常见3D对象类别的编辑需求。
MetaMaker
MetaMaker是厦门黑镜科技有限公司开发的云原生企业虚拟化平台,核心定位是为用户提供元宇宙内容创作与发布的全链路工具支持。平台搭载通用智能数字人生成、AI三维重建、全栈虚拟化创作三大核心功能,面向有数字化展示、虚拟内容生产、企业虚拟化转型需求的企业及创作者,可应用于品牌虚拟发布会制作、数字员工打造、虚拟展厅搭建、数字内容IP孵化、线上虚拟活动策划等多个场景,帮助用户自主完成元宇宙内容的定义与发布,降低虚拟内容生产的综合成本。

MimicTalk
MimicTalk是基于神经辐射场(NeRF)技术的个性化三维说话面部生成工具,核心定位是为AI内容创作、数字人开发等领域提供高效的人脸合成解决方案。核心功能包括个性化说话风格模仿、静态-动态混合面部适配、上下文关联的音频驱动面部运动生成,可支持用户在短时间内生成符合特定人物外观和说话习惯的动态面部视频。目标用户涵盖计算机视觉研究人员、数字人内容创作者、影视动画制作人员、AI产品开发人员等,可应用于学术研究实验、虚拟数字人制作、影视动画面部动画生成、短视频内容创作等多种场景。
DimensionX
DimensionX是基于视频扩散模型的科研类场景生成工具,核心定位是实现从单张图像到3D、4D场景的自动化生成。它支持用户上传单张图片生成多视角一致的三维场景,可根据文本提示词调整场景动态效果,生成的内容可直接导出兼容主流3D建模软件的格式。该工具面向计算机视觉研究人员、3D内容创作者、游戏开发人员等群体,可用于学术研究中的场景重建实验、动画前期的场景快速搭建、元宇宙内容的原型制作等场景。
VisFusion
VisFusion是一款基于计算机视觉与深度学习技术的在线3D场景重建工具,核心定位是帮助用户从普通视频数据中快速生成高精度三维环境模型。其核心功能包括视频帧自动特征提取、多视角点云融合建模、模型纹理自动映射,支持主流视频格式上传,无需专业三维扫描设备即可完成场景还原。目标用户覆盖计算机视觉研究人员、三维建模从业者、AR/VR内容开发者、建筑测绘人员等,可应用于数字孪生场景搭建、文化遗产三维存档、虚拟场景内容制作、室内外空间测绘等多个场景,降低了3D场景建模的技术门槛。
3D AI Studio
3D AI Studio是基于人工智能技术的在线3D内容生成平台,核心定位是为用户提供低门槛的3D模型创建服务。平台支持文本生成3D模型、2D图像转3D模型、自动生成物理级真实纹理三大核心功能,可导出FBX、GLB、USDZ等主流3D格式,适配各类创作工具需求。目标用户覆盖游戏设计师、影视动画从业者、AR/VR开发者、产品设计师、数字艺术创作者等群体,可应用于游戏资产制作、元宇宙场景搭建、产品3D展示、数字藏品创作、AR交互内容开发等多个场景,帮助用户减少手动建模的工作量,降低3D内容的生产门槛。

Qlone
Qlone是一款面向3D内容创作需求用户的3D扫描工具平台,核心定位是降低3D模型制作的技术门槛,支持用户通过移动设备完成实物的3D数字化采集。平台核心功能包括移动端实物3D扫描、3D模型编辑优化、多平台导出适配,支持AR展示、3D打印、模型二次创作等多种需求。目标用户覆盖文创从业者、教育工作者、电商运营人员、3D打印爱好者等,可应用于文创产品数字化存档、教学教具3D化制作、电商商品3D展示搭建、3D打印原型制作等多种场景,搭配与全球知名3D平台的无缝集成能力,帮助用户便捷完成从实物到数字3D模型的全流程处理。

Movmi
Movmi是一款基于AI技术的云端动作捕捉工具,核心定位是为内容创作者与开发人员提供无需高端硬件的人体动作捕捉解决方案。其核心功能包括通过普通2D图像或视频完成人体动作捕捉、支持多人场景动作识别、配套可商用角色素材库,用户无需购置动捕服、深度摄像头等专业设备,仅需普通拍摄设备采集的素材即可完成动捕流程。目标用户覆盖3D动画制作者、游戏开发者、虚拟内容创作者、影视后期人员等群体,可应用于独立动画项目制作、游戏角色动作导入、虚拟主播动作驱动、短视频3D内容创作等多个场景,输出的FBX格式文件可适配各类主流3D创作环境。

Tafi Avatar
Tafi Avatar是一款AI文本转3D角色生成平台,核心定位是帮助用户通过文本描述快速生成可商用的定制3D角色资产。平台内置数百万款高质量3D素材资源,支持用户通过文本提示词直接生成3D角色,还能对角色的外貌、服饰、配饰等细节进行精细化调整,生成的角色支持导出为多种主流3D格式。目标用户覆盖游戏开发者、动画制作人、内容创作者、虚拟主播运营者、元宇宙项目开发者、3D设计新手等群体,可应用于游戏角色开发、动画内容制作、虚拟形象定制、元宇宙场景搭建、3D内容原型设计等多种场景,无需用户具备专业3D建模经验即可完成操作。

Chupa
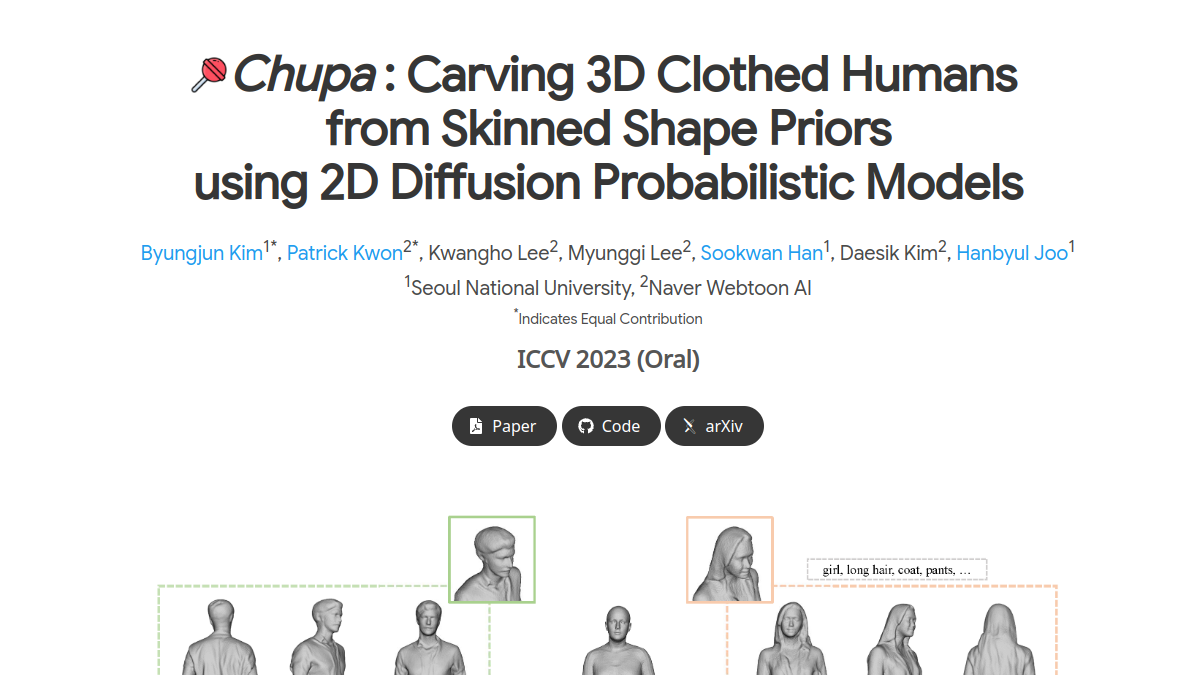
Chupa是面向3D内容创作领域的3D人体生成工具,由相关实验室研发推出,核心是结合扩散模型与神经渲染技术搭建的自动化生成流水线。其核心功能包括基于SMPL-X网格生成高质量人体网格、支持未见过的人体姿态泛化生成、输出具备高还原度的3D人体资源。目标用户覆盖3D建模师、游戏开发者、动画制作人员、数字人创作者、影视特效从业者以及计算机视觉相关研究人员,可应用于游戏角色批量制作、动画人体资产快速生成、数字人内容创作、学术研究人体数据集构建等多个场景,帮助用户降低3D人体建模的时间成本。

GenXD
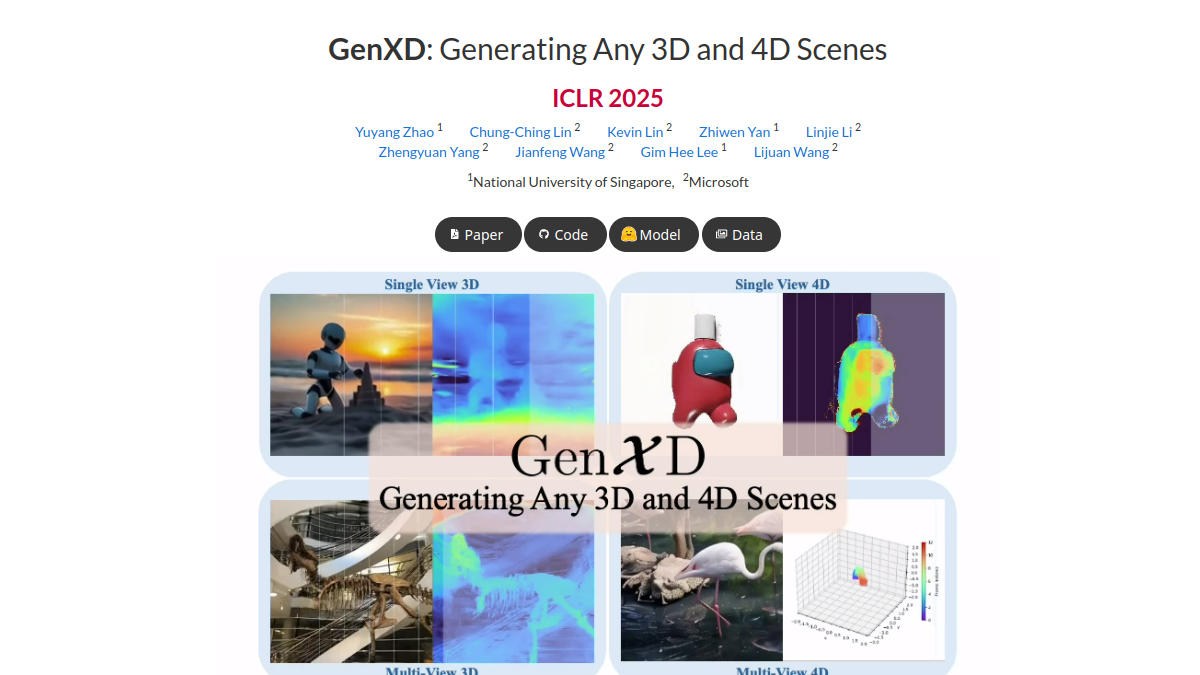
GenXD是一个专注于3D与4D场景生成的开源研究框架,核心面向计算机视觉领域的研究者、开发人员及相关方向学生,旨在解决当前4D生成领域数据稀缺、运动与相机参数耦合的行业问题。核心功能包含专业4D数据策划流程,可从普通视频中提取相机姿态与物体运动强度参数;自研CamVid-30K大规模现实世界4D场景数据集,覆盖多类真实场景样本;多视图-时间模块,可实现相机与物体运动参数的分离学习,兼容3D与4D两类数据训练。目标用户覆盖高校计算机视觉实验室研究员、3D内容开发工程师、元宇宙场景搭建人员、AI生成算法开发者、数字孪生项目从业者、图形学相关专业学生等。使用场景包括学术研究中4D生成算法的基准测试、元宇宙项目中动态场景的批量生成、数字孪生项目的真实场景复刻、3D内容创作中的多视图一致素材生成等。

LucidFusion
LucidFusion是一款专注于3D高斯生成的端到端前馈框架工具站点,核心定位为帮助用户基于多视图图像快速完成3D内容重建。其核心功能包括多视图图像3D高斯生成、相对坐标图几何特征对齐、单图转3D流程适配三大模块,面向计算机视觉研究者、3D内容创作者、游戏开发人员等群体,可应用于3D资产生产、学术实验验证、数字孪生场景建模等多个场景,无需预先对输入图像进行摆姿势校准,即可处理稀疏、任意数量的多视图输入,输出高分辨率3D高斯资源。
The Matrix
The Matrix是由阿里巴巴集团、香港大学、滑铁卢大学和Vector Institute共同研发的AI数字宇宙项目,核心定位是通过前沿AI技术搭建沉浸式交互数字空间,模糊现实与虚拟内容的边界。核心功能包括帧级精度的用户实时交互、高画质视觉效果生成、开放式场景无限生成三大模块,面向内容创作者、游戏开发者、虚拟场景设计师、AI技术研究者等群体,可应用于虚拟内容制作、交互实验场景搭建、数字艺术创作、虚拟活动场地构建等多个场景,帮助用户突破传统视频生成模型的能力限制,实现自定义数字空间的探索与创作。