

TRELLIS
TRELLIS是一款基于统一结构化潜在表示与修正流变换器架构的原生3D生成模型服务平台,核心面向3D内容创作相关从业者与研究人员,提供多条件驱动的3D资产生成、多格式导出、局部编辑等功能。用户可通过文本描述或参考图像快速生成符合需求的3D模型,支持游戏开发、元宇宙场景搭建、工业设计原型制作、影视内容创作等多个场景的3D内容生产需求,降低3D资产制作的技术门槛,缩短创作周期。

MV-Adapter
MV-Adapter是面向多视图图像与3D生成场景的技术方案官网,核心为基于适配器架构的预训练文本到图像模型增强方案。核心功能包括参数高效的预训练模型适配能力,可在不修改原有T2I模型结构的前提下注入3D知识;统一条件编码器支持相机参数、几何信息的无缝整合;兼容Stable Diffusion XL等主流生成模型,可实现768分辨率的多视图内容生成。目标用户覆盖计算机视觉研究人员、AIGC技术开发者、3D内容制作从业者、数字内容创作团队等,可用于学术研究中的3D生成算法迭代、工业场景下的多视图素材批量生产、数字孪生项目的纹理映射制作等场景,无需重新训练完整大模型即可快速构建多视图生成能力。

SceneScript
SceneScript是Meta Reality Labs研究团队推出的3D场景重建技术专题页面,核心定位是展示前沿AI驱动的3D场景理解与重建技术研究成果。页面核心功能包括技术原理解析、实验效果展示、研究论文资源下载、应用场景落地说明,面向计算机视觉研究人员、3D内容创作者、AR/VR领域开发者、元宇宙相关从业者,可用于学术研究参考、3D开发技术选型、AR/VR场景构建方案调研等多种场景,帮助相关从业者了解单张图像生成高精度3D模型的技术路径与落地可能性。
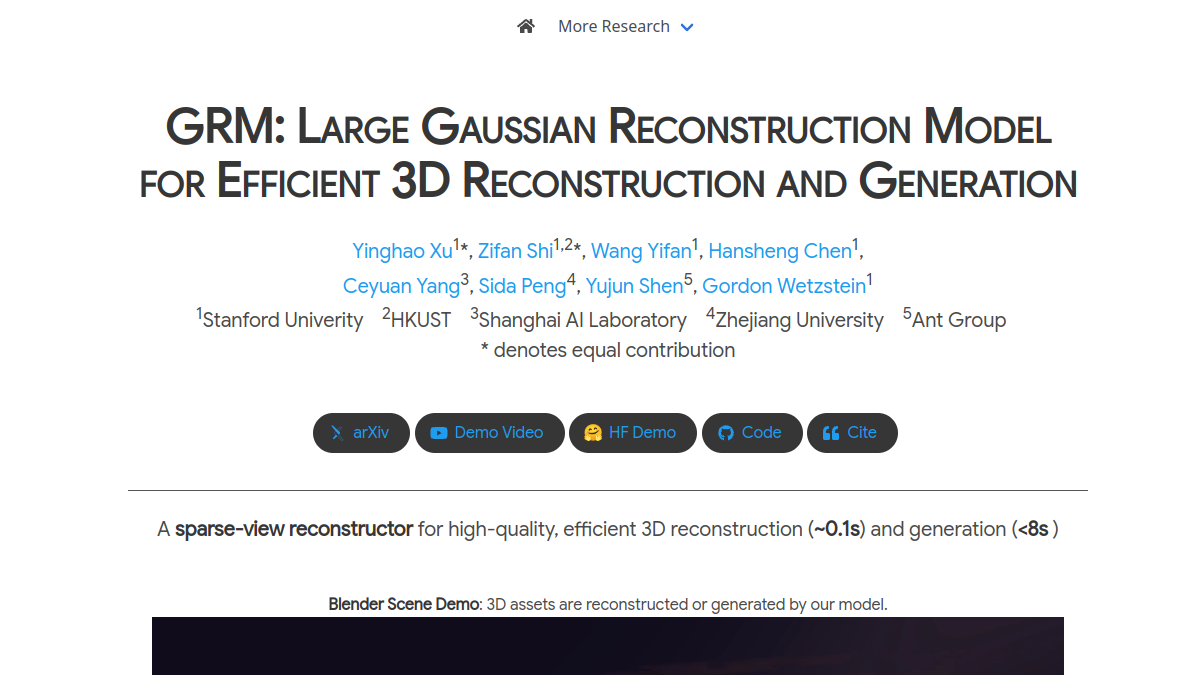
GRM
GRM是面向3D内容创作领域的大规模重建与生成模型项目站点,核心提供稀疏视图图像到3D资产的快速转换能力,支持基于Transformer架构的多视图信息融合,可对接多视图扩散模型实现文本到3D、图像到3D的生成任务。站点面向3D建模从业者、计算机视觉研究人员、元宇宙内容开发者、游戏制作人员、数字孪生技术人员、动画创作者等群体,可应用于小规模3D资产快速重建、学术研究算法效果比对、3D内容批量生成测试、多模态3D生成场景落地验证等多个场景,为3D内容生产的效率提升提供技术方案参考与效果演示。

PanoHead
PanoHead是专注于360°全头部3D合成的学术研究项目站点,核心定位为面向计算机视觉领域的3D人头生成技术展示与资源输出平台。核心功能包括360°几何感知的全头合成技术演示、非结构化图像训练方案说明、视图一致的3D头部生成效果展示。目标用户覆盖计算机视觉研究人员、3D内容开发者、数字人制作从业者、高校图形学相关专业师生。可应用于数字人模型快速生成、影视虚拟角色原型制作、VR/AR虚拟头像定制、人脸相关算法研究验证等场景,帮助用户降低3D头部模型的制作门槛,提升生成内容的视角一致性与几何细节精度。

Lixel CyberColor
Lixel CyberColor(简称LCC)是XGRIDS公司研发的3D场景创建技术产品,聚焦于高精度3D重建与智能空间计算领域。核心功能包括基于Multi-SLAM与3DGS技术的超逼真大型3D模型自动生成、90%模型体积压缩的轻量化处理、多平台插件与SDK适配。目标用户覆盖游戏开发从业者、影视内容制作团队、虚拟现实内容创作者、城市规划设计师、工业仿真工程师等群体,可应用于开放世界游戏场景搭建、影视虚拟拍摄场景还原、VR/AR内容场景构建、城市数字孪生模型制作、工业产线三维仿真等多种工作场景,为3D内容生产提供技术支撑。

SurMo
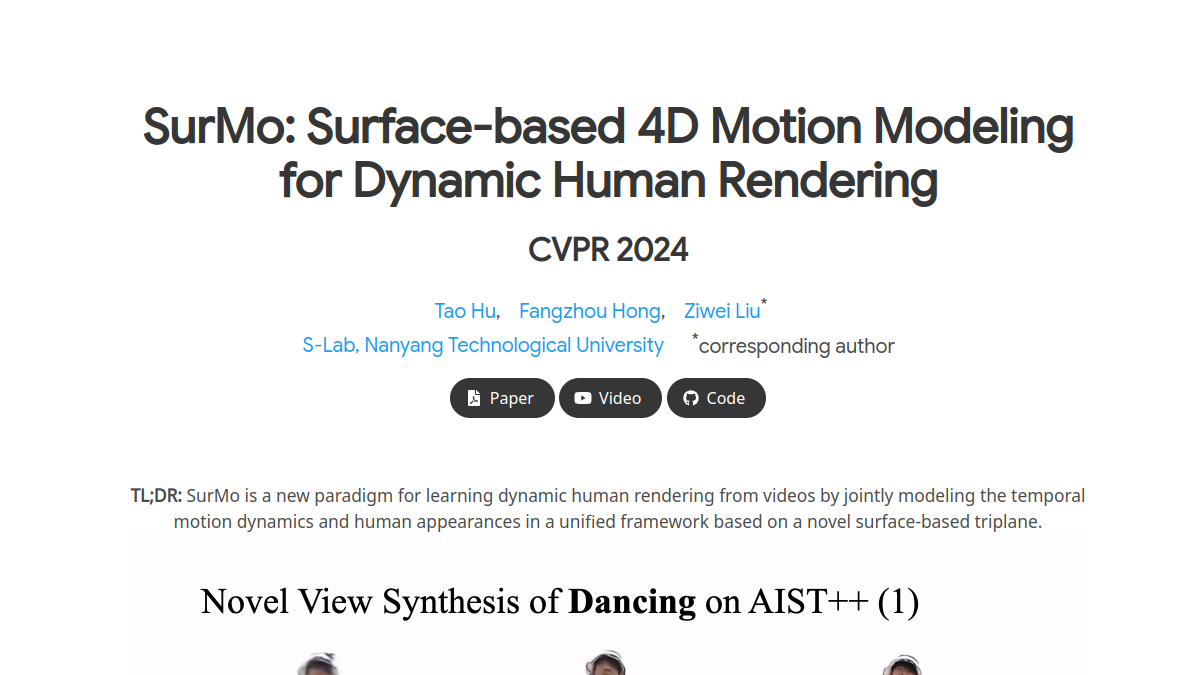
SurMo是面向动态人体渲染领域的研究项目展示平台,核心定位为呈现创新的动态人体渲染范式技术成果。平台提供完整的技术原理说明、实验效果对比Demo、相关论文下载等核心功能,同时支持用户在线查看不同运动场景下的人体渲染输出样例。目标用户覆盖计算机图形学研究人员、数字内容创作者、动画制作从业者、三维交互开发工程师等群体,可应用于学术研究参考、影视动画角色制作、虚拟数字人渲染、运动捕捉效果优化等多个场景,帮助相关从业者了解动态人体渲染领域的前沿技术路径与实际应用效果。

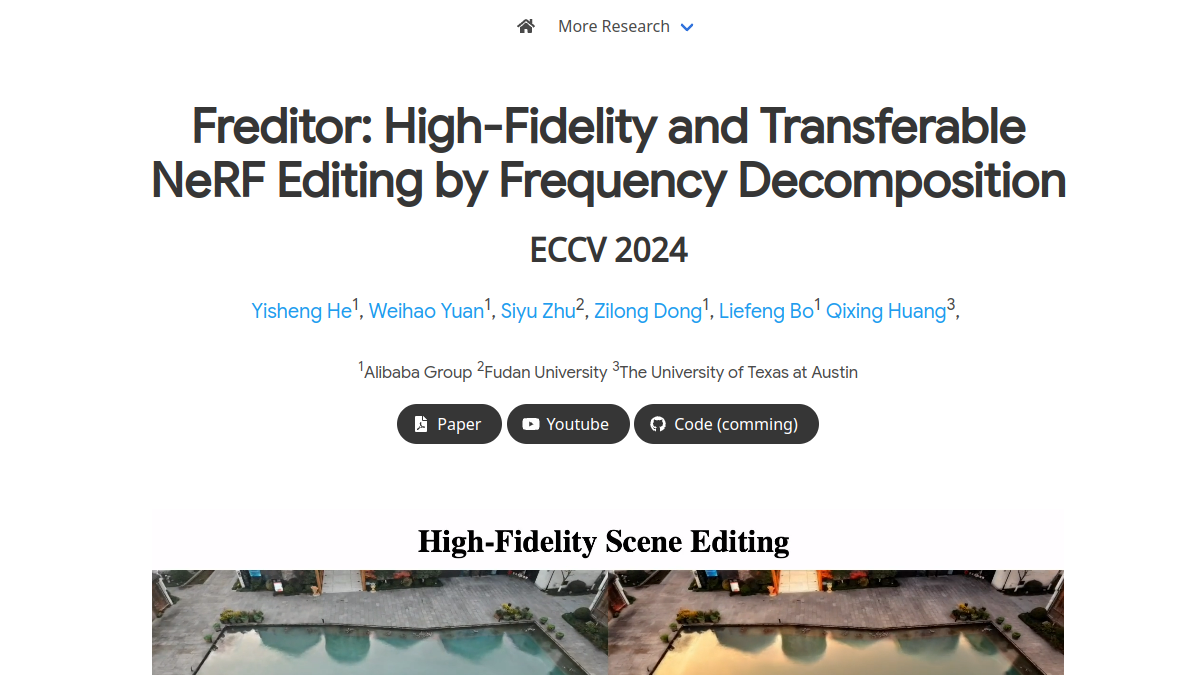
Freditor
Freditor是基于频域分解技术的NeRF场景编辑工具,核心定位是为3D内容创作者、计算机视觉研究者提供高保真的神经辐射场编辑能力。核心功能包括NeRF场景频域拆分、低频区域风格迁移、高频细节保留集成、编辑强度实时调控,可适配多种不同类型的NeRF预训练场景。目标用户覆盖高校计算机视觉方向研究人员、3D内容制作团队、数字孪生项目开发人员、元宇宙场景创作者、AI生成内容开发者、计算机图形学爱好者。使用场景包括学术研究中NeRF编辑效果对比实验、3D场景风格化改造、数字孪生场景外观调整、元宇宙虚拟空间自定义设计、NeRF编辑算法性能验证等。

DiffHuman
DiffHuman是一个面向3D人体重建领域的学术项目展示网站,核心呈现基于扩散模型的概率式光度逼真3D人体重建方案。该网站支持单张RGB图像输入的3D人体分布预测、多采样高细节人体模型生成、加速推理效果对比三大核心功能,主要服务于计算机视觉研究人员、3D内容开发者、动画制作从业者、数字人研发团队等群体,可应用于学术研究验证、动画角色快速建模、数字人素材生成、3D重建算法效果比对等多种场景,帮助用户直观了解非确定性3D人体重建技术的实现逻辑与实际应用效果。
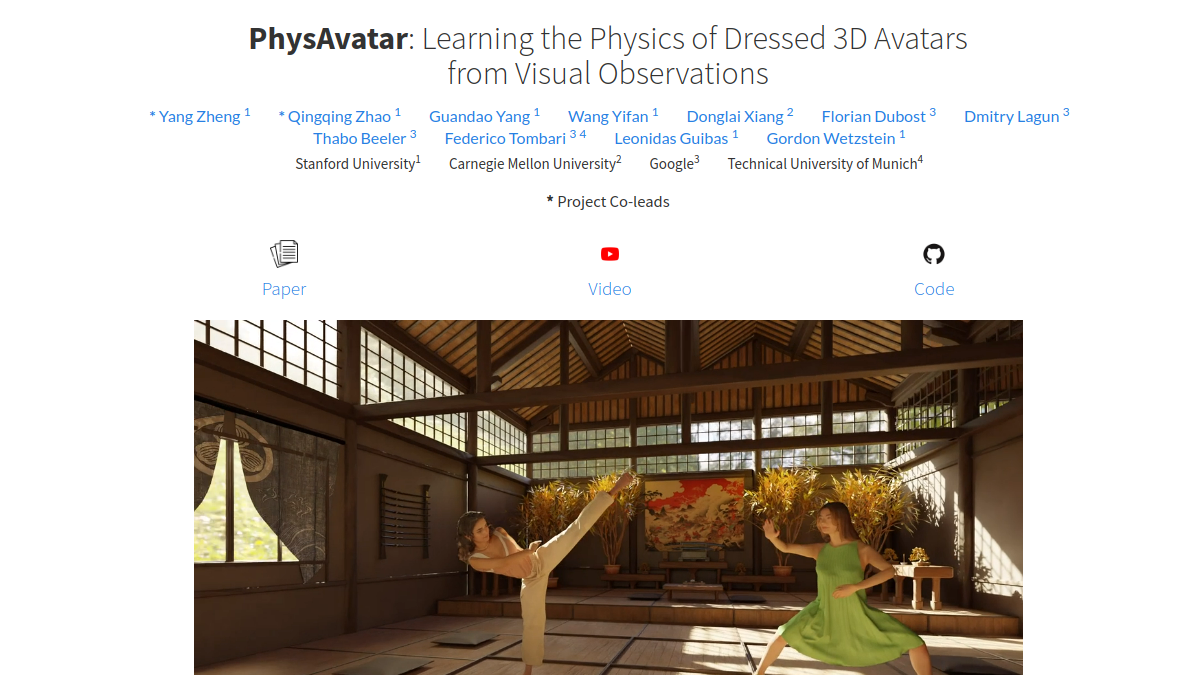
PhysAvatar
PhysAvatar是一个结合逆向渲染与逆向物理技术的研究型框架,核心作用是从多视角视频数据中自动提取人体相关的三维与物理属性。其核心功能包括多视角视频驱动的人体属性估计、服装物理参数逆向求解、跨场景新视角内容渲染三类,主要面向计算机图形学研究者、数字内容创作者、虚拟形象开发人员等群体,可应用于虚拟人制作、影视动画角色建模、数字服装仿真等多个专业场景,帮助用户降低高精度人体虚拟形象的制作成本,提升虚拟形象在不同场景下的渲染真实度。
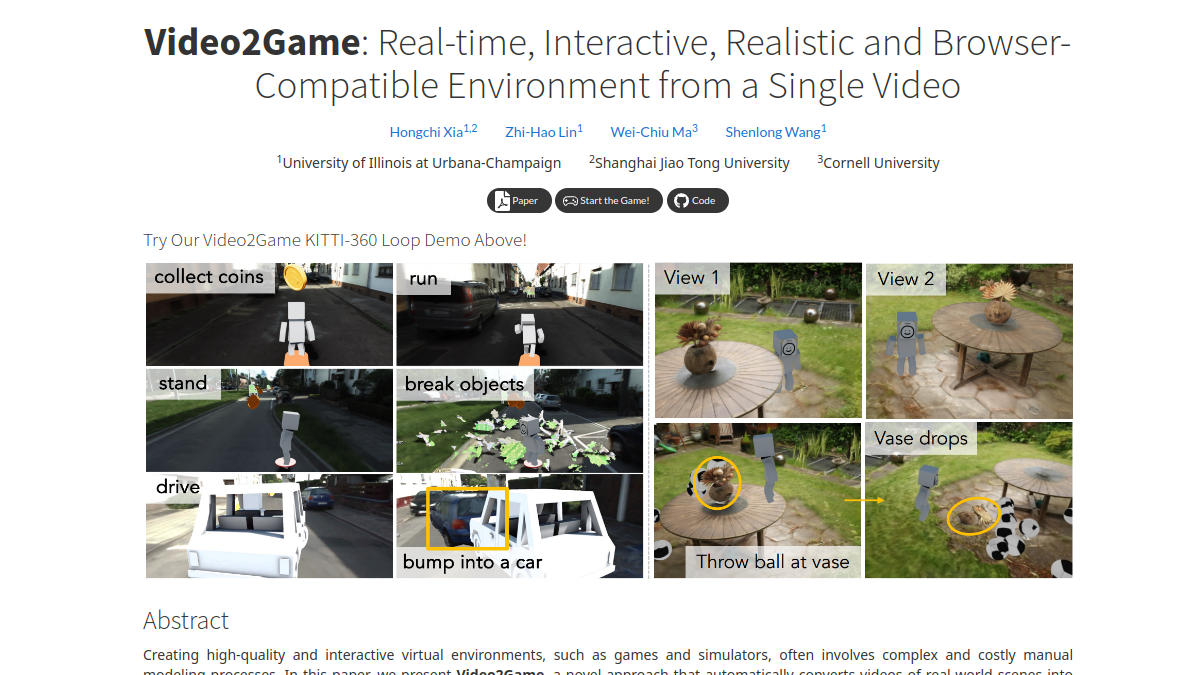
Video2Game
Video2Game是一款专注于视频转虚拟互动环境的在线技术工具,核心定位是将普通视频素材转化为支持实时交互的3D虚拟场景。其核心功能包括基于NeRF的3D场景重建、游戏引擎兼容的动力学网格生成、神经纹理UV映射处理三类,面向3D内容创作者、游戏开发人员、虚拟场景设计从业者、科研人员等群体,可应用于独立游戏场景快速搭建、虚拟展厅内容制作、VR场景内容生成、数字孪生场景还原等多种场景,无需复杂的专业建模流程即可完成从二维视频到可交互3D环境的转换,输出内容可直接在主流浏览器中正常加载运行。
Avatic
Avatic是专注于半写实风格3D头像定制的服务平台,核心定位是为用户打造适配多场景的个性化虚拟身份。平台支持用户上传照片生成专属3D头像,所有头像均由专业3D艺术家使用Blender、Photoshop等工具手工制作,带有独特的玩具质感。同时平台提供免费修改、不满意退款等保障服务,目标用户覆盖游戏玩家、社交平台用户、职场人士、内容创作者等群体,可满足游戏身份设置、社交账号头像替换、虚拟会议形象展示、内容创作IP打造等多场景使用需求,帮助用户在保护隐私的同时塑造独特的线上个人标识。

PSHuman
PSHuman是专注于单张图像3D人体重建的技术框架展示站点,核心基于多视图扩散模型与显式重构技术,可从普通单张人像照片生成高还原度的3D人体模型。站点核心功能包含单图3D人体重建演示、重建效果可视化对比、技术论文与开源代码资源下载,主要面向计算机视觉领域研究者、3D内容创作者、游戏动画开发人员等群体,可应用于数字人制作、影视角色建模、人体姿态分析等多个场景,无需多视角拍摄设备即可完成人体3D数据的快速生成,降低3D人体资源制作的前期采集成本。
CAT4D
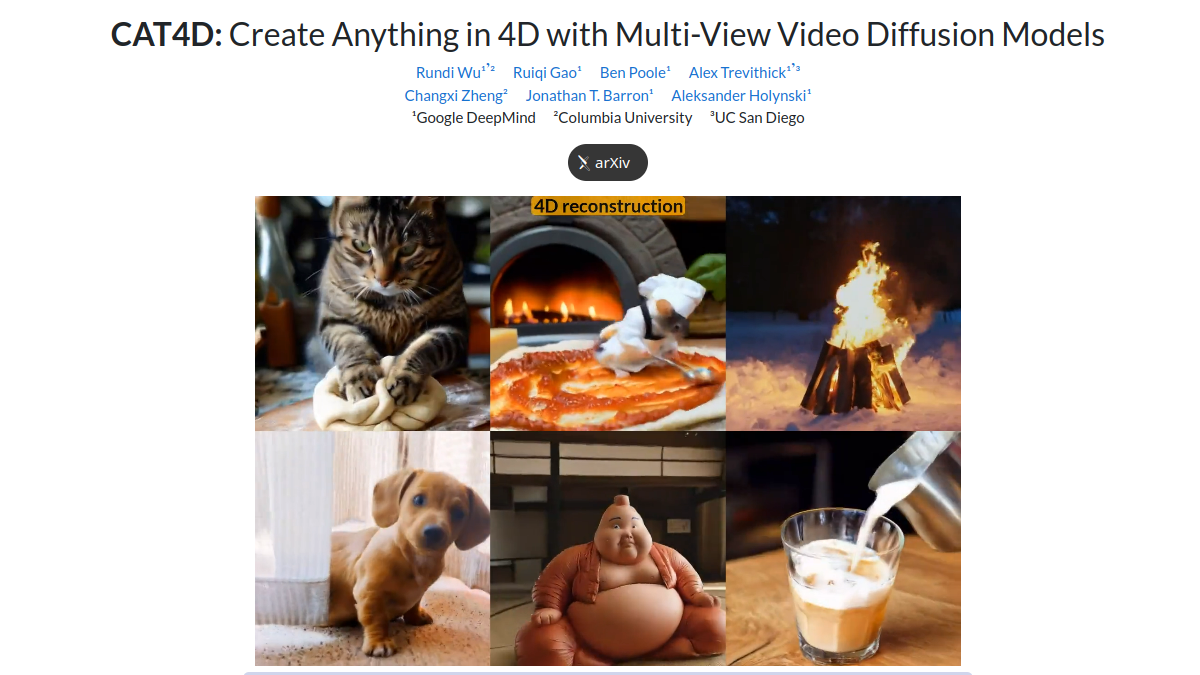
CAT4D是由Google DeepMind、哥伦比亚大学与加州大学圣地亚哥分校联合研发的4D场景生成技术官方站点,核心定位是为科研人员、内容创作者提供基于单目视频的4D场景重建服务。站点核心功能包括单目视频多视角生成、动态3D场景时序重建、4D结果可视化预览三类,目标用户覆盖计算机视觉研究者、AR/VR内容开发者、三维建模从业人员等,可应用于旧视频资源4D化转换、AR场景素材制作、动态三维资产生成等多个场景,帮助用户仅通过普通单视角视频即可完成包含时间维度的4D场景搭建,无需依赖多相机阵列等专业采集设备。
CHOIS
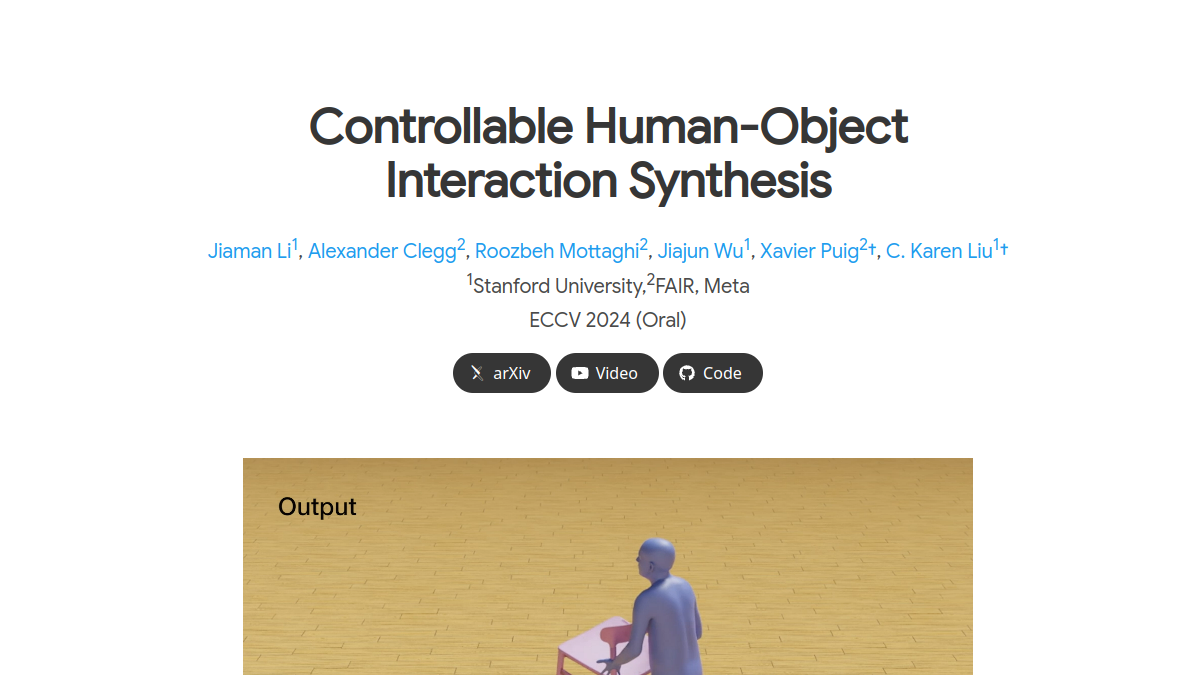
CHOIS全称为Controllable Human-Object Interaction Synthesis,是面向人机交互动作生成领域的开源技术项目,核心定位是可控的人与物体交互动作合成工具。核心功能包括根据自然语言描述生成对应的人与物体协同运动序列、结合初始状态与稀疏路径点约束输出符合物理规则的交互动作、通过接触约束保障手物交互与地面支撑的合理性。目标用户覆盖计算机图形学研究者、游戏动画开发人员、虚拟场景制作从业者、机器人运动规划研发人员等,可应用于3D动画内容制作、虚拟数字人交互动作开发、机器人行为模拟训练、元宇宙场景交互内容搭建等场景,帮助用户降低复杂交互动作的制作与研发成本。

BLENDERGPT
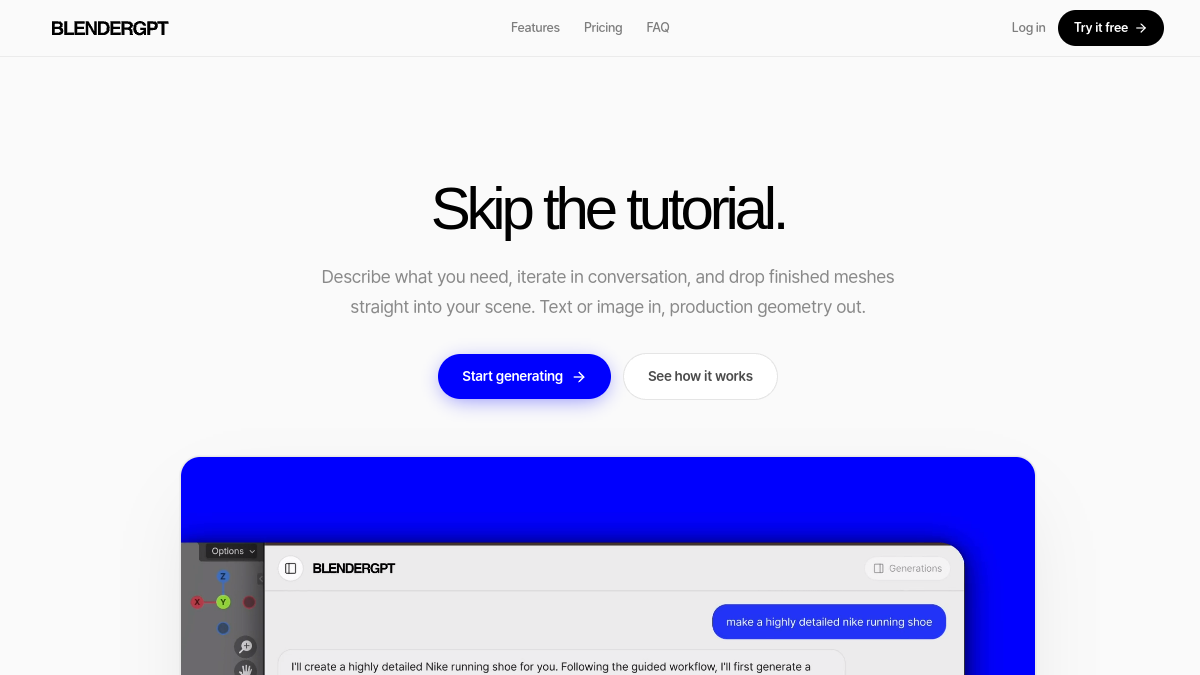
BLENDERGPT是一款专注于3D模型生成的AI工具网站,核心定位是通过自然语言或图像提示快速生成可直接用于Blender的3D资产。核心功能包括文本生成3D模型、图像转3D模型、自动生成带纹理的网格文件,支持直接导入Blender或下载通用格式源文件。目标用户覆盖3D设计师、游戏开发者、动画制作人员、建筑可视化从业者等相关创作人群。使用场景涵盖游戏角色原型制作、动画场景3D资产搭建、建筑效果图辅助建模、产品设计3D原型快速生成、数字藏品3D素材创作等多个领域,帮助用户降低3D建模的技术门槛,减少重复建模的时间投入。
The Language of Motion
The Language of Motion是斯坦福大学研究团队推出的多模态语言模型框架,核心定位是统一3D人体动作对应的言语与非言语语言体系。该框架支持文本、语音、动作三类模态数据的联合理解与生成,可实现手势生成、动作情感预测等跨模态任务,还具备低训练数据需求的特性。目标用户覆盖游戏内容开发者、影视动画制作人员、虚拟现实内容创作者、人机交互研究人员、虚拟角色开发工程师、多模态AI研究学者等群体,可应用于游戏NPC自然交互动作设计、影视虚拟角色多模态表达制作、VR场景中虚拟人物交流逻辑搭建、人机交互系统拟人化交互逻辑开发等场景,为数字虚拟角色的自然交流能力提供技术支撑。
CAP4D
CAP4D是基于可变形多视图扩散模型打造的4D人像化身生成技术平台,核心面向数字内容创作、3D建模相关从业者与研究人员。平台支持多参考图像输入生成不同视角、表情的人像画面,可将生成内容适配为可控4D化身,同时提供开源代码供技术研究与二次开发。用户可在游戏角色制作、虚拟主播形象定制、VR场景数字人搭建等场景中使用该技术,降低4D数字人创作的技术门槛,提升数字人建模的还原度与渲染效率。
GenEx
GenEx是一款专注于单图转360°3D可交互世界的AI工具,核心定位为降低3D场景创建门槛的内容生成平台。其核心功能包括单张图像输入生成完整360°3D场景、生成场景可自由交互探索、支持导出场景数据用于二次开发。主要面向游戏开发者、内容创作者、VR/AR从业者、AI研究人员等群体,可应用于游戏原型快速搭建、虚拟展览内容制作、VR场景素材生成、具身AI训练场景构建等多种场景,无需复杂的3D建模基础即可获得可交互的3D空间内容。

Prompt Depth Anything
Prompt Depth Anything是聚焦于度量深度估计领域的技术展示与资源开放平台,核心定位为高分辨率、高精度深度估计技术的落地验证和成果共享站点。平台支持4K级度量深度估计在线演示,开放ScanNet++增强深度注释数据集下载,同时提供可扩展训练数据管道的技术文档。目标用户覆盖计算机视觉研究人员、3D内容开发从业者、机器人技术研发人员、移动端AR应用开发人员等,可应用于学术研究验证、3D重建项目落地、机器人感知模块开发、AR场景交互优化等多个场景,帮助相关从业者降低深度估计技术的落地门槛。