
NotebookLM
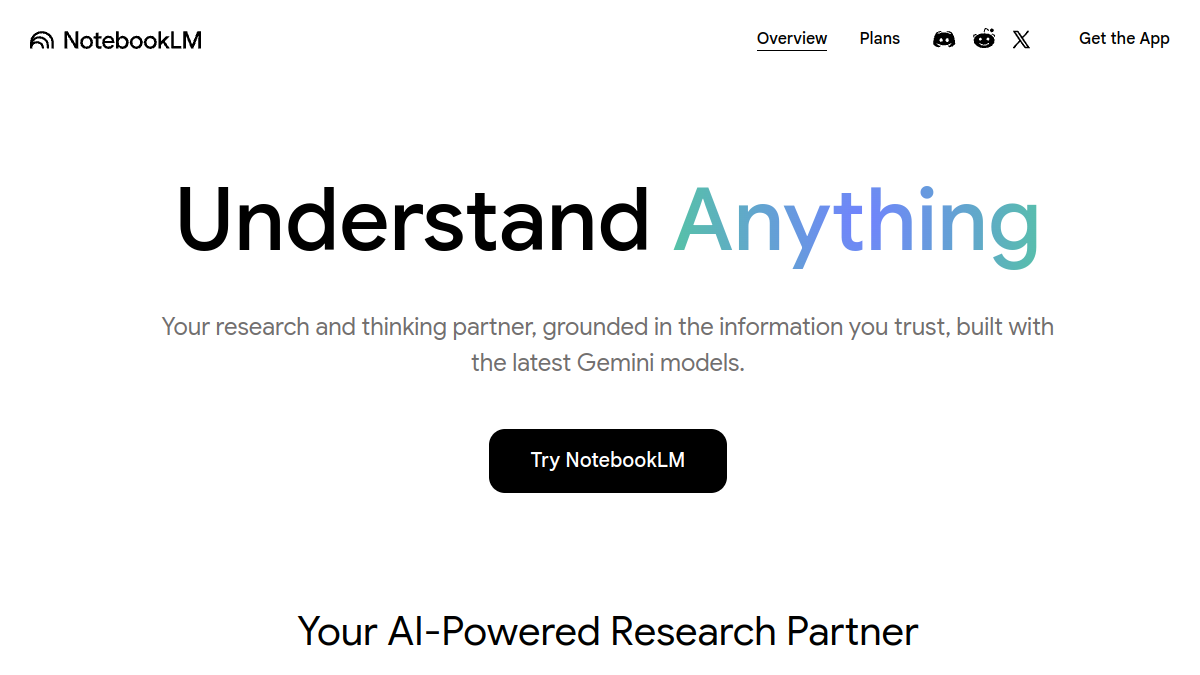
Google推出的AI研究助手平台,支持上传文档、网页、视频等多种资料源,AI自动分析并生成结构化笔记、摘要和问答。平台的核心功能包括自动生成文档摘要、基于上传内容回答问题、创建学习指南和FAQ、以及AI音频概述功能(将文档内容转化为播客式对话)。NotebookLM的独特优势在于所有回答均基于用户上传的资料源生成,并提供引用出处,确保信息准确可追溯。适合学生、研究人员和知识工作者高效处理大量文献资料。

Ego-Exo4D
Ego-Exo4D是专注于人类技能活动研究的多模态多视角视频数据集平台,核心定位为计算机视觉与多模态感知领域的研究提供标准化的训练与测试数据支撑。平台核心功能包含多视角同步视频数据供给、多模态传感器原始数据开放、配套自然语言标注资源下载,同时设置了对应基准挑战赛道。目标用户覆盖计算机视觉研究人员、多模态感知算法开发人员、人机交互领域学者、动作识别方向学生等群体,可应用于动作理解模型训练、多视角感知算法验证、人机交互系统研发、日常活动语义建模等多种学术与技术开发场景。
AI Risk Repository
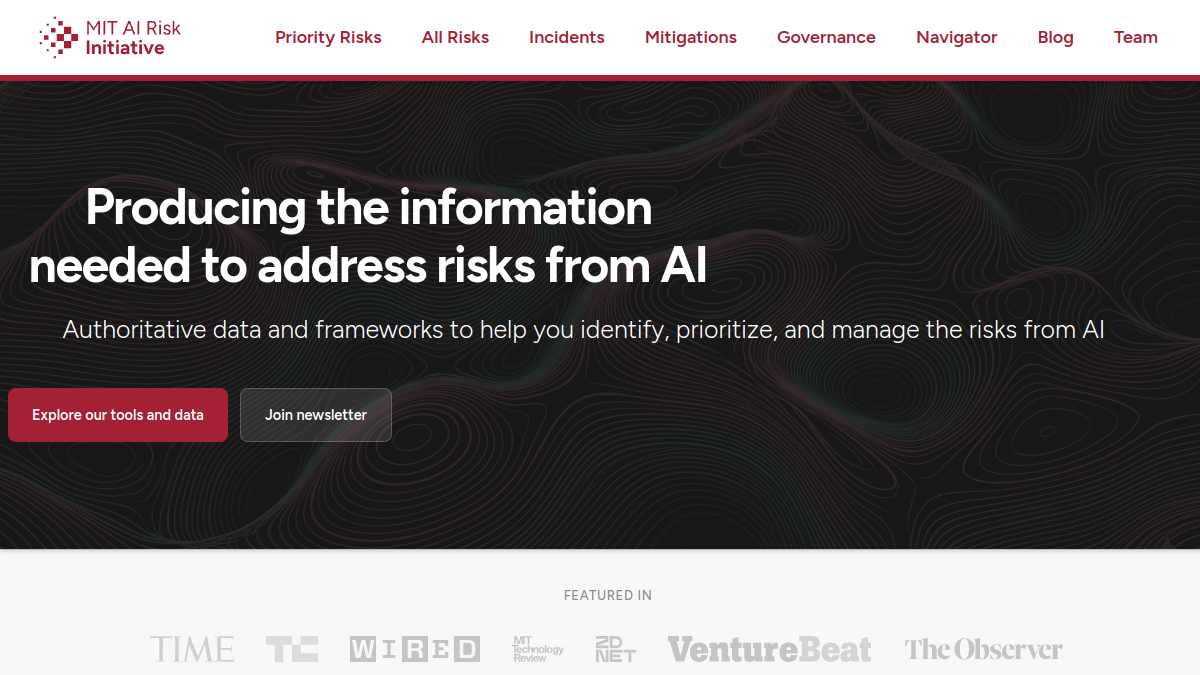
AI Risk Repository是麻省理工学院推出的AI风险公开数据库,当前收录超700个已发生或被验证的AI风险案例,按风险成因、所属领域、影响范围三个维度进行标准化分类整理。平台支持按关键词检索、多维度筛选、风险关联溯源等功能,目标用户覆盖AI领域研究人员、技术开发者、企业风控人员、AI审计师、政策制定者及高校相关专业师生。可应用于AI伦理研究、产品风险前置评估、行业监管政策制定、高校课程案例教学、AI系统审计校验等多个场景,为AI安全相关工作提供结构化的案例参考框架。

ALIEN
ALIEN是一个基于CUDA技术开发的物理与渲染引擎结合的人工生命仿真程序,核心定位为人工生态系统模拟与进化仿真研究平台,支持自定义人工生命行为规则、多维度生态环境参数调整、进化过程可视化追踪三大核心功能,面向计算生物学研究者、AI进化算法开发者、计算机图形学爱好者、高校相关专业师生等群体,可应用于人工生命演化实验、群体智能行为研究、进化算法验证、数字生态系统可视化演示等多种场景,项目完全开源,遵循BSD-3-Clause许可协议,用户可自由修改与分发代码。
MATHVERSE
MATHVERSE是由香港中文大学发起的多模态大语言模型数学能力评估项目,核心定位为提供标准化的视觉数学问题评测基准,帮助开发者测试模型处理含图表类数学题的能力。平台提供包含不同难度、不同题型的视觉数学测试数据集,支持模型输出结果的自动化比对与多维度评分,还可生成可视化的能力短板分析报告。目标用户覆盖大模型研发人员、AI性能评测从业者、高校人工智能方向研究人员、数学教育科技开发者等,可用于多模态大模型迭代优化、学术研究实验验证、数学类AI产品能力测试等场景。
SpatialVLM
SpatialVLM是谷歌DeepMind研发的空间视觉语言模型展示站点,核心定位是呈现可实现定量空间关系理解与推理的多模态模型能力。平台支持空间视觉问答测试、空间推理路径可视化、机器人控制场景效果演示三类核心功能,面向AI研究者、机器人开发工程师、多模态模型学习者、计算机视觉领域从业者,可用于空间推理类模型性能验证、机器人导航逻辑预测试、多模态模型训练方向参考等场景,帮助用户直观了解空间视觉语言模型的技术特点与落地可能性。
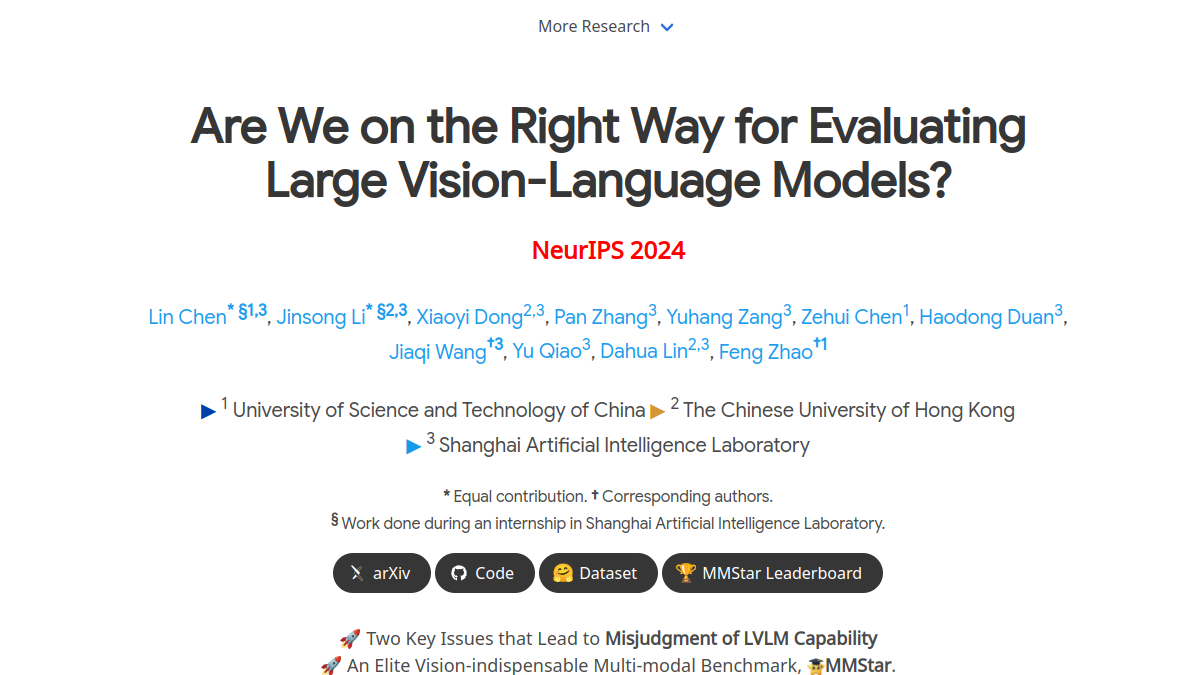
MMStar
MMStar是面向大型视觉语言模型多模态能力评估的基准测试集平台,核心定位是为多模态模型研发领域提供标准化、低偏差的能力评测方案。平台包含1500个经过人工筛选的视觉语言样本,覆盖6类核心能力与18个细分评估维度,同时提供传统准确率之外的两套新增评估指标,可帮助研究者识别模型数据泄露风险、量化多模态训练带来的实际性能增益。其目标用户涵盖AI领域研究人员、多模态模型开发团队、高校人工智能相关专业师生,可应用于模型迭代效果验证、学术研究实验评测、模型公开能力对比等多种场景。
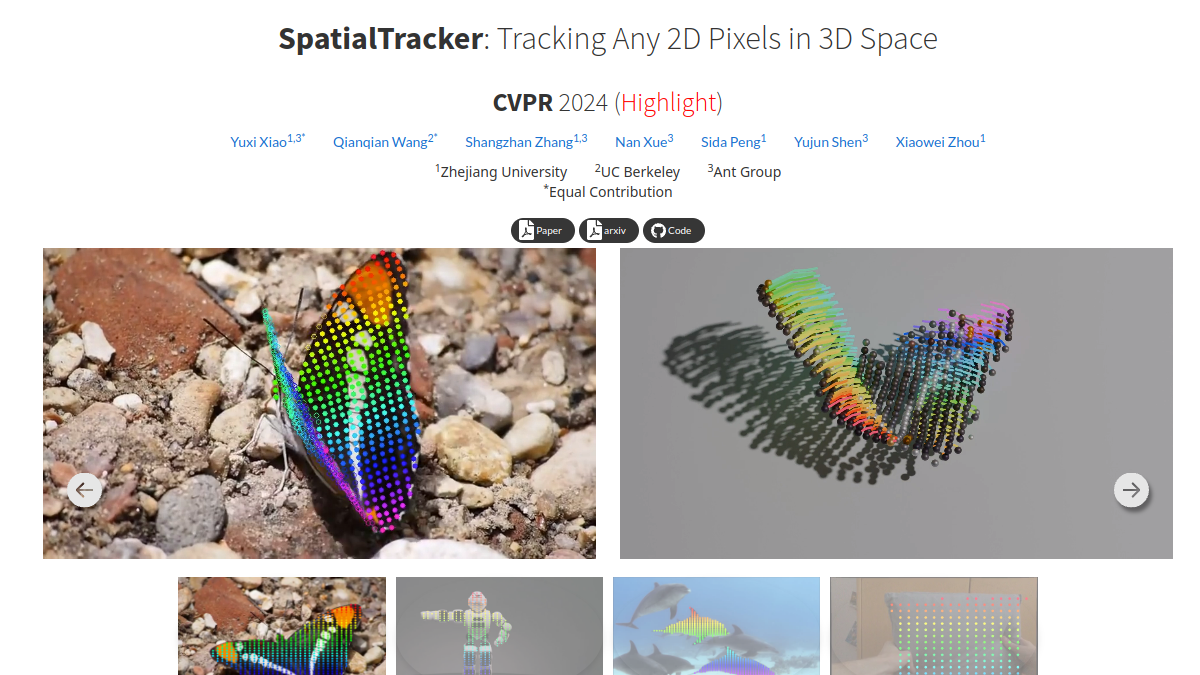
SpatialTracker
SpatialTracker是CVPR 2024收录的3D空间视频像素运动追踪研究成果的展示站点,核心定位为提供3D密集像素运动恢复技术的演示与验证工具。站点核心功能包含3D像素运动轨迹可视化、不同追踪算法效果对比、自定义测试视频上传分析三类,主要面向计算机视觉领域研究人员、3D视觉算法开发人员、高校相关专业师生、视频动效制作从业者,可用于学术研究验证、算法性能对比、3D动效制作参考、课程实践教学等场景,帮助用户直观了解3D空间下密集像素运动追踪的技术效果与应用潜力。

SPDL
SPDL是Meta Reality Labs推出的可扩展高性能AI数据加载解决方案,核心定位是解决大规模AI模型训练中的数据加载瓶颈问题,核心功能包括基于线程的并行数据加载、Free-Threaded Python兼容适配、无缝对接现有AI训练框架。主要面向AI算法研发人员、大模型训练工程师、机器学习框架开发者,可应用于计算机视觉、自然语言处理、多模态模型等各类AI训练场景,帮助优化训练流程,提升GPU资源利用率。

Diffusion-Vas
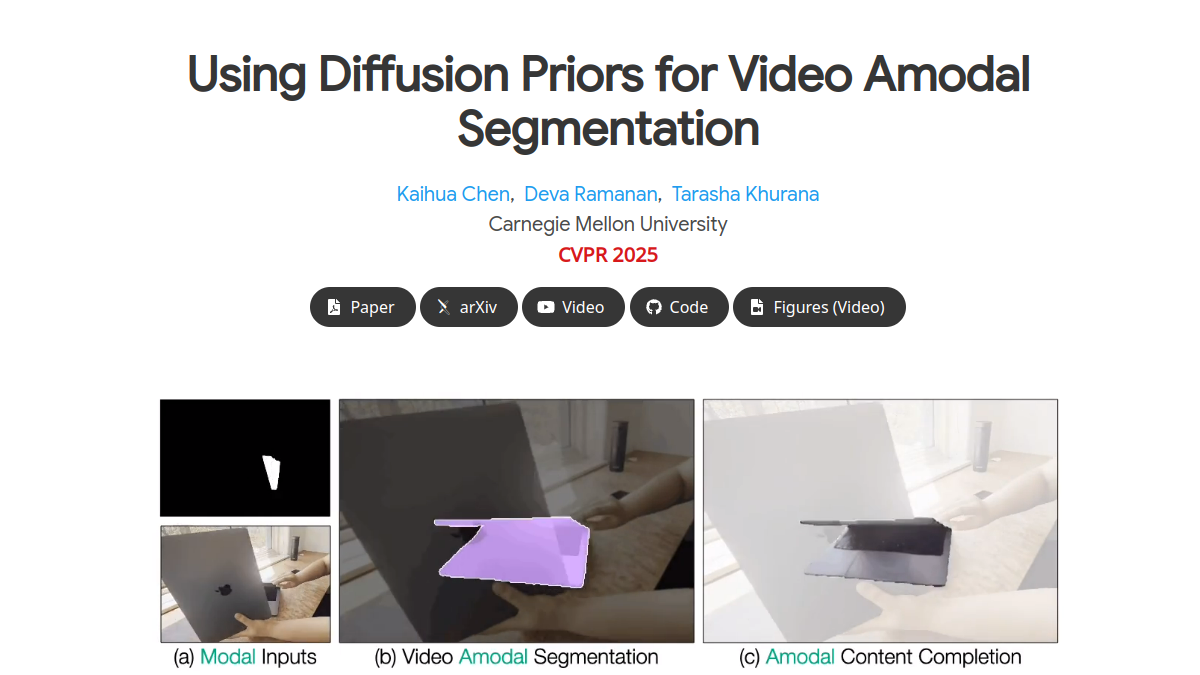
Diffusion-Vas是由卡内基梅隆大学提出的视频非可见物体分割与内容补全技术的官方展示站点,核心定位是面向计算机视觉领域的技术交流与效果演示平台。该站点提供模型技术原理详解、多场景效果可视化演示、论文成果下载三大核心功能,服务于计算机视觉研究者、视频处理开发人员、高校相关专业师生等群体,可用于视频分析算法研究、特效制作中的物体补全开发、视频修复场景的技术选型参考等场景,帮助用户直观理解非可见物体分割技术的实现逻辑与应用价值。


Boltz-1
Boltz-1是麻省理工学院Jameel Clinic团队开发的开源生物分子结构预测模型站点,核心定位是为全球科研群体提供可自由使用的高精度生物分子结构预测工具。站点核心功能包括公开完整的Boltz-1模型权重与调用接口,提供分子结构预测结果的可视化展示模块,同时开放模型训练所用的部分数据集与技术文档。目标用户覆盖高校结构生物学研究人员、生物制药企业研发人员、计算生物学方向学生等群体,可应用于蛋白质结构解析、药物靶点筛选、分子互作机制研究等多种科研与产业场景,支持非学术场景的商业开发需求。

Video Language Planning
Video Language Planning(简称VLP)是面向机器人任务规划领域的算法展示与技术说明站点,核心定位是展示基于视觉语言模型与文本到视频模型结合的长期任务视觉规划方案。站点核心功能包括算法原理的可视化讲解、不同应用场景的实验结果展示、可复现的技术实现文档开放,目标用户覆盖机器人研发人员、多模态AI研究者、高校自动化相关专业师生,可用于机器人任务规划算法调研、多模态模型落地机器人场景的技术参考、相关领域学术研究的案例参考等场景。


VideoWorld
VideoWorld是专注于纯视觉输入场景下知识学习的深度生成模型展示平台,核心围绕无标签视频的自回归生成技术,探索AI仅通过视觉信息获取任务规则、实现推理与规划的可行路径。平台内置潜在动态模型(LDM)可视化演示、视频围棋任务效果展示、机器人控制模拟测试三大核心功能,面向AI研究人员、计算机视觉方向开发者、高校人工智能相关专业师生,可用于前沿生成模型技术调研、视觉学习相关实验验证、课程设计案例参考等场景。
What The Product
What The Product是一款基于OpenAI ChatGPT技术开发的Chrome浏览器扩展,核心定位是为用户提供任意网站、互联网产品的即时智能分析服务。核心功能包括一键生成产品/站点分析报告、多维度信息拆解、技术栈识别、用户评价聚合,面向产品经理、市场调研人员、开发者、普通互联网用户,可应用于竞品调研、新产品评估、陌生网站可信度验证、技术选型参考等多种场景,无需注册登录,安装后即可快速使用,帮助用户高效获取目标产品的核心信息,降低信息收集成本。
EvTexture
EvTexture是基于事件视觉驱动的视频超分辨率技术演示站点,核心定位为面向计算机视觉领域研究者、开发者提供事件驱动视频超分辨率技术的体验、效果验证与技术参考平台。站点支持上传普通视频与对应事件信号数据进行超分辨率处理,可直观对比不同算法的纹理恢复效果,同时提供完整的技术论文、数据集测试结果查阅功能。目标用户涵盖计算机视觉研究人员、视频处理开发工程师、高校相关专业师生、影视后期制作人员、安防监控技术人员、VR内容创作者,可应用于学术研究验证、老旧视频修复、监控画面增强、影视内容画质升级、VR视频清晰度优化等多种场景。
ZeroBench
ZeroBench是聚焦多模态大模型视觉理解能力的专业基准测试平台,核心定位为多模态模型研发领域的评估工具。平台搭载经学术团队严格校验的高难度测试数据集,支持完整的模型性能分层评估,同时提供推理过程拆解分析功能。目标用户覆盖人工智能领域研究人员、多模态模型开发团队、高校计算机相关专业师生,可应用于模型迭代效果验证、学术论文实验支撑、多模态技术路线对比等场景,帮助使用者清晰识别不同模型在复杂视觉理解任务上的能力差异。

Cantor
Cantor是面向多模态链式思维推理研究的开源技术框架,核心定位是结合视觉感知与大语言模型逻辑推理能力,解决复杂视觉推理任务。核心功能包括视觉上下文感知对齐、多模态链式思维生成、推理性能自动评估、零样本推理适配、实验结果可视化。目标用户覆盖人工智能研究者、计算机视觉方向学生、多模态大模型开发人员、AI应用落地工程师、算法竞赛参与者。使用场景包括多模态推理算法性能测试、学术研究中基线模型对比、零样本视觉推理任务开发、大语言模型多模态能力验证、相关教学课程实验演示。
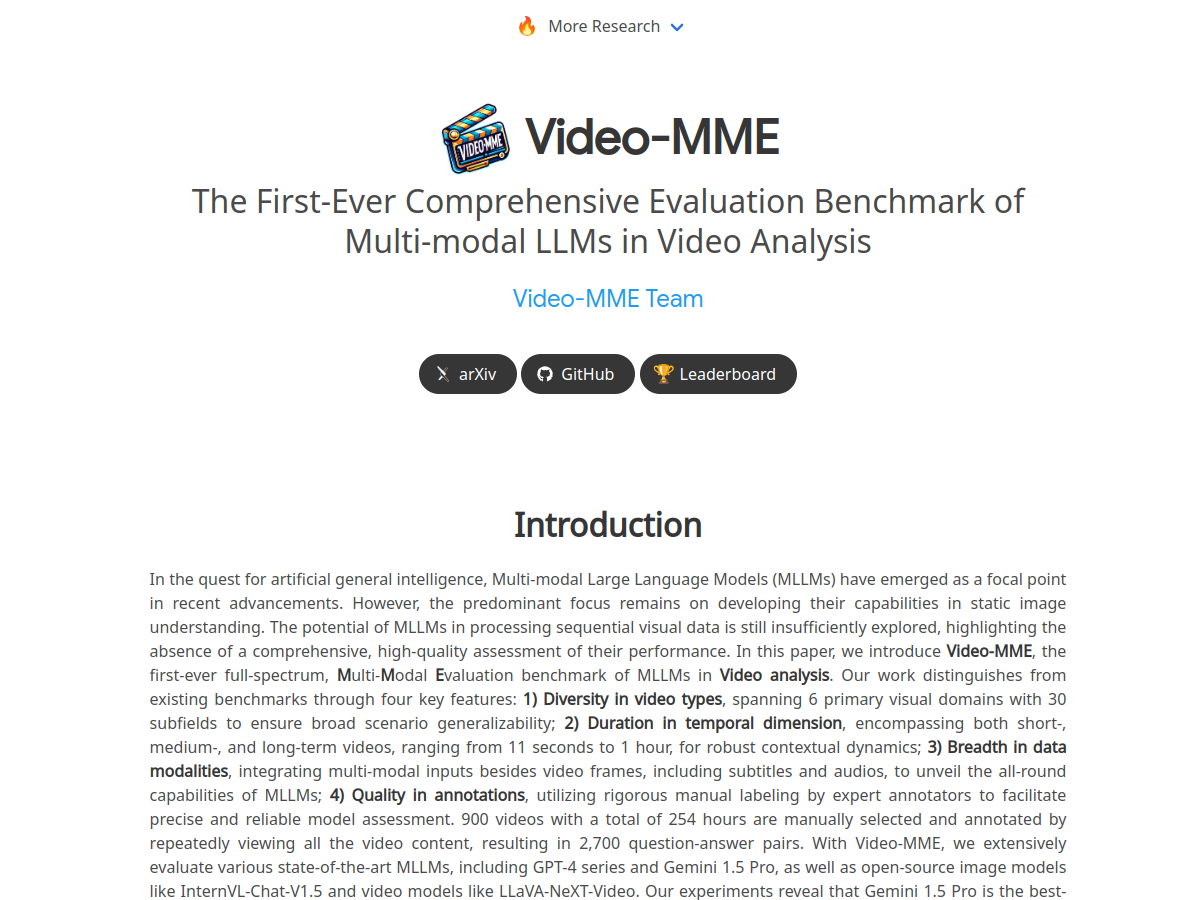
Video-MME
Video-MME是专注于多模态大型语言模型在视频分析领域性能评估的基准测试平台,核心定位为学术研究领域的标准化视频多模态能力评估工具。平台支持多维度视频理解能力测试,覆盖不同时长视频样本库,提供量化的模型性能对比报告。目标用户为多模态大模型研究人员、高校计算机相关专业师生、AI企业算法开发团队,可应用于模型迭代效果验证、不同架构模型横向对比、学术论文实验支撑、视频多模态算法落地前测试等场景。

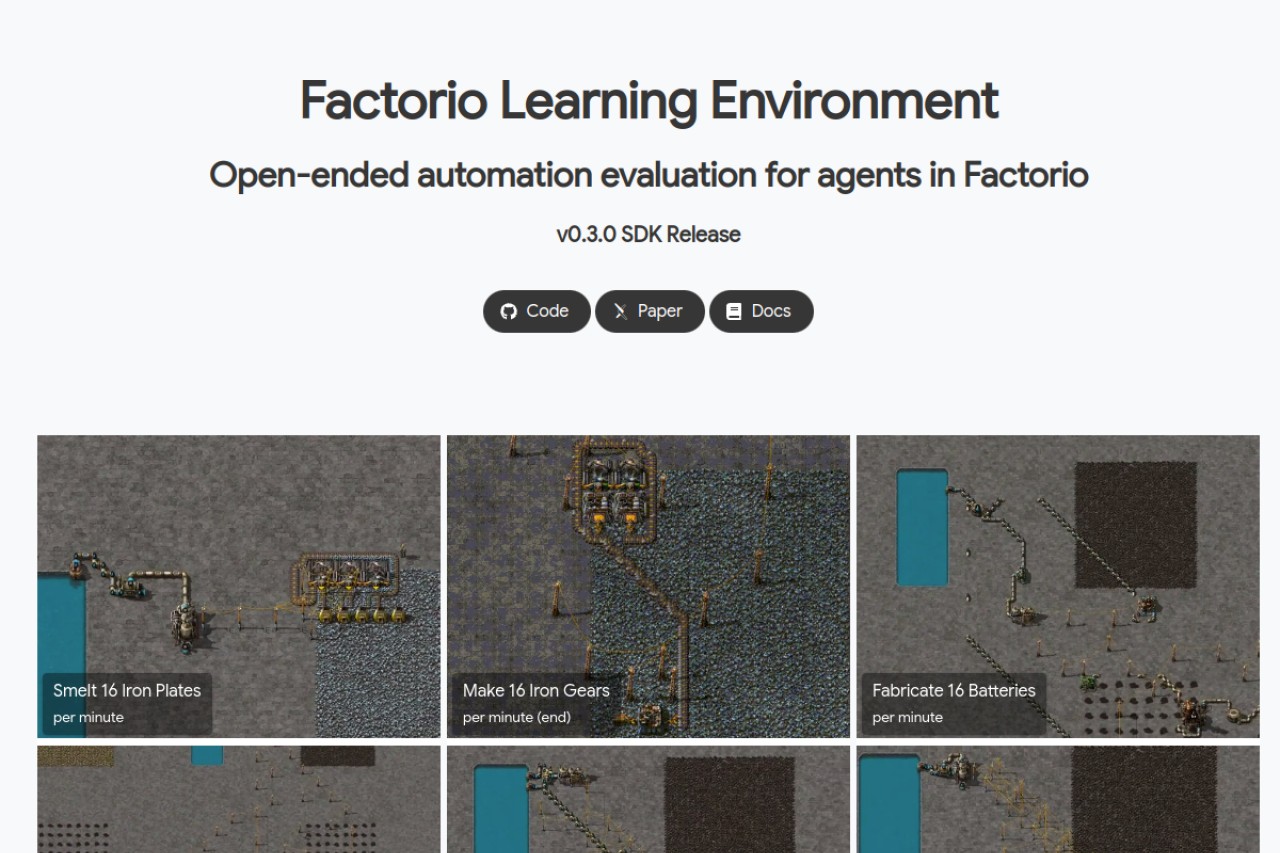
Factorio学习环境
Factorio学习环境(Factorio Learning Environment, FLE)是基于游戏《Factorio》构建的大语言模型能力评估框架,核心定位为AI研究领域的开放式智能体测试工具。核心功能包括支持结构化任务与开放式任务两类评估协议、可自定义难度梯度的任务配置、标准化的能力评估指标体系。目标用户覆盖AI研究人员、大语言模型开发团队、高校人工智能方向师生、智能体研发从业者、游戏AI爱好者、开源AI项目贡献者。使用场景包括LLM长期规划能力验证、程序合成效果测试、资源分配优化算法评估、智能体多步骤决策能力 benchmark 搭建、复杂开放式领域智能体训练数据集构建等,为大语言模型在复杂任务场景下的能力评估提供标准化测试载体。
Ai2 PaperFinder
Ai2 PaperFinder是艾伦人工智能研究院推出的学术文献检索与分析工具,核心定位为科研场景下的文献信息查询助手。平台收录超800万篇全文论文、1.08亿篇文献摘要,支持自然语言问答式检索、多文献观点合成、引用关系可视化、研究脉络梳理、开放获取全文下载等功能,覆盖计算机科学、生物学、物理学、社会科学等多学科领域。目标用户包括高校在读学生、科研机构研究员、企业研发人员、学术期刊编辑、学科教师、科普创作者等群体,适用于文献调研、研究选题论证、综述撰写资料收集、跨领域研究背景了解、学术观点溯源等多种科研工作场景。
关于AI研究工具
AI研究工具是面向学术、科研场景的AI辅助类工具,主要解决文献检索效率低、数据处理周期长、研究思路梳理耗时等问题,典型使用场景覆盖文献综述撰写、实验数据智能分析、研究框架搭建、学术内容合规校验等科研全流程环节,可帮助使用者减少重复性事务投入,聚焦核心研究创新点。
当前这类工具可分为通用型与垂直型两类:通用型工具覆盖多学科研究需求,支持基础文献整理、通用数据统计等功能,多数提供基础免费额度,进阶功能按周期订阅解锁;垂直型工具针对特定学科(如计算机、生物医学)优化,内置领域专属数据集、专业分析模型,多面向机构用户提供定制化部署服务,个人用户可申请限定权限的试用通道。不同工具的能力边界差异明显,部分工具侧重文献智能解读,部分工具侧重实验流程自动化。
选型时可参考三条可操作建议:第一,优先匹配自身研究所属学科,垂直领域工具的适配度通常高于通用工具;第二,根据核心需求选择功能侧重,若以文献综述为核心目标,优先选文献处理能力突出的产品,若以实验数据分析为核心,优先选算力支撑充足的产品;第三,提前确认工具的学术合规性,避免生成内容出现引用不规范、数据溯源缺失等影响研究可信度的问题。
AI研究工具常见问题
AI研究工具怎么选
先匹配自身研究的学科属性,垂直领域工具适配度更高;再对照核心需求筛选功能侧重,最后确认工具的学术合规性,避免后续出现引用不规范等问题。
AI研究工具免费还是收费
多数产品提供基础功能免费额度,进阶的专属数据集调用、大算力分析等功能需订阅解锁,部分面向机构的垂直工具仅开放付费定制服务。
AI研究工具适合谁用
主要适用于高校师生、科研院所研究人员、企业研发从业者,也可帮助刚入门的学术新人快速熟悉科研流程,降低初期上手门槛。