

AudiowaveAI
AudiowaveAI是一款基于人工智能技术的文本转语音工具,核心定位是为用户生成自然且富有情感的语音音频。它支持多语言多音色选择、长文本分段处理、音频参数自定义调节、SSML标记语言适配、多格式音频导出等功能,能够满足不同场景下的语音制作需求。目标用户覆盖内容创作者、教育从业者、有声读物制作者、企业运营人员、听力障碍辅助内容制作者以及有音频学习需求的普通用户,可用于制作课程讲解音频、有声书内容、品牌宣传语音、信息播报音频、离线学习音频等多种类型的语音内容,帮助用户提升内容传播效率,丰富内容呈现形式。
Nowy
Nowy是一款基于人工智能技术打造的智能语音助手平台,核心定位是为用户提供多场景下的语音交互与效率提升服务。平台支持自然语音识别与多轮对话交互,可完成信息查询、日程管理、多媒体控制等多类操作,同时支持跨设备数据同步,满足不同场景下的使用需求。目标用户覆盖职场工作者、学生群体、居家用户等多类人群,适用于办公场景下的日程规划、居家场景下的设备控制、出行场景下的信息查询等多种场景,助力用户提升日常工作与生活的处理效率。
Lucyd
Lucyd是一款搭载ChatGPT AI助手的移动应用,核心定位是为用户提供免键盘的语音交互AI服务,适配智能眼镜控制场景。核心功能包括语音触发AI对话、智能眼镜端操作控制、查询记录全生命周期管理、多端同步响应。目标用户覆盖日常信息查询人群、智能眼镜使用者、驾驶场景用户、手部不便人群等,可在通勤途中、双手被占用的工作场景、户外出行等多场景下使用,满足用户无需动手即可获取AI服务的需求。

Speechllect
Speechllect是一款基于自主研发Sense Theory数学理论的语音交互AI解决方案平台,核心提供实时语音转文字、文字转语音双向转换能力,可识别语音内容的语义信息,生成带有自然语调和特定调性的拟人化语音输出。平台支持便捷的API集成能力,面向企业开发人员、内容创作者、智能设备厂商等用户群体,可应用于呼叫中心交互、游戏角色配音、虚拟助手对话、智能家居语音交互、音频内容制作等多种场景,帮助用户降低语音交互功能的开发成本,提升语音内容的自然度与语义匹配度。
AI Clone Voice Free
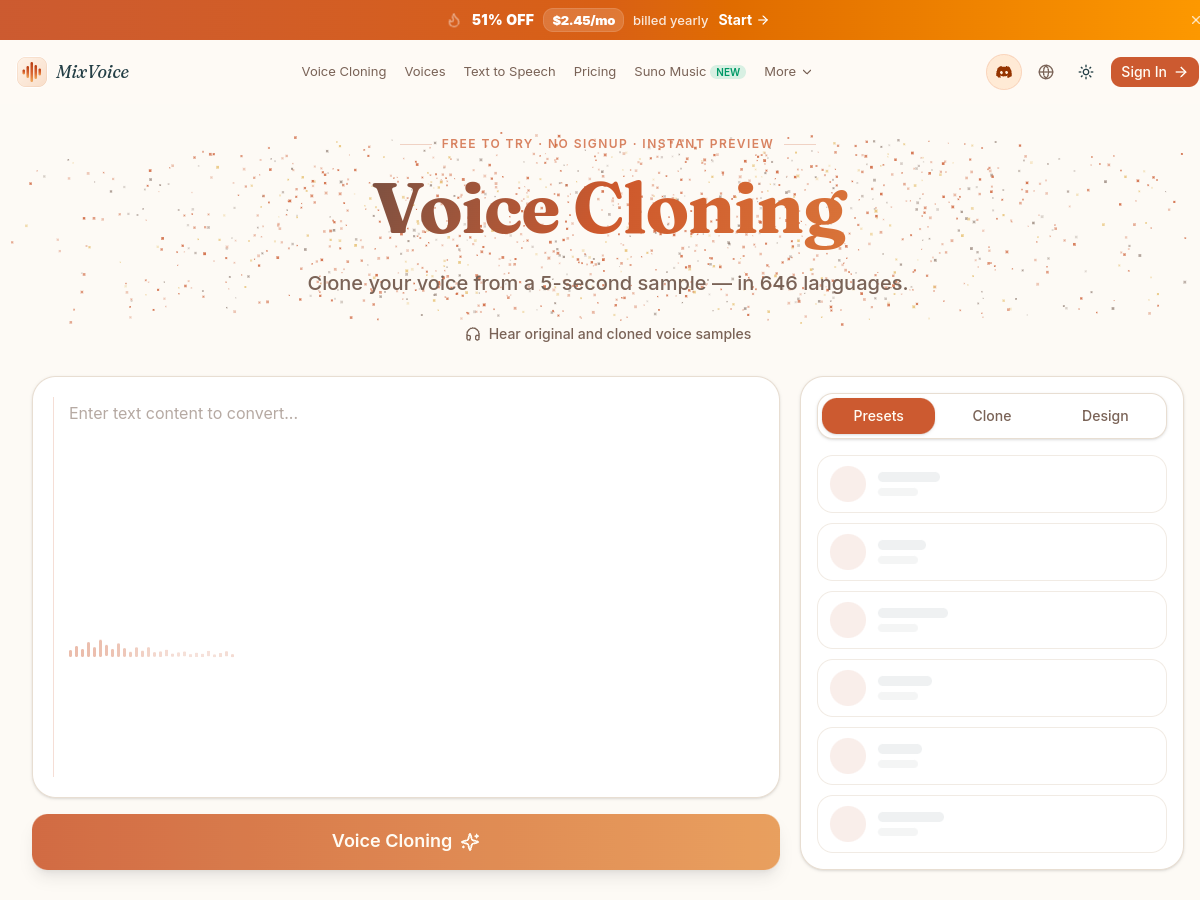
AI Clone Voice Free是一款专注于语音克隆的在线工具,核心定位是为用户提供轻量化、浏览器端即可操作的人声复刻服务。核心功能包括短音频快速克隆、多语种语音生成、克隆音批量导出、自定义情感参数调节等,不需要专业录音设备即可完成操作。目标用户覆盖内容创作者、教育工作者、配音从业者、短视频制作者等群体,可用于自媒体配音、有声书制作、多语种课程录制、短视频旁白生成、数字人语音配套等多种场景,降低语音内容制作的人力和时间成本。
Video2Text
Video2Text是一款基于OpenAI Whisper技术开发的视频转文字工具,核心定位是为用户提供高精度的音视频内容文字转写服务。平台支持多格式视频文件上传识别,转写结果可导出为多种常用文档格式,还支持多语言识别功能。该工具面向研究人员、教育工作者、记者、内容创作者等多类用户,可用于课程录像整理、采访内容转录、视频字幕生成、会议记录归档等多种场景,无需复杂操作即可完成音视频内容的文字转换。


天猫精灵X6
天猫精灵X6官网是阿里巴巴旗下人工智能品牌天猫精灵,为旗舰级智能音箱X6打造的官方展示与服务平台。网站核心功能包括产品核心参数全景展示、智能场景适配方案介绍、配套服务政策说明、购买渠道跳转指引、用户常见问题解答。面向智能家居爱好者、音频体验需求用户、智能设备联动需求用户,可用于了解产品详细配置、对比不同版本差异、查询适配的智能家居设备型号、获取售后保障政策,也可作为选购智能音箱时的官方参考依据。
悦录
悦录是依托同花顺智能语音与自然语言处理技术打造的智能办公助手,核心为用户提供音视频转文字、多语种识别、内容校对整理等功能,可适配会议记录、课程录制、访谈转写、采访内容整理等多类场景。目标用户覆盖职场白领、学生群体、媒体从业者、科研人员、自由职业者等,帮助用户降低音视频内容整理的时间成本,提升信息处理与记录的效率。
Talk to PDF
Talk to PDF是主打文档语音转换的在线工具平台,核心定位为多格式文档的智能语音朗读服务。平台支持PDF、PPT、Word等主流办公文档上传解析,可自动提取文本内容生成自然流畅的语音版本,同时提供语速调节、音色选择、自动滚屏等辅助功能。目标用户覆盖学生、教师、职场白领、视障人群、有声内容创作者等,适用场景包括通勤路上听学术文献、办公场景听工作方案、备考阶段听复习资料、视障用户获取文档内容等,满足多场景下的“听读”需求。

Make-An-Audio 2
Make-An-Audio 2是由浙江大学、字节跳动、香港中文大学联合研发的文本到音频生成技术官方展示站点,核心定位为面向学术研究与创意开发群体的音频生成技术演示平台。核心功能包括文本语义解析转音频、变长音频生成、音频时间一致性优化、音频生成效果对比展示。目标用户覆盖音频领域研究人员、AI技术开发者、内容创作从业者、高校计算机相关专业师生。使用场景包括学术研究中的技术效果验证、内容创作前期的音效小样生成、AI音频技术开发的算法参考、高校相关课程的技术案例演示。

Audioread
Audioread是一款基于人工智能技术的文本转语音服务平台,核心定位是为用户提供高拟真度的语音转换与音频内容管理服务。平台支持多端文本导入、多语言语音合成、私人播客订阅同步三大核心功能,面向需要将文字内容转化为音频收听的学生、职场人士、内容创作者、视障用户、通勤人群和有声内容爱好者,可应用于文档听读、学习资料音频化、通勤内容收听、长文本内容减负等多个场景,满足不同用户在不同场景下的听读需求。

AI VoiceOver
AI VoiceOver是一款专注于视频AI语音解说生成的在线工具,核心定位为帮助用户快速为各类视频匹配自然流畅的旁白语音,无需专业配音设备即可完成音视频合成。平台支持上传100MB以内的视频文件,提供多风格多语种的语音选项,可自动适配视频时长生成对应节奏的解说音频,支持合成后直接导出带语音的完整视频。目标用户覆盖短视频创作者、知识类博主、企业宣传人员、教育课件制作人等,可用于短视频旁白制作、科普视频解说、产品宣传视频配音、教学课件音频补充等多种场景,帮助用户降低配音成本,提升视频制作效率。

Zonos TTS
Zonos TTS是专注于AI文本转语音的在线服务平台,核心为用户提供高自然度的语音生成与定制服务。平台支持多语言文本转写、多风格情感语音调节、零样本语音克隆等功能,同时提供批量语音导出、字幕同步生成等配套能力。目标用户覆盖内容创作者、有声书制作人员、教育行业从业者、电商商家、广告设计人员等群体,可满足有声内容制作、课程语音配音、电商视频旁白、多语言广告播报、AI助手语音定制等多场景使用需求。
ChatTTS.com
ChatTTS.com是专注于对话场景的语音合成服务平台,基于专门为对话交互优化的TTS模型打造,核心为用户提供自然流畅的多语种语音生成能力。平台支持中英文双语合成,可自定义语音音色、语速、停顿节奏等参数,还能适配不同对话场景的语气表达。目标用户涵盖AI应用开发者、内容创作者、有声读物制作人员、教育行业从业者等,可用于LLM对话助手语音输出、短视频配音、有声内容制作、智能客服语音部署、多语言教学音频生成等多种场景,满足不同领域的语音合成需求。

AdutorAI
AdutorAI是一款专注于音频转样式化文本的智能内容处理平台,核心功能包括音频转写、多模板文本生成、多语言内容处理、文本编辑优化等。平台支持用户上传不同格式的音频文件,可根据实际需求选择对应内容模板,快速生成符合使用场景的结构化文本,同时提供摘要生成、多语言翻译、文本长度调整等配套工具。目标用户覆盖内容创作者、职场办公人群、学生群体、新媒体运营者、商务人士等,可应用于会议记录整理、社交媒体内容创作、邮件撰写、课程笔记梳理、采访内容转写等多个场景,帮助用户提升内容生产和处理的效率。

KokoroTTS
KokoroTTS是一款专注于文本转语音领域的在线工具,核心定位为用户提供多场景下的语音合成服务。平台支持多语言语音合成、多格式文件转语音、语音参数自定义、多人声融合生成等功能,同时支持免费商业使用许可,能够满足不同用户的语音内容制作需求。其目标用户覆盖内容创作者、开发者、企业运营人员、教育工作者、有声读物制作者等群体,可广泛应用于有声书创作、视频旁白生成、播客内容制作、教育音频开发、客服语音系统搭建、多语言内容本地化等多种场景,帮助用户降低语音内容制作的成本,提升内容生产效率。

Vocapia
Vocapia是由Vocapia Research推出的专业语音识别技术服务平台,核心定位为面向多场景的音频视频语音数据处理解决方案提供商。平台具备大词汇量连续语音识别、多语种自动识别、说话人身份区分等核心功能,支持批量与实时两种处理模式,可满足广播媒体、学术机构、企业办公、呼叫中心等不同主体的语音转写与分析需求,适用场景涵盖广播电视内容监控、学术讲座研讨内容留存、视频字幕自动生成、跨地域电话会议内容整理、呼叫中心客服对话数据分析等多个领域,还可根据用户个性化需求提供定制化模型开发服务。

Respeecher
Respeecher是专注于语音克隆与合成的技术服务平台,核心定位是为内容创作领域提供高保真的语音还原与生成解决方案。平台依托专有的深度学习技术,可生成与原说话人特征高度匹配的合成语音,支持跨语言语音转换、历史语音复原等核心功能,主要服务于影视制作、游戏开发、有声内容创作等领域的专业用户。可应用于影视项目后期配音补录、游戏角色专属语音定制、有声读物多音色内容生产、历史资料语音复原等多种场景,满足专业创作中对语音精度、自然度的高要求。

MakePodcast
MakePodcast是一款基于人工智能技术的播客制作平台,核心定位是降低播客制作的技术门槛,帮助用户高效产出符合不同需求的音频内容。平台搭载Open AI TTS与Eleven Labs Voices技术,支持用户上传剧本即可生成音频,支持多语言语音选择,还支持自定义声音克隆功能。目标用户覆盖内容创作者、自媒体运营者、企业市场人员、教育工作者等群体,可应用于制作播客正片、品牌口播广告、博客内容音频化、有声书片段、教育音频课程等多个场景,无需复杂的音频剪辑设备与专业技能即可完成制作。
MyVocal
MyVocal是专注于AI声音克隆与音乐创作的在线工具,核心定位为普通用户提供低门槛的声音定制与音频创作能力。核心功能包括60秒快速声音克隆、AI翻唱生成、语音内容转语音创作、多场景声音适配导出、音调自定义调整,目标用户覆盖音乐爱好者、内容创作者、自媒体从业者、有声书制作人员、普通个人用户等,可用于制作个人专属翻唱作品、为短视频配音、生成个性化有声内容、制作专属语音祝福等场景,无需专业音频设备即可完成声音相关创作。