
Bailing-TTS
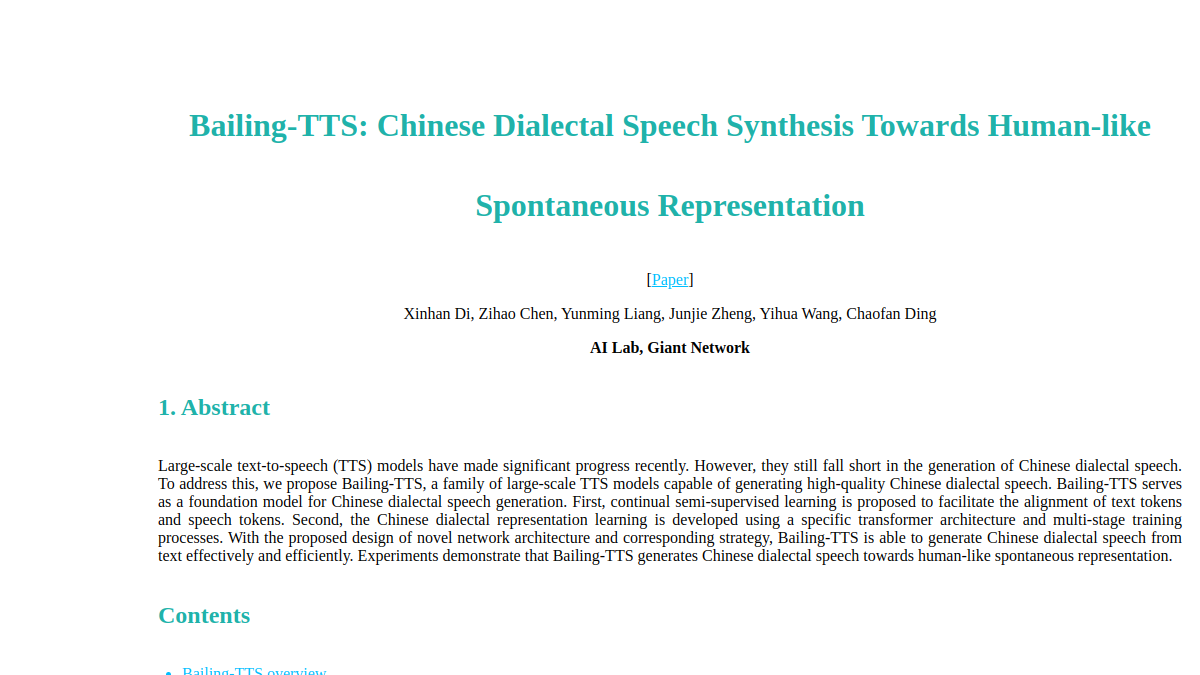
Bailing-TTS是巨人网络AI Lab研发的中文方言文本转语音模型系列技术站点,核心定位为方言语音合成技术的展示与技术方案输出。站点支持多类中文方言的语音合成效果预览,提供完整的技术架构说明与训练方法解析,同时公开模型相关实验对比数据。目标用户覆盖语音技术研发人员、方言文化传播从业者、内容创作群体以及相关学术研究人员,可应用于方言有声读物制作、方言语音交互产品开发、地方文化内容数字化留存、多语言语音产品原型测试等多个场景。

WAKE UP MOTHAF&#$R
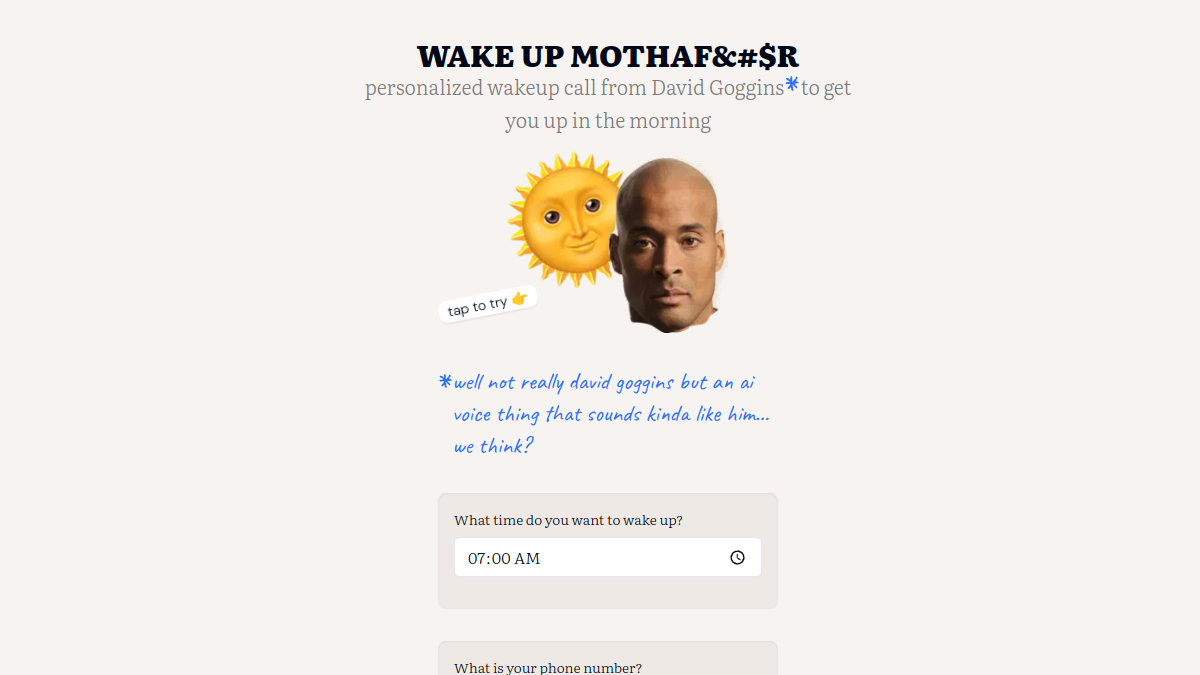
WAKE UP MOTHAF&#$R是由David Goggins粉丝开发的AI语音唤醒工具,核心定位是通过拟真的David Goggins风格语音生成个性化叫醒内容,为用户提供具有强激励属性的唤醒服务。平台支持自定义唤醒语音文本内容,可调整语音语速适配不同使用需求,生成后的语音支持一键下载保存。目标用户覆盖需要提升起床动力的通勤人群、需要运动前激励的健身爱好者、备考需要自我督促的学生群体等。使用场景包含早晨起床唤醒、居家健身前打气、学习倦怠期激励、工作拖延时自我提醒等多个日常场景。
Listen Monster
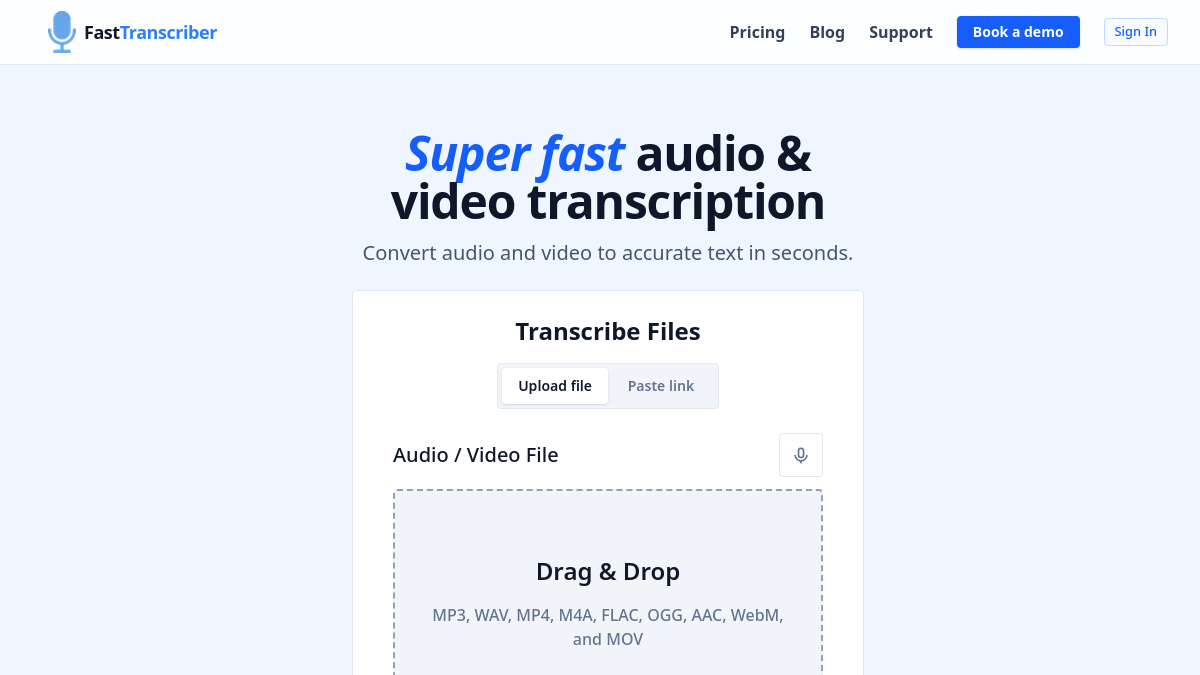
Listen Monster是一款专注于音视频转写的英文字幕生成工具,核心定位为面向多场景的免费音视频内容转写服务。其核心功能包括支持多格式音视频上传识别、多格式字幕文件导出、无水印内容输出,可满足英语内容创作者、教育从业者、媒体工作者等群体的转写需求,适用于视频字幕制作、访谈内容整理、课程内容归档、英文播客文字化等多个场景,无需复杂操作即可完成音视频内容到文字或字幕的转换。
BASE TTS
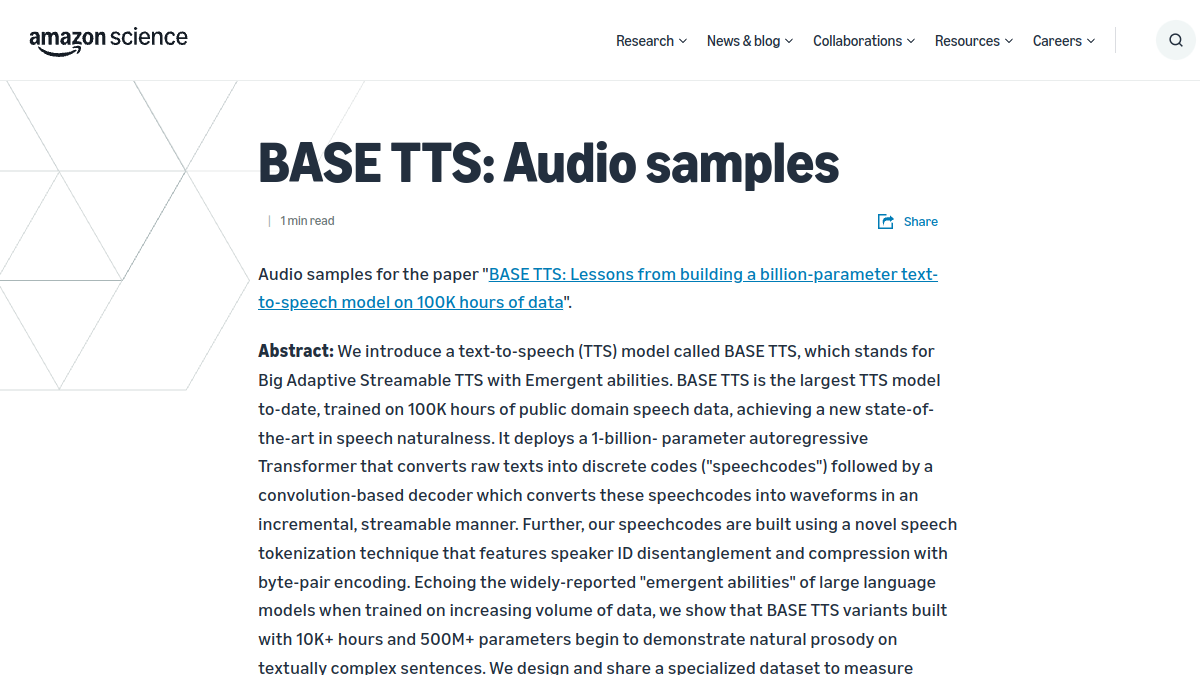
BASE TTS是亚马逊推出的大规模文本转语音合成模型展示站点,核心定位是呈现大参数TTS模型的语音合成效果。站点内置多场景语音合成样本展示、不同参数模型效果对比、跨语言语音合成演示三大核心功能,面向人工智能研究人员、语音技术开发者、内容创作从业者、语音交互产品设计者等群体,可用于学术研究参考、技术选型对比、合成语音效果测试、多语言语音产品原型验证等场景,帮助用户直观了解大参数TTS模型的技术特性与实际表现。
Podsee
Podsee是专注于播客内容发现与随机播放的在线工具,基于Elixir语言与Phoenix LiveView框架开发,核心定位为播客爱好者的内容探索辅助平台。平台核心功能包括播客随机播放、个性化内容推荐、播客标签分类筛选,能够帮助用户跳出固定收听列表,接触不同领域的优质播客内容。目标用户覆盖日常有播客收听习惯的群体、希望拓展内容涉猎范围的内容消费者、播客创作者及泛音频内容爱好者。适合通勤途中、工作背景音、居家放松等多个场景下使用,为用户提供多样化的音频内容选择。

Open Voice OS
Open Voice OS是社区驱动的开源语音AI平台,核心定位是为开发者与设备厂商提供隐私优先的语音交互解决方案。平台支持自然语言处理能力适配、可定制语音交互界面搭建、多设备端部署适配三类核心功能,面向智能设备开发者、开源爱好者、智能家居厂商、教育科研人员等群体,可用于智能家居语音控制模块开发、嵌入式设备语音交互功能搭建、语音AI相关技术研究试验、定制化语音助手开发等场景,所有代码均开源开放,用户可根据自身需求对功能进行二次调整,无需依赖第三方闭源语音服务。

GitPodcast
GitPodcast是由BandarLabs开发的在线工具,核心定位是将GitHub代码仓库内容转换为播客音频,帮助用户通过听觉方式了解代码项目。核心功能包括GitHub仓库解析、多音色音频生成、项目结构自动梳理三类。目标用户覆盖开发者、技术学习者、开源项目爱好者等群体。使用场景包含通勤途中收听项目介绍、视力障碍开发者了解开源项目架构、碎片化时间学习热门代码项目实现逻辑、团队内部项目快速调研新接手项目的基础信息等,降低代码项目的了解门槛,丰富开发者的学习路径。

TangoFlux
TangoFlux是开源的文本到音频(TTA)生成模型平台,核心定位是为音频生成领域的研究者、开发者提供高效、对齐能力强的音频生成技术方案。核心功能包括基于CRPO框架的高对齐度文本转音频生成、30秒44.1kHz高音质音频快速生成、全开源的模型与代码资源开放。目标用户覆盖音频领域研究者、AI应用开发者、内容创作者、高校计算机相关专业学生等,可用于学术研究验证、音视频内容音频素材生成、AI音频应用原型开发、课程实践项目搭建等场景。

Make-An-Audio 2
Make-An-Audio 2是由浙江大学、字节跳动、香港中文大学联合研发的文本到音频生成技术官方展示站点,核心定位为面向学术研究与创意开发群体的音频生成技术演示平台。核心功能包括文本语义解析转音频、变长音频生成、音频时间一致性优化、音频生成效果对比展示。目标用户覆盖音频领域研究人员、AI技术开发者、内容创作从业者、高校计算机相关专业师生。使用场景包括学术研究中的技术效果验证、内容创作前期的音效小样生成、AI音频技术开发的算法参考、高校相关课程的技术案例演示。
关于语音生成与转换
语音生成与转换类工具是一类依托AI技术实现语音内容生成、格式转换、音色复刻、语种转译等操作的工具集合,主要解决人工录音成本高、多语种语音制作效率低、语音格式适配复杂场景耗时久等问题,典型使用场景涵盖短视频配音、有声书制作、直播实时字幕转语音、跨语种会议语音互译、老旧音频格式修复转码等。
这类工具按能力覆盖范围可分为通用型与垂直型两类,通用型工具支持基础的文本转语音、常见音频格式互转功能,多数提供基础免费额度,满足普通用户日常轻量使用需求;垂直型工具则聚焦特定场景,比如专业有声书多角色配音、专业影视级音色复刻、小语种方言高精度语音转换等,这类工具多采用阶梯付费模式,针对专业生产场景提供更高的音质与定制化能力。不同工具的音色库规模、转换后的音频保真度、实时处理延迟存在明显差异,用户可根据自身需求匹配对应产品。
选型时可参考三条可操作建议:第一,普通个人日常轻量使用优先选择提供免费基础额度的通用型工具,无需额外付费即可满足基础配音、格式转换需求;第二,专业内容创作者优先选择支持多角色音色定制、高码率音频导出的垂直类工具,保障产出内容的音质符合发布标准;第三,有实时语音转换需求的用户,优先测试工具的端到端处理延迟,避免出现音画不同步、交互卡顿等问题。
语音生成与转换常见问题
语音生成与转换工具怎么选
先明确自身使用场景,轻量日常需求选通用免费款,专业生产场景选支持高保真导出、定制化音色的垂直类工具,实时使用场景提前测试延迟表现。
语音生成与转换工具免费还是收费
多数工具提供基础功能免费额度,满足普通用户轻量使用需求,高阶定制化、高算力占用的专业功能多采用阶梯付费模式,按使用量或订阅周期计费。
语音生成与转换工具适合谁用
适合短视频创作者、有声书制作人、跨境内容运营者、会议记录人员以及有音频格式转码需求的普通办公用户,覆盖个人与不同规模的专业生产团队。