
Generative Rendering:2D mesh
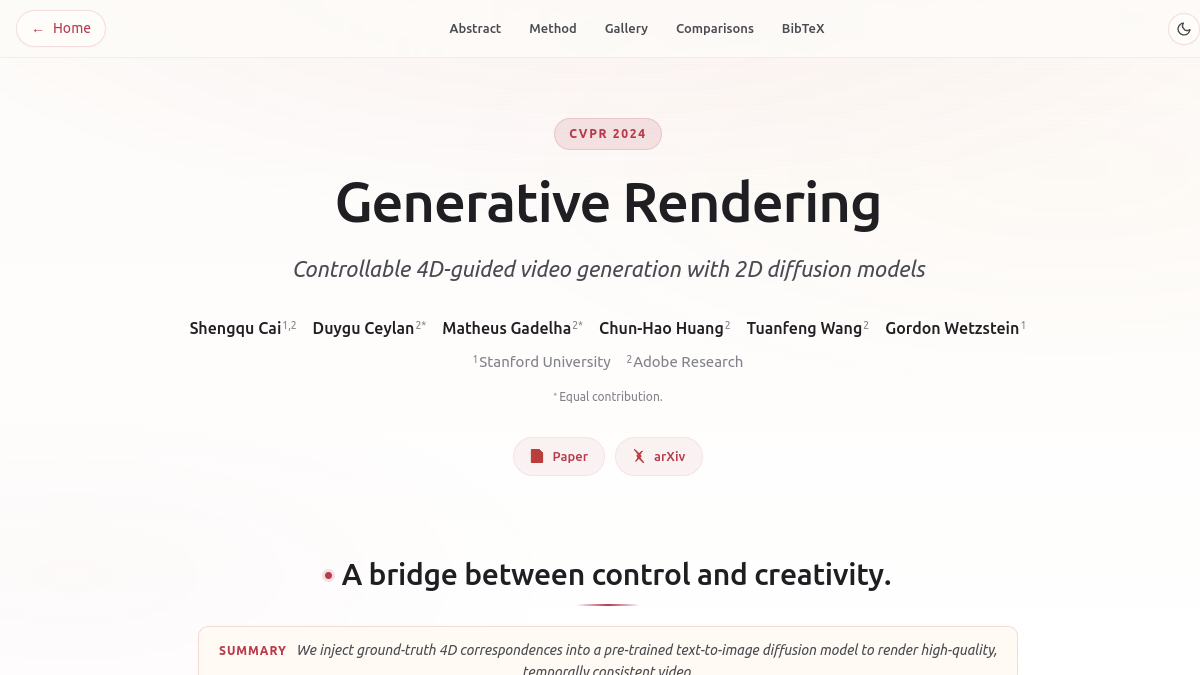
Generative Rendering:2D mesh是一款结合3D网格可控性与扩散模型生成能力的在线生成工具,核心定位是解决现有文本生成视频可控性不足的问题。其核心功能包括支持低保真动画3D网格输入生成高保真时序一致视频、可通过调整资产动作与相机路径控制视频内容、将网格对应信息注入文本生成模型各阶段保证生成质量。目标用户覆盖CG创作者、AI生成内容研究者、动画制作从业者、游戏内容开发者、新媒体内容创作者等,可应用于动画初稿制作、3D内容风格化渲染、创意短视频生成、游戏过场动画快速制作、学术研究效果验证等多种场景。

MotionDirector
MotionDirector是由ShowLab团队推出的文本到视频生成技术演示平台,核心定位为视频内容创作领域的动作自定义生成工具。平台支持双路径LoRA架构训练,可实现视频外观与运动特征的解耦学习;内置去偏置时间损失算法,降低外观属性对时间训练目标的干扰;支持单图动画生成、跨视频动效迁移等场景。目标用户覆盖AI视频研发人员、创意内容创作者、影视动画设计师等群体,可用于短视频动效制作、实验性艺术创作、AI生成视频技术调研等多个场景。
MotionCtrl
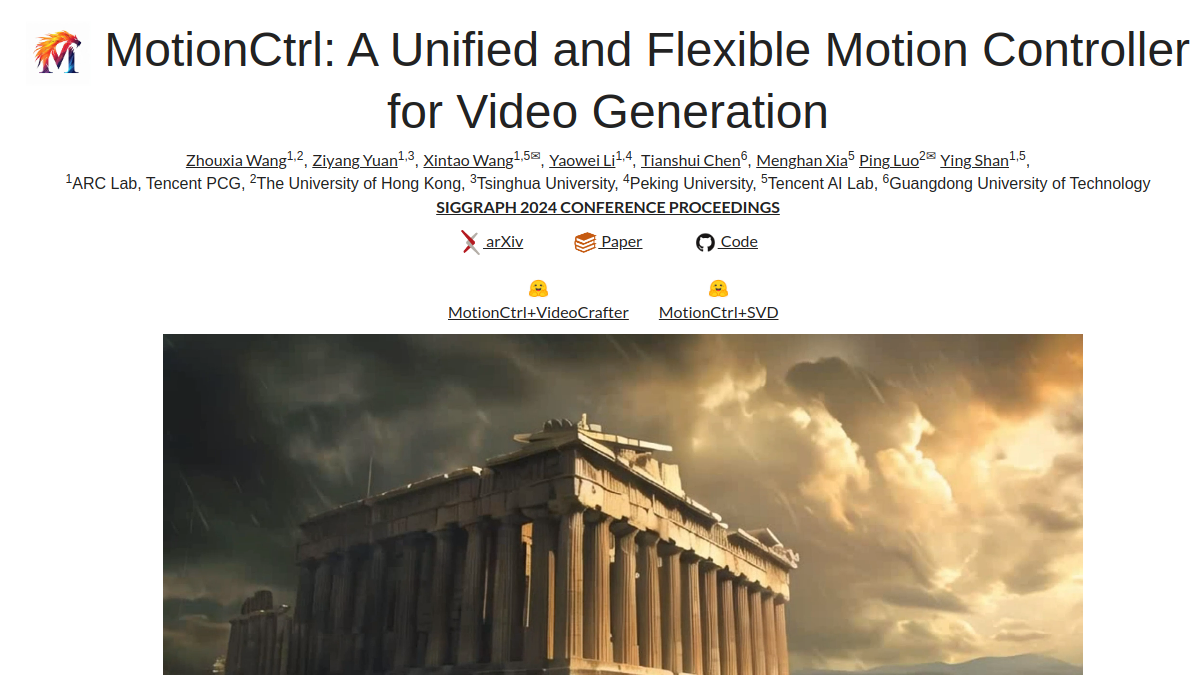
MotionCtrl是一个统一灵活的视频生成控制工具,核心定位是为AI视频生成流程提供精准的运动管控能力。核心功能包括相机运动独立控制、物体运动轨迹引导、多视频生成模型兼容适配三类。工具面向AIGC内容创作者、视频后期制作人员、计算机视觉研究人员等群体,可应用于影视分镜动态预览、动画场景运动设计、AI视频生成效果调优等场景,帮助用户在无需手动逐帧调整的前提下,生成符合运动预期的AI视频内容。
ReSyncer
ReSyncer是一款专注于音视频同步处理的AI框架工具,核心依托风格注入Transformer技术,为音视频内容创作提供唇形同步、风格迁移相关的技术支持。其核心功能包括高保真唇形同步生成、说话风格自定义转换、视频驱动的面部动作复刻三个方向,主要面向音视频创作者、虚拟内容开发人员、短视频制作团队等用户群体,可应用于虚拟主持人内容制作、多语言译制片口型对齐、数字人内容生成等多个场景,帮助降低音视频同步内容的制作门槛,提升输出内容的自然度。
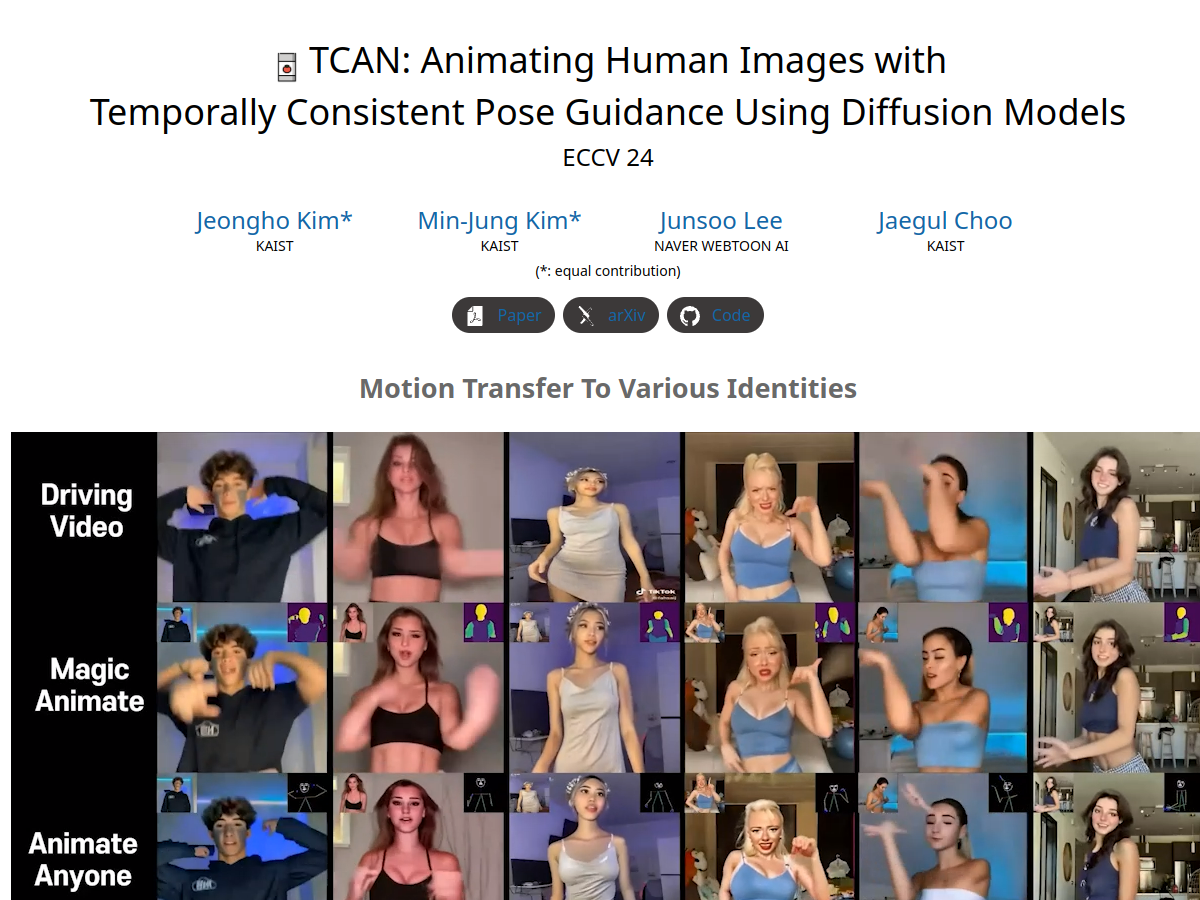
TCAN
TCAN是ECCV 2024收录的基于扩散模型的人像动画学术项目官网,核心定位是面向研究人员和开发者的时间一致性人像动画技术展示与资源平台。核心功能包括框架技术细节公开、效果演示视频展示、论文源码与预训练模型下载。目标用户覆盖计算机视觉领域研究人员、AI动画开发工程师、数字内容创作者、高校相关专业师生。可用于人像动效生成研究、虚拟数字人驱动开发、短视频内容二次创作、学术复现实验等多种场景,帮助用户了解该框架在跨域人像动画生成中的时间一致性保持能力,获取完整的技术落地参考资源。
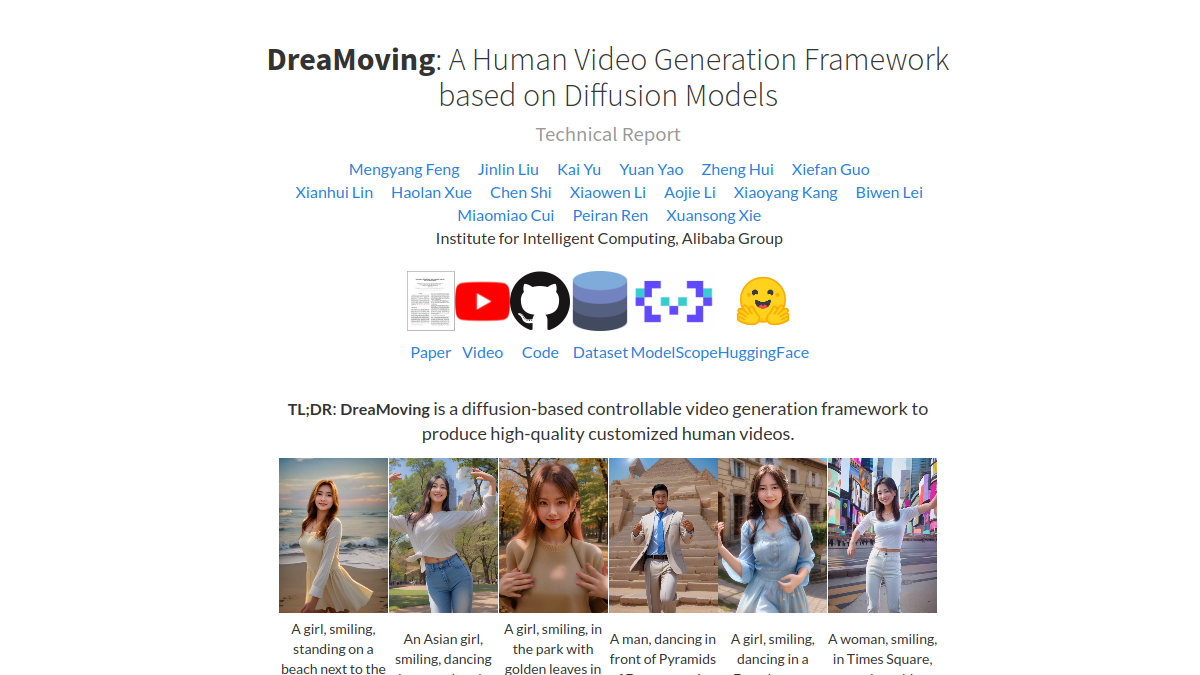
DreaMoving
DreaMoving是基于扩散模型的可控制视频生成框架,核心定位为定制化人类舞蹈视频生成工具。核心功能包括支持用户上传目标人物身份图像、输入指定姿势序列即可生成对应人物跟随姿势跳舞的视频,搭载视频控制网络实现精准运动轨迹控制,搭配内容导引器保留人物身份特征。目标用户覆盖AI视频创作者、数字内容设计师、舞蹈爱好者、科研人员等群体,使用场景包括虚拟偶像舞蹈内容制作、短视频创意内容生成、AI视频生成技术研究、个人趣味舞蹈视频创作等领域,可适配多数风格化扩散模型,满足多样化生成需求。

Upscale-A-Video
Upscale-A-Video是一款基于扩散模型的视频超分辨率处理工具,核心定位是为低分辨率视频提供清晰度增强服务,同时兼顾画面保真度与时间流畅度。其核心功能包括:支持文本提示引导纹理生成,用户可输入描述自定义修复后的画面风格与细节;内置双重时间一致性保障机制,避免放大后画面出现抖动、闪烁问题;提供噪声水平调节选项,可根据原始视频质量调整生成权重,平衡还原度与创意生成效果。该工具面向视频创作者、AI内容开发者、多媒体处理从业者等群体,适用于老视频修复、AI生成视频清晰度提升、低清素材二次加工等场景。

DreamTalk
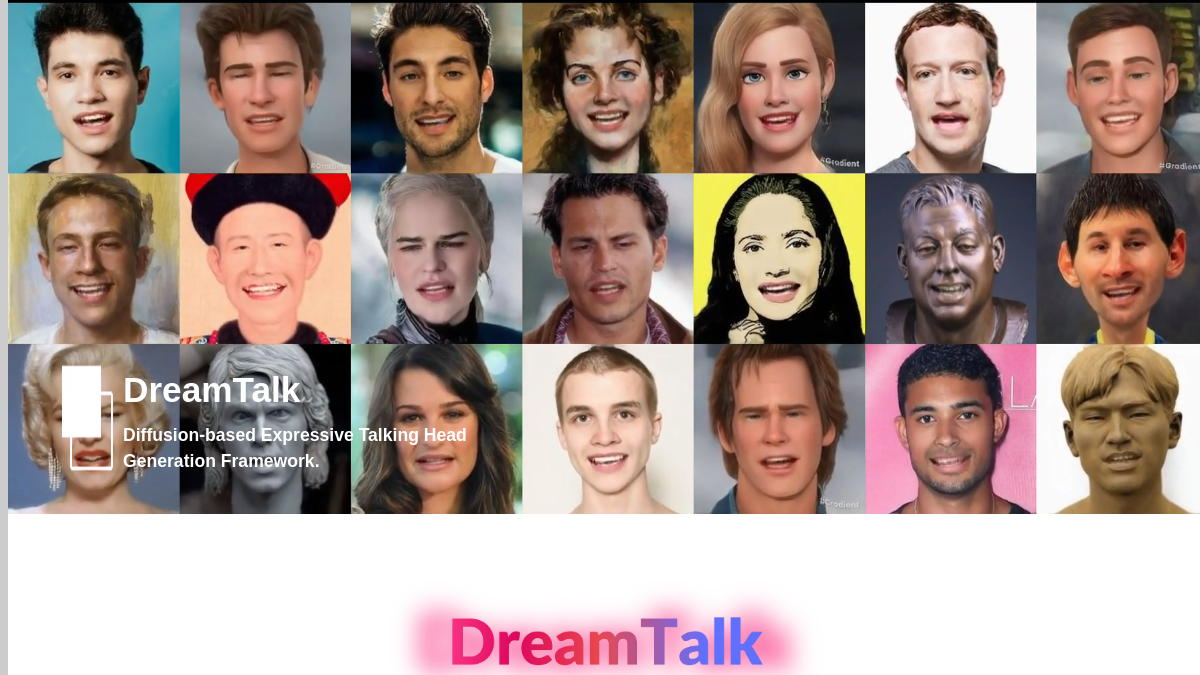
DreamTalk是基于扩散概率模型研发的说话人脸生成技术框架,核心功能包含风格感知唇部动作生成、多语言表情适配、多样化风格预测,可生成照片级拟真的说话人脸效果。目标用户覆盖AI数字人研发人员、动画制作从业者、虚拟形象开发团队、高校计算机视觉方向研究者等,适用于数字人直播内容制作、多语种虚拟主播内容生成、影视动画角色口型匹配、学术研究中的人脸生成效果验证等多个场景,降低了拟真说话人脸生成对高成本风格参考素材的依赖。
FlowVid
FlowVid是一个光流引导的视频合成模型工具站,核心功能是依托光流的空间与时间信息保障视频帧间时序一致性,可对接现有图像合成模型完成多类视频编辑操作,同时具备较高的生成效率,能快速输出符合预期的编辑后视频内容。该工具面向视频创作者、AI研发人员、视觉设计从业者等群体,可应用于短视频风格化改编、影视素材局部修改、AI视频生成效果优化等多个场景,帮助用户在保障视频时序流畅度的前提下完成各类视频合成编辑需求。

Generative Keyframe Interpolation with Forward-Backward Consistency
Generative Keyframe Interpolation with Forward-Backward Consistency是一个基于图像到视频扩散模型的关键帧插值工具,核心定位是在两张静态关键帧之间生成高连贯性的过渡视频序列。其核心功能包括支持双关键帧输入生成平滑运动视频、前后向一致性校验保障帧序列逻辑连贯、轻量级微调适配不同风格的图像内容。目标用户覆盖动画制作人员、视频剪辑师、数字艺术创作者、影视后期从业者等,可用于动画补帧、视频转场制作、静态图像动态化创作、旧视频帧修复补全、创意短视频特效制作等场景,无需复杂的手动帧绘制操作即可实现流畅的视频过渡效果。

Re.video
Re.video是基于Motion Canvas的开源程序化视频编辑框架,面向开发者群体提供视频工作流自动化与自定义视频编辑器搭建能力。核心功能包括Typescript视频模板开发、浏览器端实时预览渲染、MP4格式视频导出,可满足大规模批量视频生成、广告素材A/B测试、网页端视频编辑器搭建、互动游戏视频内容生成等多元场景需求。开发者无需依赖传统桌面端剪辑软件,通过代码即可实现复杂视频效果的可控生成,降低批量视频生产的人力成本,提升视频内容迭代效率。
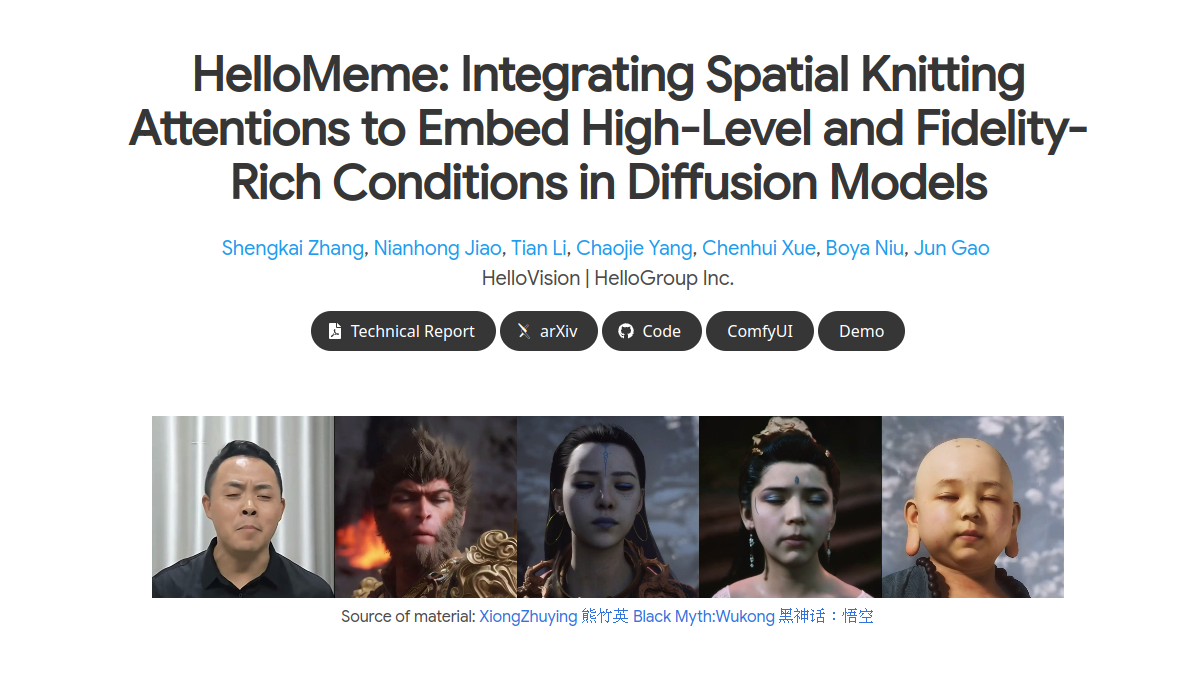
HelloMeme
HelloMeme是一款基于扩散模型的AI视频生成工具,核心定位是为用户提供高保真、多条件控制的视频生成服务。核心功能包含:支持驱动视频帧特征输入生成对应动态内容,内置优化后的Animatediff模块提升视频连续性,支持ARKit面部混合形状控制角色表情,兼容SD1.5生态的Lora与Checkpoint模型。目标用户涵盖AI内容创作者、动画设计师、虚拟形象运营者、短视频制作者、学术研究人员等。使用场景包含虚拟主播动态视频制作、短视频创意片段生成、动画分镜动态演示、AI艺术创作实验、虚拟角色表情驱动测试等,能够满足不同用户对可控AI视频生成的需求。
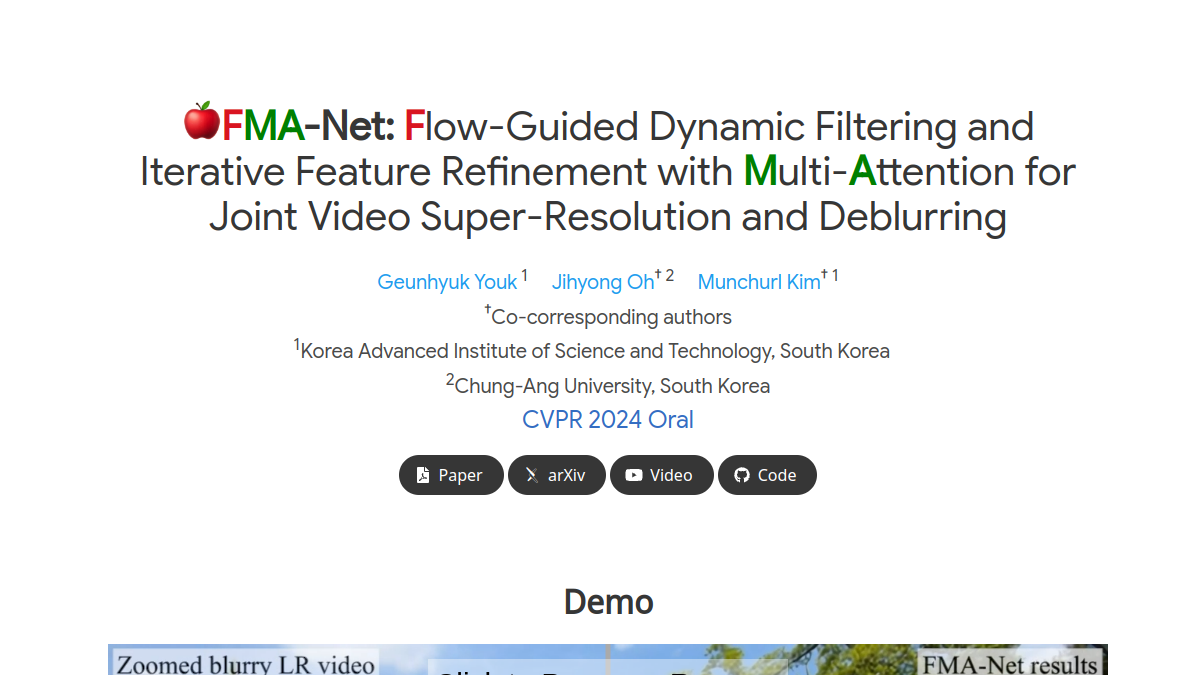
FMA-Net
FMA-Net是由韩国科学技术院VIC实验室推出的视频超分辨率与去模糊深度学习模型站点,核心为实现低分辨率模糊视频的高质量清晰化修复。站点搭载流引导动态过滤、多注意力迭代特征精炼两大核心技术,可应对视频中的大幅度动作场景,实现超分辨率与去模糊任务的联合处理。目标用户覆盖计算机视觉研究人员、视频内容创作者、视频修复从业者、多媒体开发工程师等群体,可用于老旧影像修复、监控视频画质增强、自媒体素材画质提升、学术研究算法对比等多类场景。
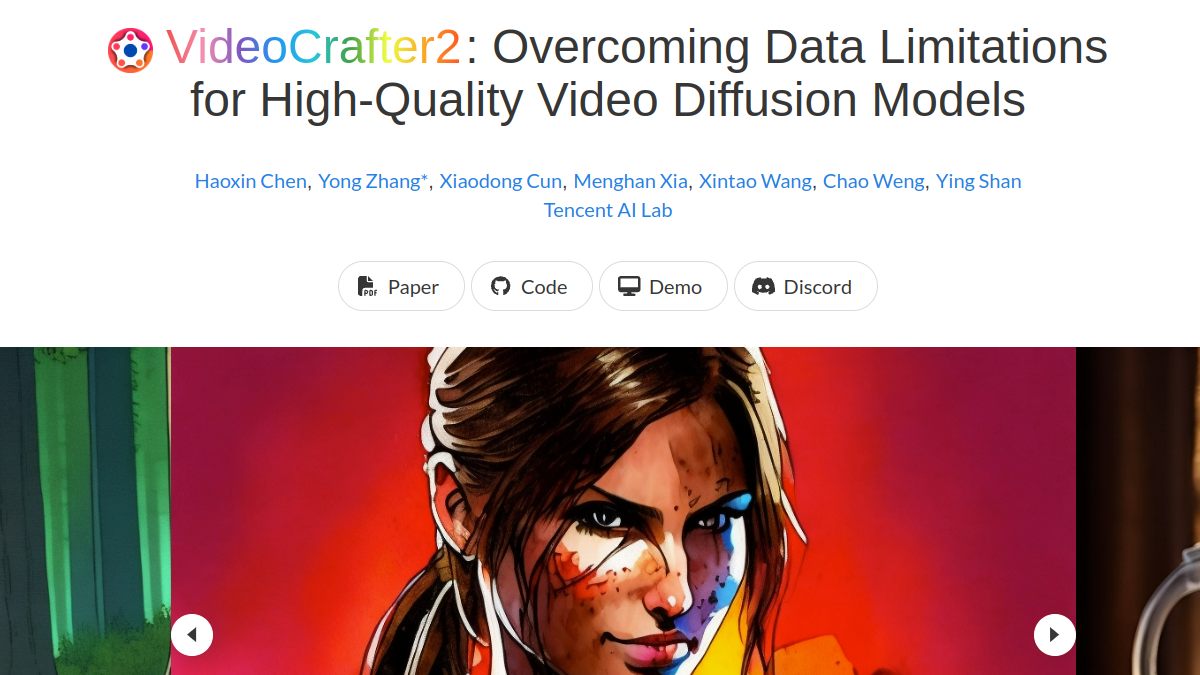
VideoCrafter2
VideoCrafter2是由香港中文大学CVC实验室开发的开源视频生成AI模型展示平台,核心定位为文本驱动的高保真视频生成工具。平台支持文本生成照片级视频、精细运动参数控制、多概念组合生成三类核心功能,面向内容创作者、动画从业者、广告设计人员、AI研究人员等群体,可应用于短视频内容制作、动画分镜生成、广告创意预览、AI视频技术研究等多个场景,用户仅需输入文本提示词即可获得对应的动态视频内容。
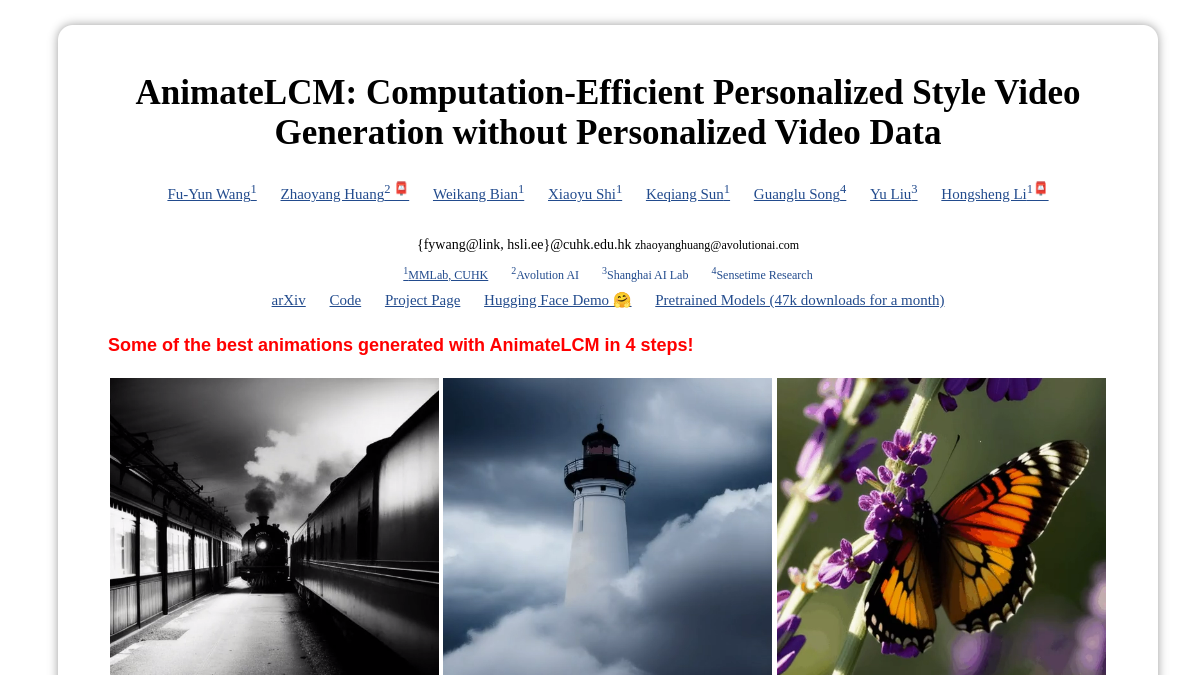
AnimateLCM
AnimateLCM是基于深度学习技术开发的动画视频生成模型官网,核心定位是为用户提供低采样步高保真的动画视频生成能力。核心功能包括高步效动画视频生成、解耦一致性学习训练、Stable Diffusion生态插件兼容,可支持图像转视频、布局转视频等生成需求。目标用户覆盖AI视频研发人员、动画创作者、内容制作团队、计算机视觉研究者等群体,可应用于动画短片制作、创意内容demo生成、视频生成技术研发测试、定制化动态视觉内容制作等多个场景。
Motion-I2V
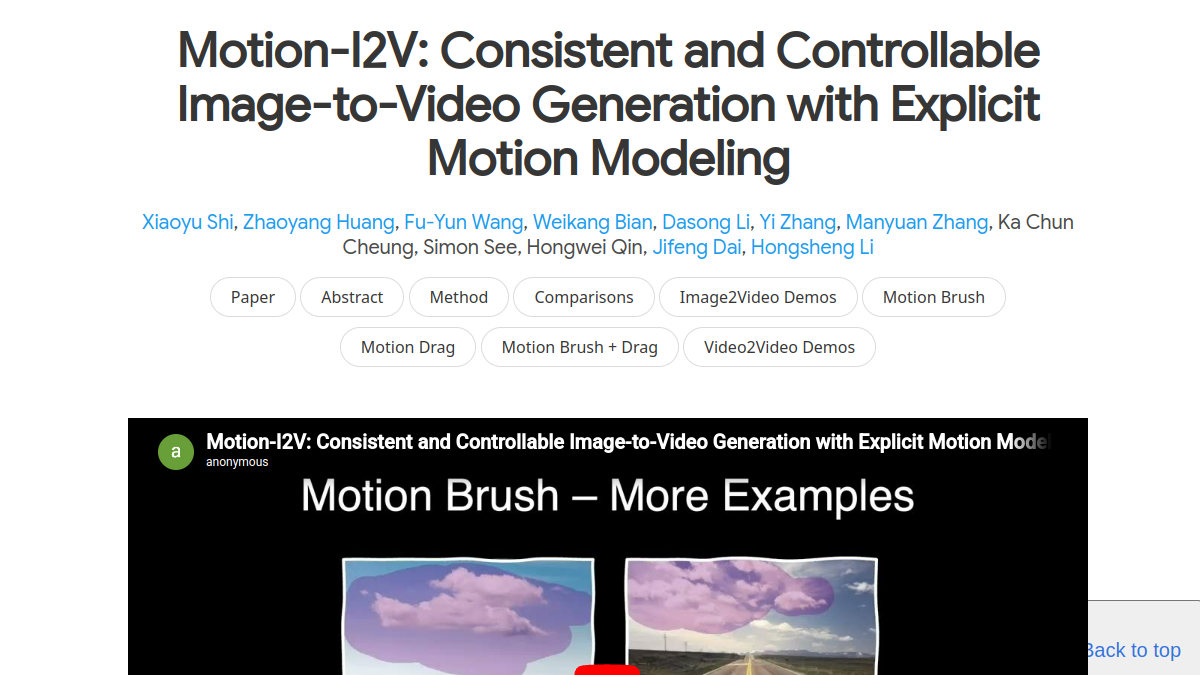
Motion-I2V是专注于图像到视频生成的技术框架展示站点,核心面向AI生成内容领域的研究者与开发者,提供可控且一致性更高的图像转视频方案。其核心功能包括两阶段式图像转视频生成,支持大运动与视角变化场景下的稳定输出;可配置的稀疏轨迹控制功能,允许用户自定义运动路径与作用区域;零样本视频到视频转换能力,无需额外训练即可完成视频风格或内容调整。适合AIGC从业者验证视频生成效果、计算机视觉研究者对比算法性能、内容创作者尝试静态素材动态化的各类场景。
Animate-X
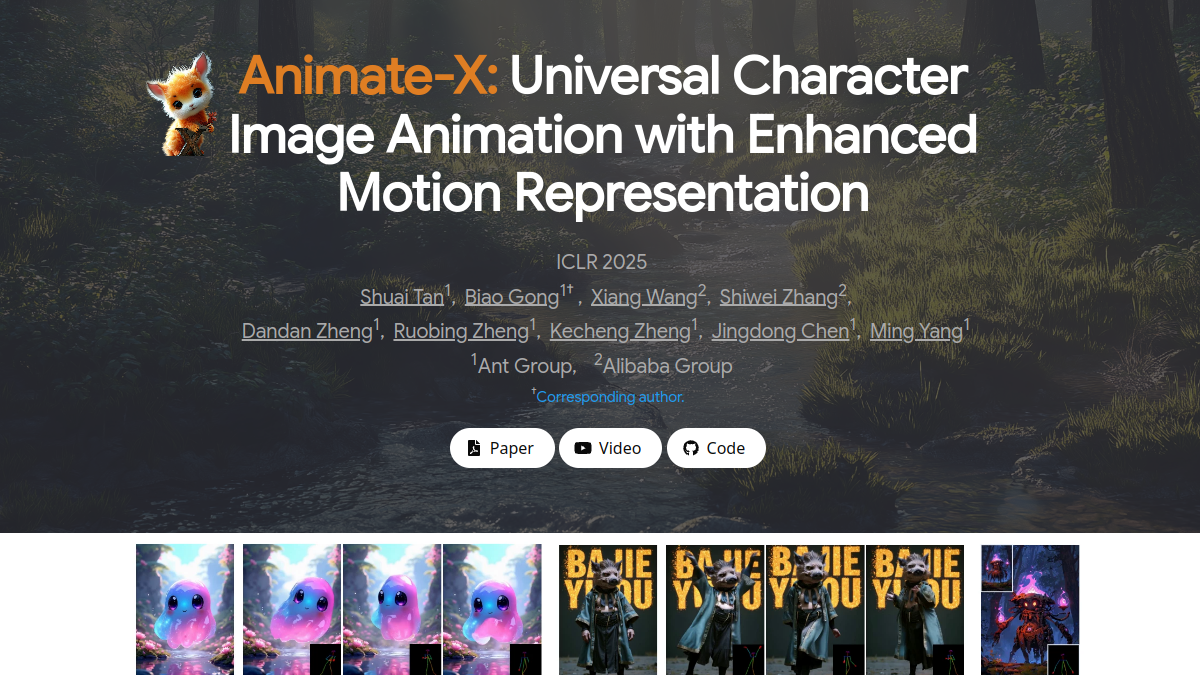
Animate-X是一款基于LDM技术的通用动画生成框架,核心定位为面向各类角色的动作迁移工具,支持人物、拟态角色等多种对象的动画生成。其核心功能包括驱动视频运动模式捕捉、多类型角色动作迁移、动画效果量化评估三大模块。主要面向动画创作者、游戏开发人员、AI内容制作者、学术研究人员等群体,可应用于短视频角色动画制作、游戏角色动作批量生成、虚拟偶像内容生产、动画技术学术研究等多个场景,帮助用户降低角色动画制作的技术门槛,提升动作迁移的匹配度与生成效果的合理性。

VidPanos
VidPanos是一款专注于普通平移视频转全景视频的在线工具,核心基于生成视频模型与空间时间外推技术,可将用户随手拍摄的横向平移视频转换为同时长的全景视频内容,解决了静态全景图无法还原场景动态元素的问题。核心功能包括平移视频全景转换、动态场景元素保留、多类型野外场景适配,目标用户覆盖视频创作者、全景内容开发者、文旅宣传从业者、户外记录爱好者等群体,适用于制作沉浸式旅行vlog、景区全景宣传素材、户外动态场景存档、全景交互内容原型等多个场景。

Hallo2
Hallo2是复旦大学生成视觉团队研发的人像图像动画技术演示站点,核心基于优化后的潜在扩散生成模型,可实现音频驱动的静态人像动效生成。核心功能包括音频驱动长时人像视频生成、4K分辨率视频输出、文本提示辅助表情控制三类,面向AI视频创作者、数字内容制作从业者、高校相关领域研究人员开放,可应用于虚拟数字人内容制作、老照片人像动态化还原、短视频个性化动效创作、学术技术效果验证等多个场景。

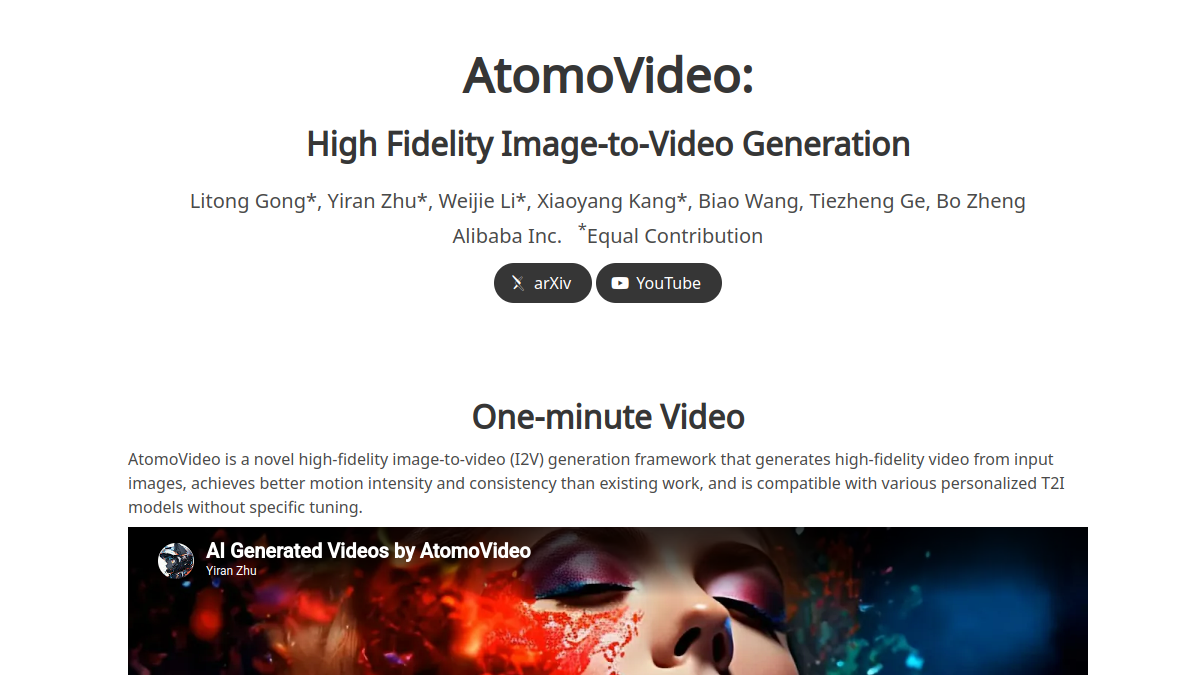
AtomoVideo
AtomoVideo是专注于图像转视频生成的开源技术框架官网,核心为用户提供高保真I2V(图像到视频)生成能力,可基于单张输入图像生成动态视频内容。核心功能包括基础图像转视频生成、自定义运动参数调节、多类T2I模型兼容适配三类功能,面向AI生成内容创作者、视觉设计从业者、短视频制作人员、AI技术研究人员等群体,可满足短视频素材制作、创意视觉内容产出、AI生成技术测试、个性化动态内容创作等多场景使用需求,无需复杂的模型适配调整即可完成内容生成操作。
关于视频与动画
视频与动画类AI工具是依托生成式AI、动作捕捉、智能剪辑等技术,解决视频制作周期长、动画产出门槛高、后期处理流程繁琐等痛点的工具集合,典型使用场景涵盖短视频批量生成、3D动画快速制作、真人动作转动画素材、影视后期智能补全、自媒体内容快速产出等多个领域。
这类工具的形态与能力差异明显,通用类工具主打全流程视频剪辑、图文转视频等普惠性功能,面向普通内容创作者降低入门门槛;垂直类工具则聚焦动作捕捉、专业动画渲染、特定风格动画生成等细分场景,服务专业影视、动画从业者。定价模式上多数工具提供基础功能免费试用,高阶专业功能、批量产出权限、高清导出权益需开通付费套餐,不同工具的能力边界随技术迭代持续调整。
选型时可遵循三条可操作建议:普通自媒体创作者优先选择支持图文一键转视频、内置海量模板的轻量化工具,降低学习成本;专业动画从业者可优先匹配支持动作捕捉、高精度渲染的垂直类工具,满足专业产出需求;有批量内容产出需求的用户,优先选择支持批量导出、API对接能力的工具,提升整体制作效率。
视频与动画常见问题
视频与动画工具怎么选
先明确自身使用场景,普通内容创作者选轻量化模板类工具,专业从业者选支持高精度渲染、动作捕捉的垂直类工具,批量产出需求用户优先选带批量导出功能的产品。
视频与动画工具免费还是收费
多数这类工具提供基础功能免费试用,可满足入门级制作需求,高阶专业功能、高清导出、批量产出等权益需要开通对应的付费套餐解锁。
视频与动画工具适合谁用
这类工具覆盖多类人群,包含自媒体内容创作者、专业动画制作从业者、影视后期工作人员,以及有日常短视频产出需求的普通办公用户。