
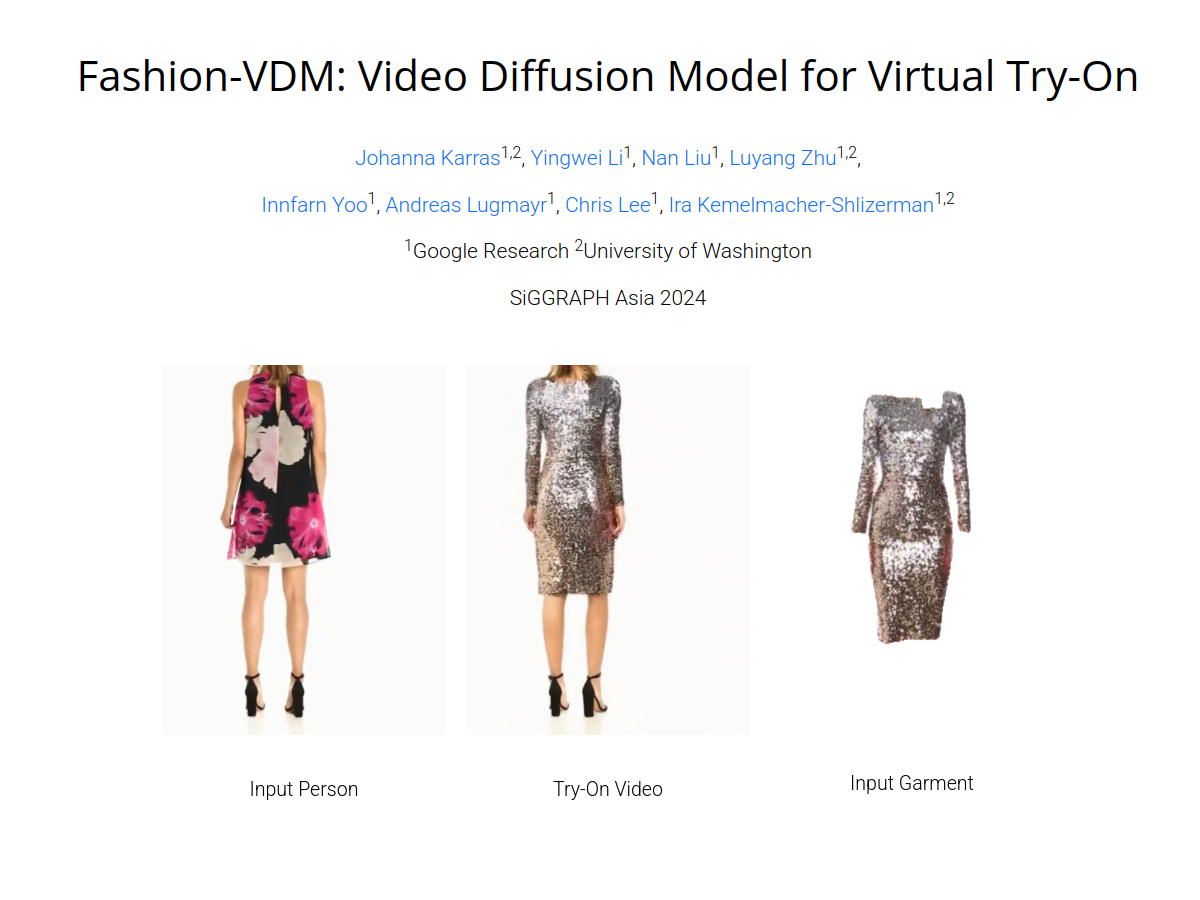
Fashion-VDM
Fashion-VDM是聚焦于视频虚拟试穿场景的视频扩散模型工具,核心定位是实现高还原度的动态虚拟试穿效果生成。其核心功能包括:支持单张衣物图片与人物动作视频双输入,输出人物穿着目标衣物的连贯试穿视频;生成过程保留人物原有身份特征与动作轨迹,同时还原衣物纹理、褶皱等细节;采用渐进式训练策略,可生成最高64帧、分辨率512px的稳定试穿视频。目标用户覆盖服装电商从业者、虚拟内容创作者、服饰研发人员、计算机视觉研究者等群体,可应用于商品展示视频制作、虚拟穿搭内容创作、服装设计效果验证、相关领域技术研发等多种场景,为动态虚拟试穿需求提供技术解决方案。
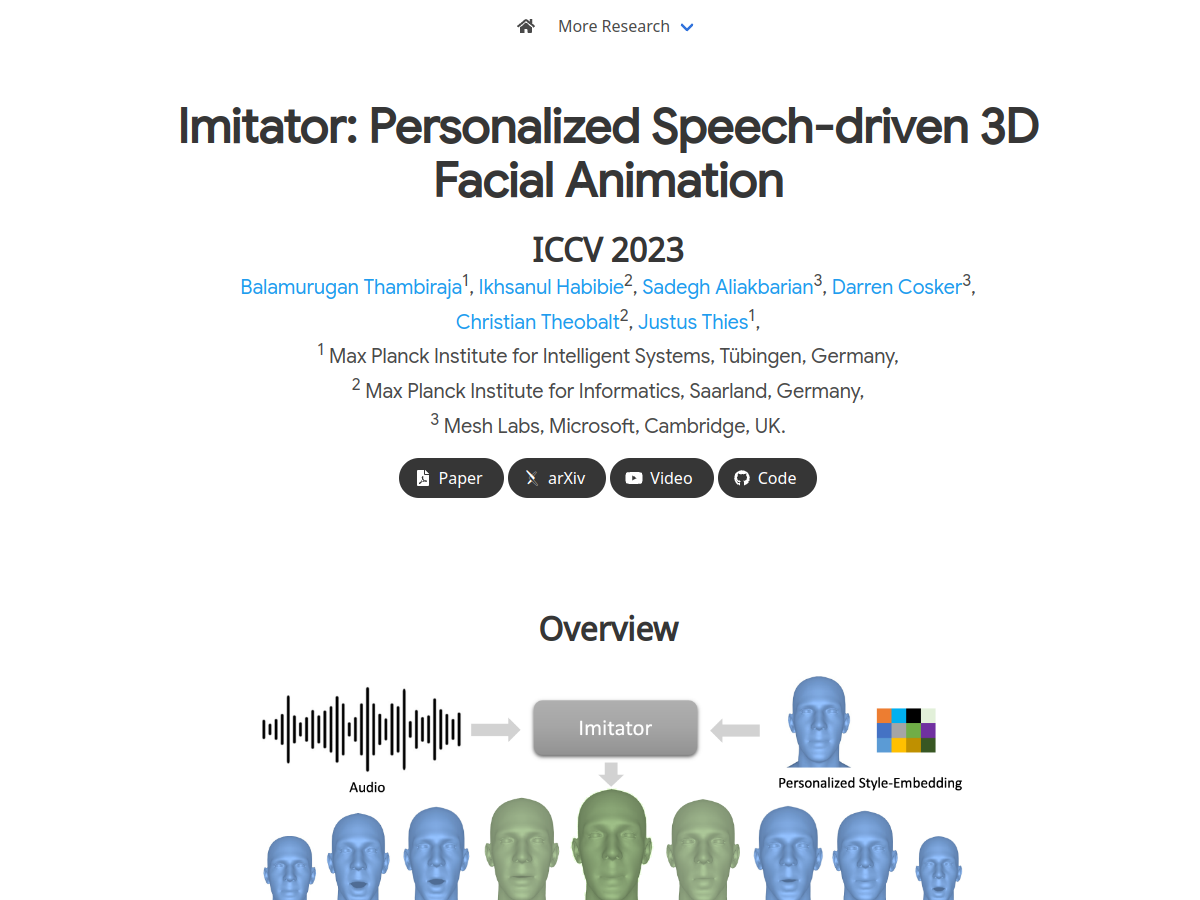
Imitator
Imitator是专注于个性化语音驱动3D面部动画生成的技术工具网站,核心基于深度学习模型实现音频到面部动作的精准映射。支持通过短参考视频提取用户专属面部运动风格特征,可生成符合发音规律的唇部动态,尤其对双唇辅音的唇部闭合动作匹配度较高,还可导出适配主流3D引擎的动画数据。目标用户涵盖3D动画从业者、游戏开发人员、虚拟数字人创作者、科研人员等群体,适用于短视频虚拟角色制作、游戏角色语音动画匹配、虚拟主播实时驱动、影视动画后期配音对齐等多个场景,可降低面部动画手动制作的工作量。

DisPose
DisPose是聚焦于人类图像动画生成的技术演示站点,核心功能包含基于参考图像与驱动视频的人物动画生成、运动对齐与身份一致性保持、即插即用的控制信号适配三类。站点面向AI视频生成从业者、计算机视觉研究人员、内容创作者、动画制作人员等群体,可应用于数字人内容制作、学术技术验证、短视频动效制作、虚拟形象驱动等多种场景,帮助用户在不需要额外复杂输入的前提下,生成动作自然、身份特征稳定的人物动画视频。

VideoVAEPlus
VideoVAEPlus是一款聚焦视频编码与生成领域的技术工具,核心定位为优化的视频变分自编码器,可实现视频冗余降低与高质量视频编解码。核心功能包含时间感知空间压缩、轻量级运动压缩、文本指导编码优化三个模块,目标用户覆盖AI视频算法研发人员、多媒体内容处理从业者、高校计算机相关专业研究人员等,可用于视频生成模型底层开发、视频存储压缩方案优化、视频重建效果迭代等场景。
Kandinsky Deforum
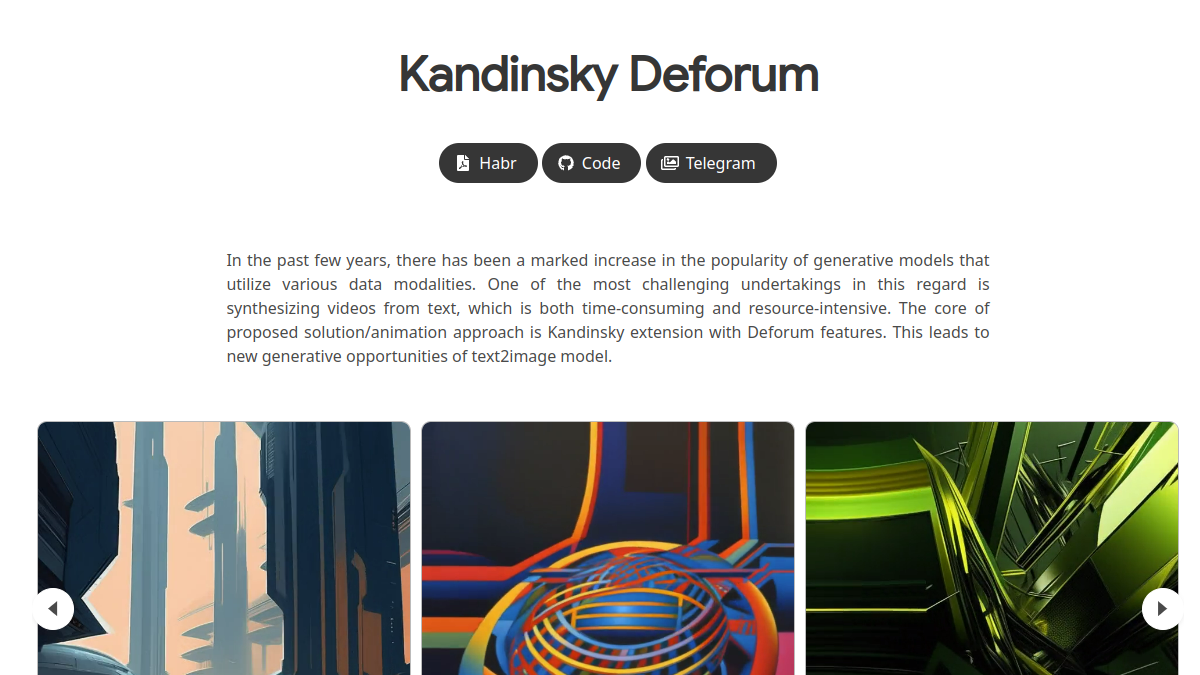
Kandinsky Deforum是结合Kandinsky图像生成框架与Deforum动态生成逻辑的AI内容生成工具,核心定位为面向创意场景的文本驱动多模态生成平台。平台支持文本生成动态视频、静态图像,还可基于现有图像进行动态化扩展,支持参数自定义调节生成效果。该工具面向创意设计从业者、影视内容创作者、AI艺术爱好者、科研人员等群体,可应用于动态艺术创作、短视频视觉素材制作、概念视频demo搭建、科研实验可视化等多种场景,为用户提供灵活的AI生成内容解决方案。


VideoGrain
VideoGrain是基于扩散模型的视频编辑技术展示平台,核心定位是为内容创作者、技术研究者提供可交互的多粒度视频编辑技术演示与参考。平台支持文本驱动的指定区域视频编辑,可实现跨帧语义一致的内容修改,同时保留原有视频的运动逻辑与画面风格;支持不同编辑粒度的调节,用户可选择从局部物体替换到整体场景风格调整的不同编辑强度;还提供多组对比案例,直观呈现技术效果与传统编辑方法的差异。平台目标用户包括视频后期从业者、AI视频技术研究者、广告内容制作人员、高校计算机相关专业师生等,可用于影视后期片段修改、广告创意内容快速迭代、视频编辑技术研发参考、学术研究效果验证等场景。
Video-T1
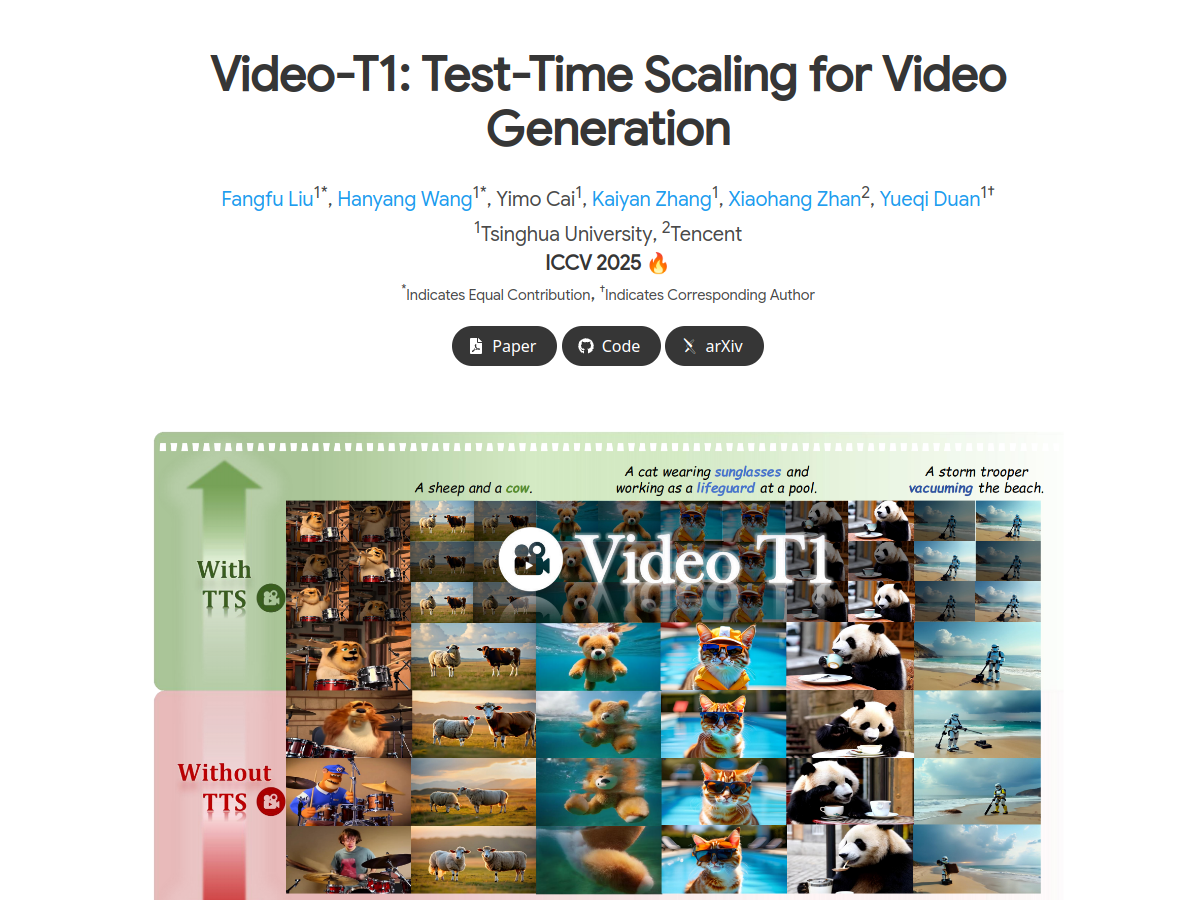
Video-T1是基于测试时间缩放技术(TTS)构建的开源视频生成模型演示站点,核心定位是为视频生成领域的相关从业者提供高质量视频生成效果的测试与技术验证平台。站点支持文本转视频生成、生成参数自定义调整、传统方法效果对比、生成结果下载、TTS技术原理说明等核心功能,目标用户涵盖人工智能领域研究人员、视频生成方向开发者、数字内容创作者、高校计算机相关专业学生等群体。可应用于视频生成技术学术研究验证、技术选型前的效果测试、数字内容原型创作、教学过程中的技术演示等多种场景,帮助用户直观了解测试时间缩放技术对视频生成质量的提升效果。