
Hex
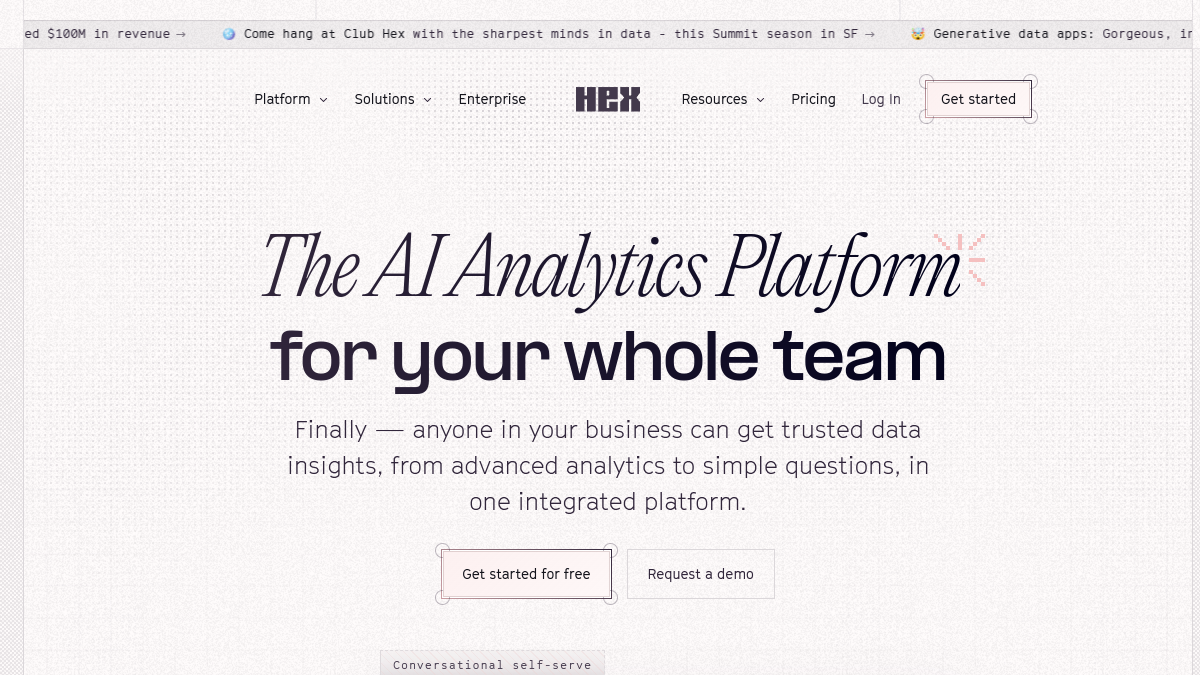
Hex是一款面向数据分析与数据科学场景的协作型数据平台,核心定位是为团队提供统一的数据分析工作空间。平台支持SQL查询、Python代码运算、无代码可视化三类核心能力,同时内置协作批注、版本回溯、成果共享等配套功能。目标用户覆盖数据分析师、数据科学家、业务运营人员、产品经理等不同数据能力层级的群体,可应用于日常业务报表产出、专项数据分析项目落地、跨部门数据结论同步、数据模型迭代验证等多种场景,帮助团队减少数据工作中的工具切换成本,提升数据协作效率。
Boden Annotation Service Enhancement (BASE)
BASE是博登智能推出的多模态数据标注处理平台,核心定位为企业提供从数据采集、清洗、标注到验证的全流程数据处理服务。平台支持语音、文本、图像、视频、点云等多模态数据处理,内置AI辅助标注功能可降低标注成本,配套全流程质量管控机制保障标注结果准确度。目标用户涵盖自动驾驶、智能医疗、NLP研发、音视频算法开发等领域的企业及研发团队,可在算法训练数据准备、标注项目外包管理、多模态数据集构建等场景中使用,满足不同行业的数据标注定制化需求。

SuperAnnotate
SuperAnnotate是面向AI开发场景的端到端数据标注、版本控制与管理平台,核心定位是为AI研发团队提供高质量训练数据生产全链路支持。平台支持图像、视频、文本多模态数据标注,内置标注质量校验、项目流程管理、AI辅助标注自动化功能,可帮助团队缩短AI模型训练数据准备周期。目标用户覆盖AI算法研发团队、数据标注服务商、自动驾驶研发企业、医疗影像AI开发团队、NLP产品研发团队等,适用于计算机视觉模型训练数据标注、大语言模型微调数据集构建、AI项目全流程数据资产管控等场景。
LatenceTech
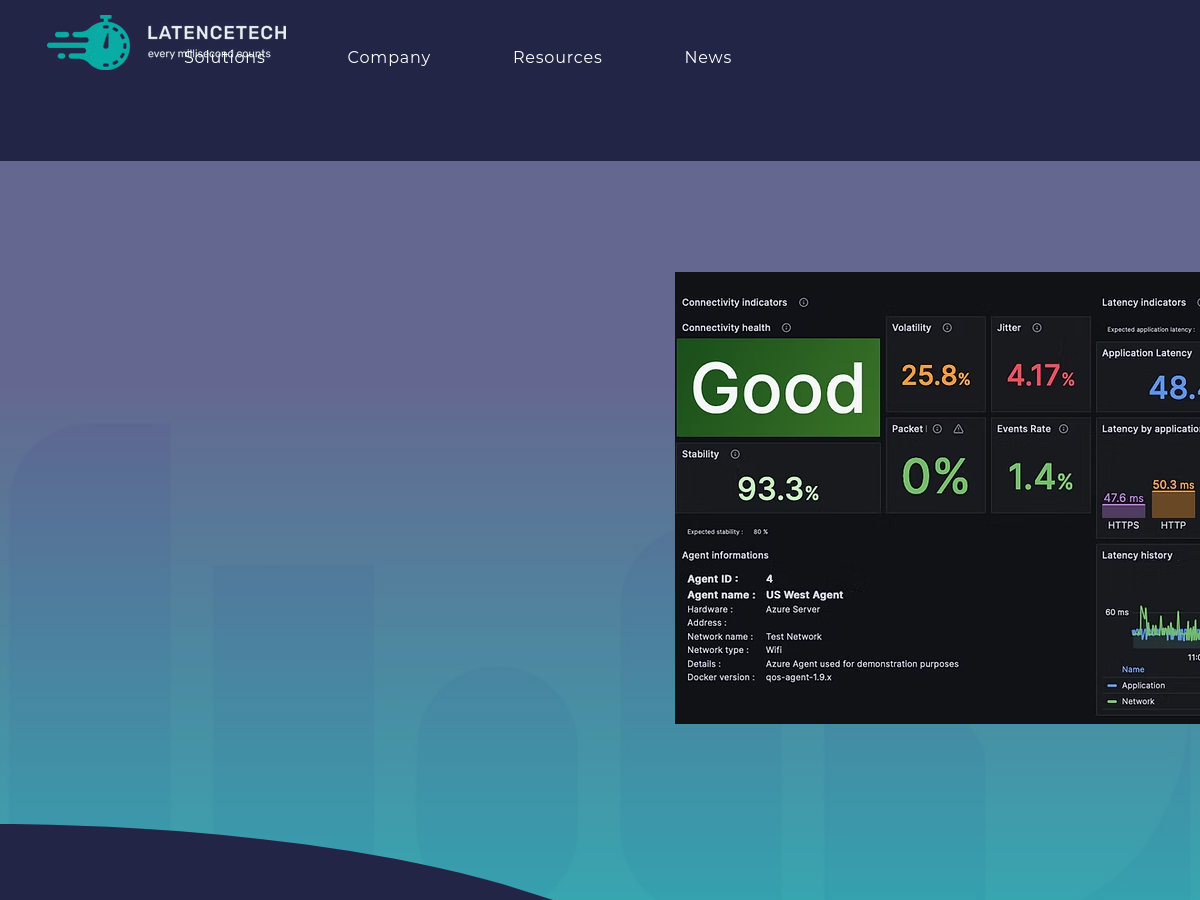
LatenceTech是专注于网络质量监测与性能优化的技术服务平台,核心面向各类网络运维、通信技术相关的企业及团队提供网络分析解决方案。平台支持有线、无线及5G公网/专网的全场景网络数据监测,可实现网络延迟、传输稳定性等多维度指标的实时可视化呈现,同时搭载AI预测能力可提前识别潜在网络风险。该平台适合通信运营商、企业IT运维团队、5G专网部署方等用户使用,可应用于日常网络运维巡检、新网络架构上线前性能测试、网络故障前置排查、业务服务质量优化等多种工作场景,帮助用户降低网络故障带来的业务影响,提升网络运行的稳定性与效率。

Strella
Strella是基于人工智能技术的客户研究平台,核心定位是为企业及研究人员提供自动化、智能化的用户需求与反馈采集分析服务。核心功能包括AI主持的结构化访谈、多语言用户反馈自动处理、实时访谈数据综合分析,可满足不同行业的用户调研、产品需求验证、客户满意度评估等场景需求,帮助研究人员减少手动访谈与数据整理的工作量,缩短研究周期,支撑决策制定。

Rayyan
Rayyan是面向科研领域的智能研究协作平台,核心定位是为科研人员简化文献综述、系统综述的全流程工作。平台内置文献智能筛选、团队协作标注、研究流程管理三类核心功能,可自动识别文献内容特征、适配不同学科的综述规范,同时支持多成员异步协作。目标用户涵盖高校科研人员、硕博研究生、医药领域研发人员、行业研究分析师等群体,可用于文献初步筛选、系统综述项目推进、多团队联合科研攻关等场景,帮助用户降低文献整理环节的重复工作量。
Promega
Promega是生命科学领域处于前列的生物试剂与技术解决方案提供商,核心定位为面向全球科研及产业用户提供生命科学研究工具与技术支持。其核心功能包括:覆盖分子生物学、细胞分析、蛋白研究等领域的试剂产品供给,适配科研项目、药物研发、体外诊断等场景的集成技术系统开发,以及面向企业内部运营与客户服务的智能化管理方案支持。目标用户涵盖高校科研人员、生物医药企业研发团队、体外诊断机构技术人员、生命科学相关实验室管理员等,可应用于基础生命科学研究、创新药靶点验证、临床检测方法开发、生物试剂供应链管理等多个场景。

CustomerIQ
CustomerIQ是一款AI辅助的团队客户研究平台,核心定位是帮助企业统一整合多渠道客户反馈,通过智能化分析挖掘客户需求、痛点与偏好。平台支持跨渠道反馈自动归集、AI标签化分类整理、多维度语义搜索三大核心功能,面向产品、运营、客户成功、市场、销售、用户研究等岗位的从业者,可应用于产品迭代需求调研、客户满意度复盘、客群特征分析、投诉问题定位、市场策略调整等多种业务场景,助力团队基于真实客户反馈做出更贴合市场需求的决策。

ResFields
ResFields是专注于复杂时空信号表示的深度学习技术官网,核心为引入时变权重的多层感知机残差建模方案。支持将残差参数模块无缝集成到现有神经辐射场、动态三维重建等技术框架中,可实现2D视频逼近精度提升、动态形状建模效果优化、动态NeRF重建质量增强三类核心功能。目标用户覆盖计算机视觉领域科研人员、三维内容开发工程师、视频处理算法研究员、深度学习算法开发者等群体,可应用于动态场景三维重建、影视级动态内容生成、动态物体高精度建模、长时序视频压缩编码等多种场景。
Scikit Learn
Scikit Learn是基于Python生态的开源机器学习工具库官网,核心定位为机器学习从业者提供标准化、易上手的算法实现与开发支持。核心功能包括覆盖分类、回归、聚类、降维等全场景的经典机器学习算法实现,配套的数据预处理、特征工程、模型评估完整工具链,以及多语言版本的详细教程与API文档。目标用户覆盖高校机器学习相关专业学生、企业算法开发工程师、数据分析师、AI项目研发人员。可使用于课程作业中的算法复现、工业级数据分析场景的模型快速搭建、机器学习项目的原型验证、算法效果对比实验等多种场景,依托BSD开源许可证支持商业项目使用,无需额外授权。
Onvo AI
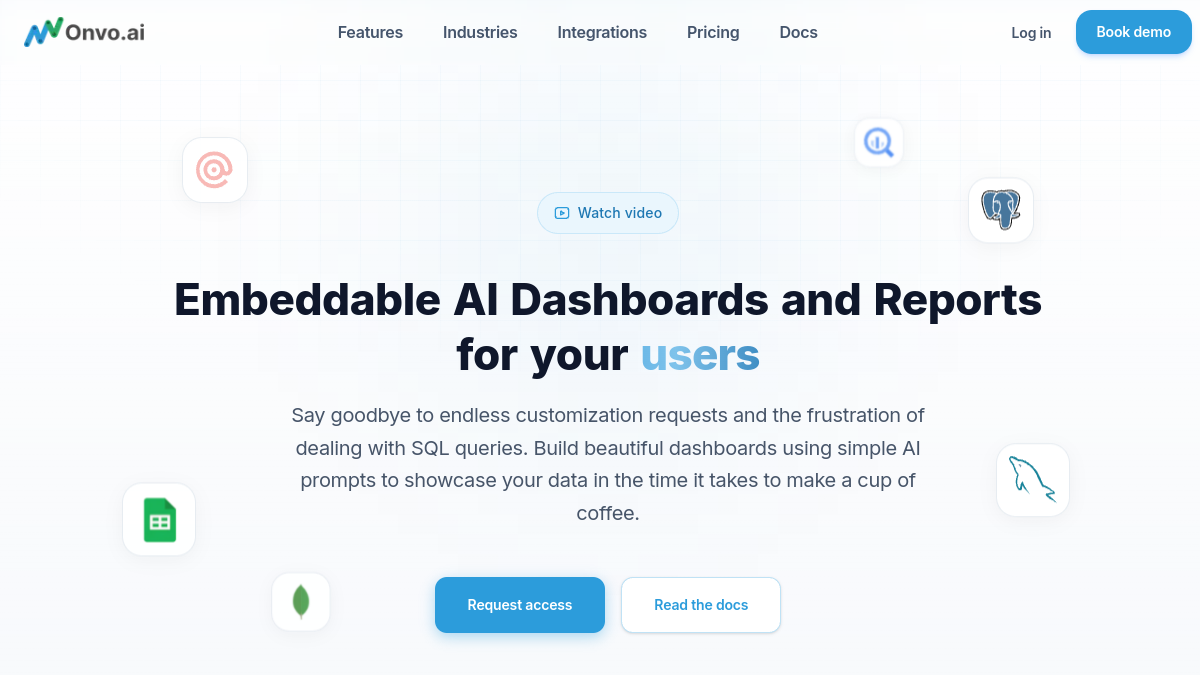
Onvo AI是一款专注于数据可视化领域的仪表板与报告构建开发工具包(SDK),核心定位是帮助开发人员在自有产品中快速集成标准化、可定制的数据展示模块。核心功能包括多数据源统一接入、AI自然语言生成可视化图表、嵌入式仪表板自定义配置三类,服务于需要在产品内加入数据展示能力的开发团队、企业数字化部门等用户,可应用于SaaS产品数据模块开发、企业内部运营看板搭建、客户数据报告系统定制等多种场景,降低开发数据可视化功能的时间与人力成本。
Eureka
Eureka是面向强化学习领域的奖励设计算法项目站点,核心定位是依托大语言模型能力实现自动化、高性能的奖励函数生成与优化。核心功能包括基于大语言模型的零样本奖励代码生成、奖励函数的多轮迭代进化优化、强化学习训练效果的适配验证。目标用户覆盖强化学习研究人员、机器人开发工程师、AI算法开发者、高校AI相关专业师生。使用场景包含机器人控制策略训练研发、强化学习环境 reward 设计、复杂技能学习任务的算法验证、学术研究中的对比实验基准搭建等,可帮助用户降低人工设计奖励函数的门槛,提升强化学习训练的效果上限。

DataMorf
DataMorf是面向企业用户的B2B SaaS平台,核心定位为自动化数据管道与工作流管理工具。平台支持多数据源无缝对接、实时数据转换处理、自定义工作流编排三大核心功能,可帮助企业减少数据处理环节的人工操作,提升数据流转效率,降低运营成本。适合企业数据团队、业务运营人员、IT管理岗等用户,应用于跨系统数据同步、客户数据统一管理、业务报表自动生成、多源数据合并分析等场景。
WEKA
WEKA是面向多云与本地部署环境的统一数据管理平台,核心定位是为AI训练、生命科学研究、媒体内容制作等下一代工作负载提供全链路数据支撑服务。平台具备分布式并行数据处理能力,可实现PB级数据的低延迟访问与调度;内置AI推理优化引擎,能降低大模型训练过程中的数据IO开销;支持多云存储统一纳管,用户无需切换平台即可管理不同云服务商与本地服务器中的数据资源。目标用户覆盖科技企业研发团队、科研机构数据部门、媒体制作团队、医疗研究机构等群体,可满足AI大模型训练、基因测序数据分析、4K/8K视频渲染、工业仿真数据处理、遥感影像解析等多场景的数据管理需求。

Tantl
Tantl是面向企业的数据智能管理平台,核心定位是借助生成式AI降低数据仓库的使用门槛,让非技术人员也能获取业务所需数据支持。平台支持自然语言转数据查询功能,用户无需编写复杂SQL即可获取查询结果;内置企业级数据治理模块,可针对不同表、列设置访问权限,保障数据安全;适配多款主流数据库与数据仓库,可快速完成对接部署。目标用户覆盖企业数据分析人员、业务部门运营人员、数据管理团队及企业决策层,可应用于日常业务数据复盘、专项业务分析、数据权限管控、跨部门数据协作等多种场景,帮助企业缩短数据获取周期,提升数据应用效率。

MATLAB
MATLAB是美国MathWorks公司推出的面向工程与科学计算的专业软件环境,核心定位是为科研、工程领域用户提供集数值计算、数据可视化、算法开发、模型仿真于一体的综合计算平台。其核心功能包括多领域专用工具箱、实时脚本交互式开发、Simulink可视化建模仿真、跨平台代码生成。目标用户覆盖高校师生、科研人员、各领域工程师等群体,可应用于学术研究中的算法验证、工业产品开发中的系统仿真、海量实验数据的分析处理、机器学习与深度学习模型训练、信号与图像处理等多种场景。

Artificial Analysis
Artificial Analysis是专注于AI语言模型与API服务商的独立分析平台,核心定位为中立的AI模型选型参考工具。平台可提供多维度模型性能测评、跨服务商参数对比、实时价格测算功能,面向AI开发人员、企业技术选型负责人、AI产品经理、学术研究人员等群体,适用于AI应用开发前的模型选型、AI服务采购前的成本评估、AI技术趋势调研等多个场景,帮助用户在众多AI模型和API服务商中筛选适配自身需求的选项,降低选型试错成本。

Open Thoughts
Open Thoughts是由Bespoke Labs和DataComp社区主导的开源推理数据集聚合平台,核心定位是为人工智能领域提供可公开使用的高质量推理数据集,助力小模型推理能力训练。平台具备多领域数据集分类检索、数据集质量标注说明、数据集下载权限开放、训练适配指导、社区贡献通道五大核心功能,主要面向AI研究人员、算法开发工程师、高校AI专业师生、模型训练从业者、AI领域教育工作者等群体,可应用于小模型推理能力优化、数学推理模型训练、代码生成模型迭代、AI推理相关学术研究、AI教学实践案例搭建等多个场景,所有公开资源遵循开源协议,可满足非商用及合规商用的研究开发需求。

Bugz.FYI
Bugz.FYI是专注于移动应用用户反馈分析的工具平台,核心定位是通过AI技术帮助开发者从用户公开评论中挖掘应用缺陷。平台支持抓取App Store与Google Play两大应用商店的用户评论,通过语义识别自动定位用户提及的bug问题,可生成结构化bug报告,同时提供bug数量统计、历史趋势分析、同品类应用bug排名等功能。目标用户覆盖移动应用开发者、产品经理、测试工程师、运营人员等,可用于版本迭代前的问题排查、竞品缺陷分析、上线后用户反馈跟踪、产品优化方向调研等场景,帮助团队及时响应用户反馈,针对性修复应用问题。
Jo
Jo(Jokey)是一款面向企业的用户反馈收集与分析工具,核心定位是通过对话式交互采集用户真实想法,助力企业梳理用户需求、迭代产品体验。平台支持多渠道反馈入口部署、反馈内容智能分类打标、需求优先级可视化排序、多角色协作处理等功能,同时可关联产品迭代进度同步给反馈用户。服务的目标用户包括产品经理、用户运营人员、客户成功团队、创业团队负责人、UX设计师、研发管理者,适用于产品上线前需求验证、新版本迭代后用户满意度调研、日常用户诉求归集、客户反馈闭环处理、产品 roadmap 规划等多种场景。
关于研究与数据分析
研究与数据分析类AI工具是面向科研人员、数据从业者及业务分析人员,辅助完成数据归集、清洗、统计建模、可视化及研究报告生成的智能化工具,主要解决传统数据分析流程繁琐、统计门槛高、非专业人员难以快速产出合规研究结论的问题,典型使用场景包括学术课题数据验证、企业经营多维度指标分析、行业调研数据拆解等。
这类工具可分为通用型与垂直型两类,通用型工具覆盖从数据导入到报告输出的全流程,适配多数常规数据分析需求,部分提供基础免费额度供用户体验核心功能;垂直型工具针对特定领域优化,比如适配生物医学统计、社科问卷分析、金融时序数据处理等细分场景,多数采用分层付费模式,解锁高阶建模、大体积数据处理等专属能力。不同工具的能力差异还体现在可视化组件丰富度、自定义分析规则开放程度上,部分工具支持对接第三方数据源实现自动同步更新。
选型时可优先匹配自身所属领域,若从事细分行业研究优先选择对应垂直类工具,减少适配成本;非专业数据分析人员可选择交互门槛低、自带模板库的工具,无需编写复杂代码即可快速产出结果;高频重度使用的用户可优先测试支持批量数据处理、团队协作共享功能的工具,提升多人协同分析的效率。
研究与数据分析常见问题
研究数据分析工具怎么选
先明确自身所属领域与分析需求,细分行业选垂直类工具降低适配成本,非专业人员选低门槛带模板的工具,重度用户选支持批量处理的协作类工具。
研究数据分析工具免费还是收费
多数工具提供基础免费额度供体验核心功能,高阶建模、大体积数据处理、团队协作等专属能力需要通过分层付费解锁,不同工具的付费档位差异较大。
研究数据分析工具适合谁用
适合科研人员、数据从业者、企业业务分析人员,也覆盖需要快速完成调研数据拆解、经营指标分析的非专业数据分析普通用户。