
OpenClaw
OpenClaw是面向中文用户的开源AI助手服务平台,核心定位是降低大语言模型的使用门槛,支持用户通过常用办公、社交渠道调用不同厂商的AI模型。平台核心功能包括多平台适配接入、多模型统一调度、自定义规则配置,覆盖个人日常查询、团队办公协作、内容创作辅助等多元场景,适合有AI工具使用需求的普通用户、企业办公人员、内容创作者、开源技术爱好者等群体使用,无需复杂的开发配置即可快速上手不同大模型的能力。

EverMind
EverMind是一家聚焦AI长期记忆基础设施研发的技术服务平台,核心为各类AI系统提供具备持续身份感知的记忆能力支撑,突破传统无状态AI工具的能力边界。平台核心功能包括开源EverMemOS操作系统部署、长期身份记忆模型调用、多智能体协同记忆框架搭建三类,目标用户覆盖AI应用开发者、智能体研发团队、AI研究机构从业者、企业级AI解决方案服务商等群体,可应用于个性化AI助手开发、多角色协同智能系统搭建、AI长期学习能力研究、企业级知识库与记忆系统整合等多个场景,助力AI系统实现能力的持续迭代与协作效率提升。
Hugging Face
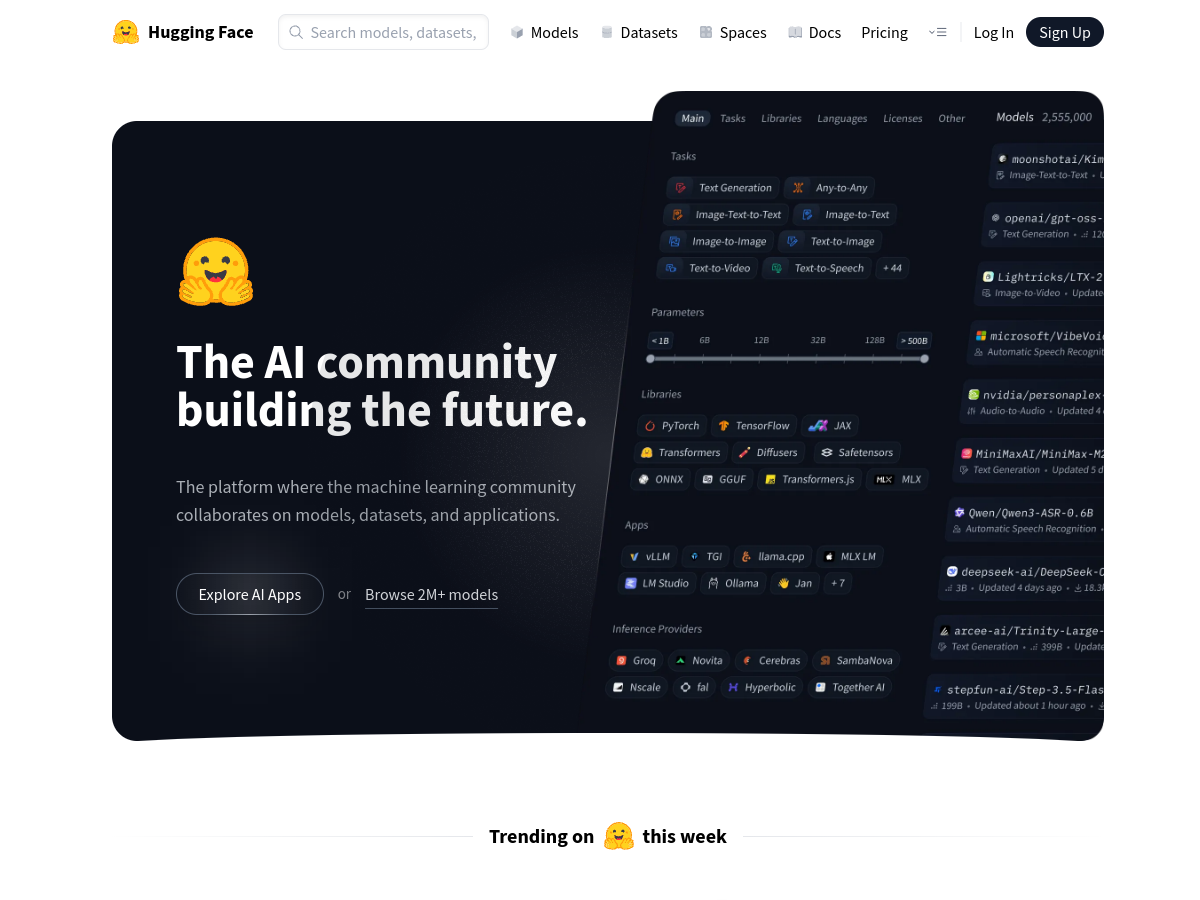
Hugging Face是一个开源AI模型平台与机器学习社区,核心定位是为AI开发人员、研究人员及相关从业者提供一站式AI开发资源与协作空间。平台核心功能包括预训练模型库下载调用、模型在线推理测试、数据集共享管理,同时支持模型训练、部署等全流程开发需求。目标用户覆盖AI领域研究人员、企业开发团队、高校相关专业学生、AI应用创业者等群体,可用于自然语言处理、计算机视觉、语音识别等多领域AI项目的快速开发、学术研究成果复现、AI应用原型搭建等场景,帮助用户降低AI开发的技术门槛,提升项目推进效率。

Llama官网
Llama官网是Meta推出的LLaMA系列大语言模型官方开源平台,核心定位为向全球开发者、研究人员提供开放的大模型技术资源与支持。平台核心功能包括提供8B至405B参数规模的多版本模型下载服务,覆盖多语言文本处理与多模态内容理解能力,同时支持与主流云服务产品深度集成。平台面向AI研发人员、应用开发者、高校科研团队、企业技术部门等群体开放,可应用于自然语言处理研究、AI应用原型开发、企业智能服务搭建、多模态内容生成系统研发等多种场景,助力不同需求的用户基于LLaMA模型开展相关技术探索与落地实践。

DriveVLM
DriveVLM是清华大学MARS实验室推出的自动驾驶研发系统,核心定位是将视觉语言模型能力融入自动驾驶流程,提升复杂场景下的感知与决策表现。该系统具备场景语义描述、多维度场景分析、分层驾驶规划三类核心功能,同时推出混合架构的DriveVLM-Dual版本,平衡大模型推理能力与传统自动驾驶系统的空间计算、实时响应优势。目标用户覆盖自动驾驶领域研究人员、高校相关专业师生、自动驾驶企业技术研发团队,可用于自动驾驶算法迭代、长尾场景处理方案验证、大模型在自动驾驶领域的落地研究等场景,相关实验成果已在nuScenes、SUP-AD公开数据集以及量产实车环境中完成验证。

Pixtral 12B
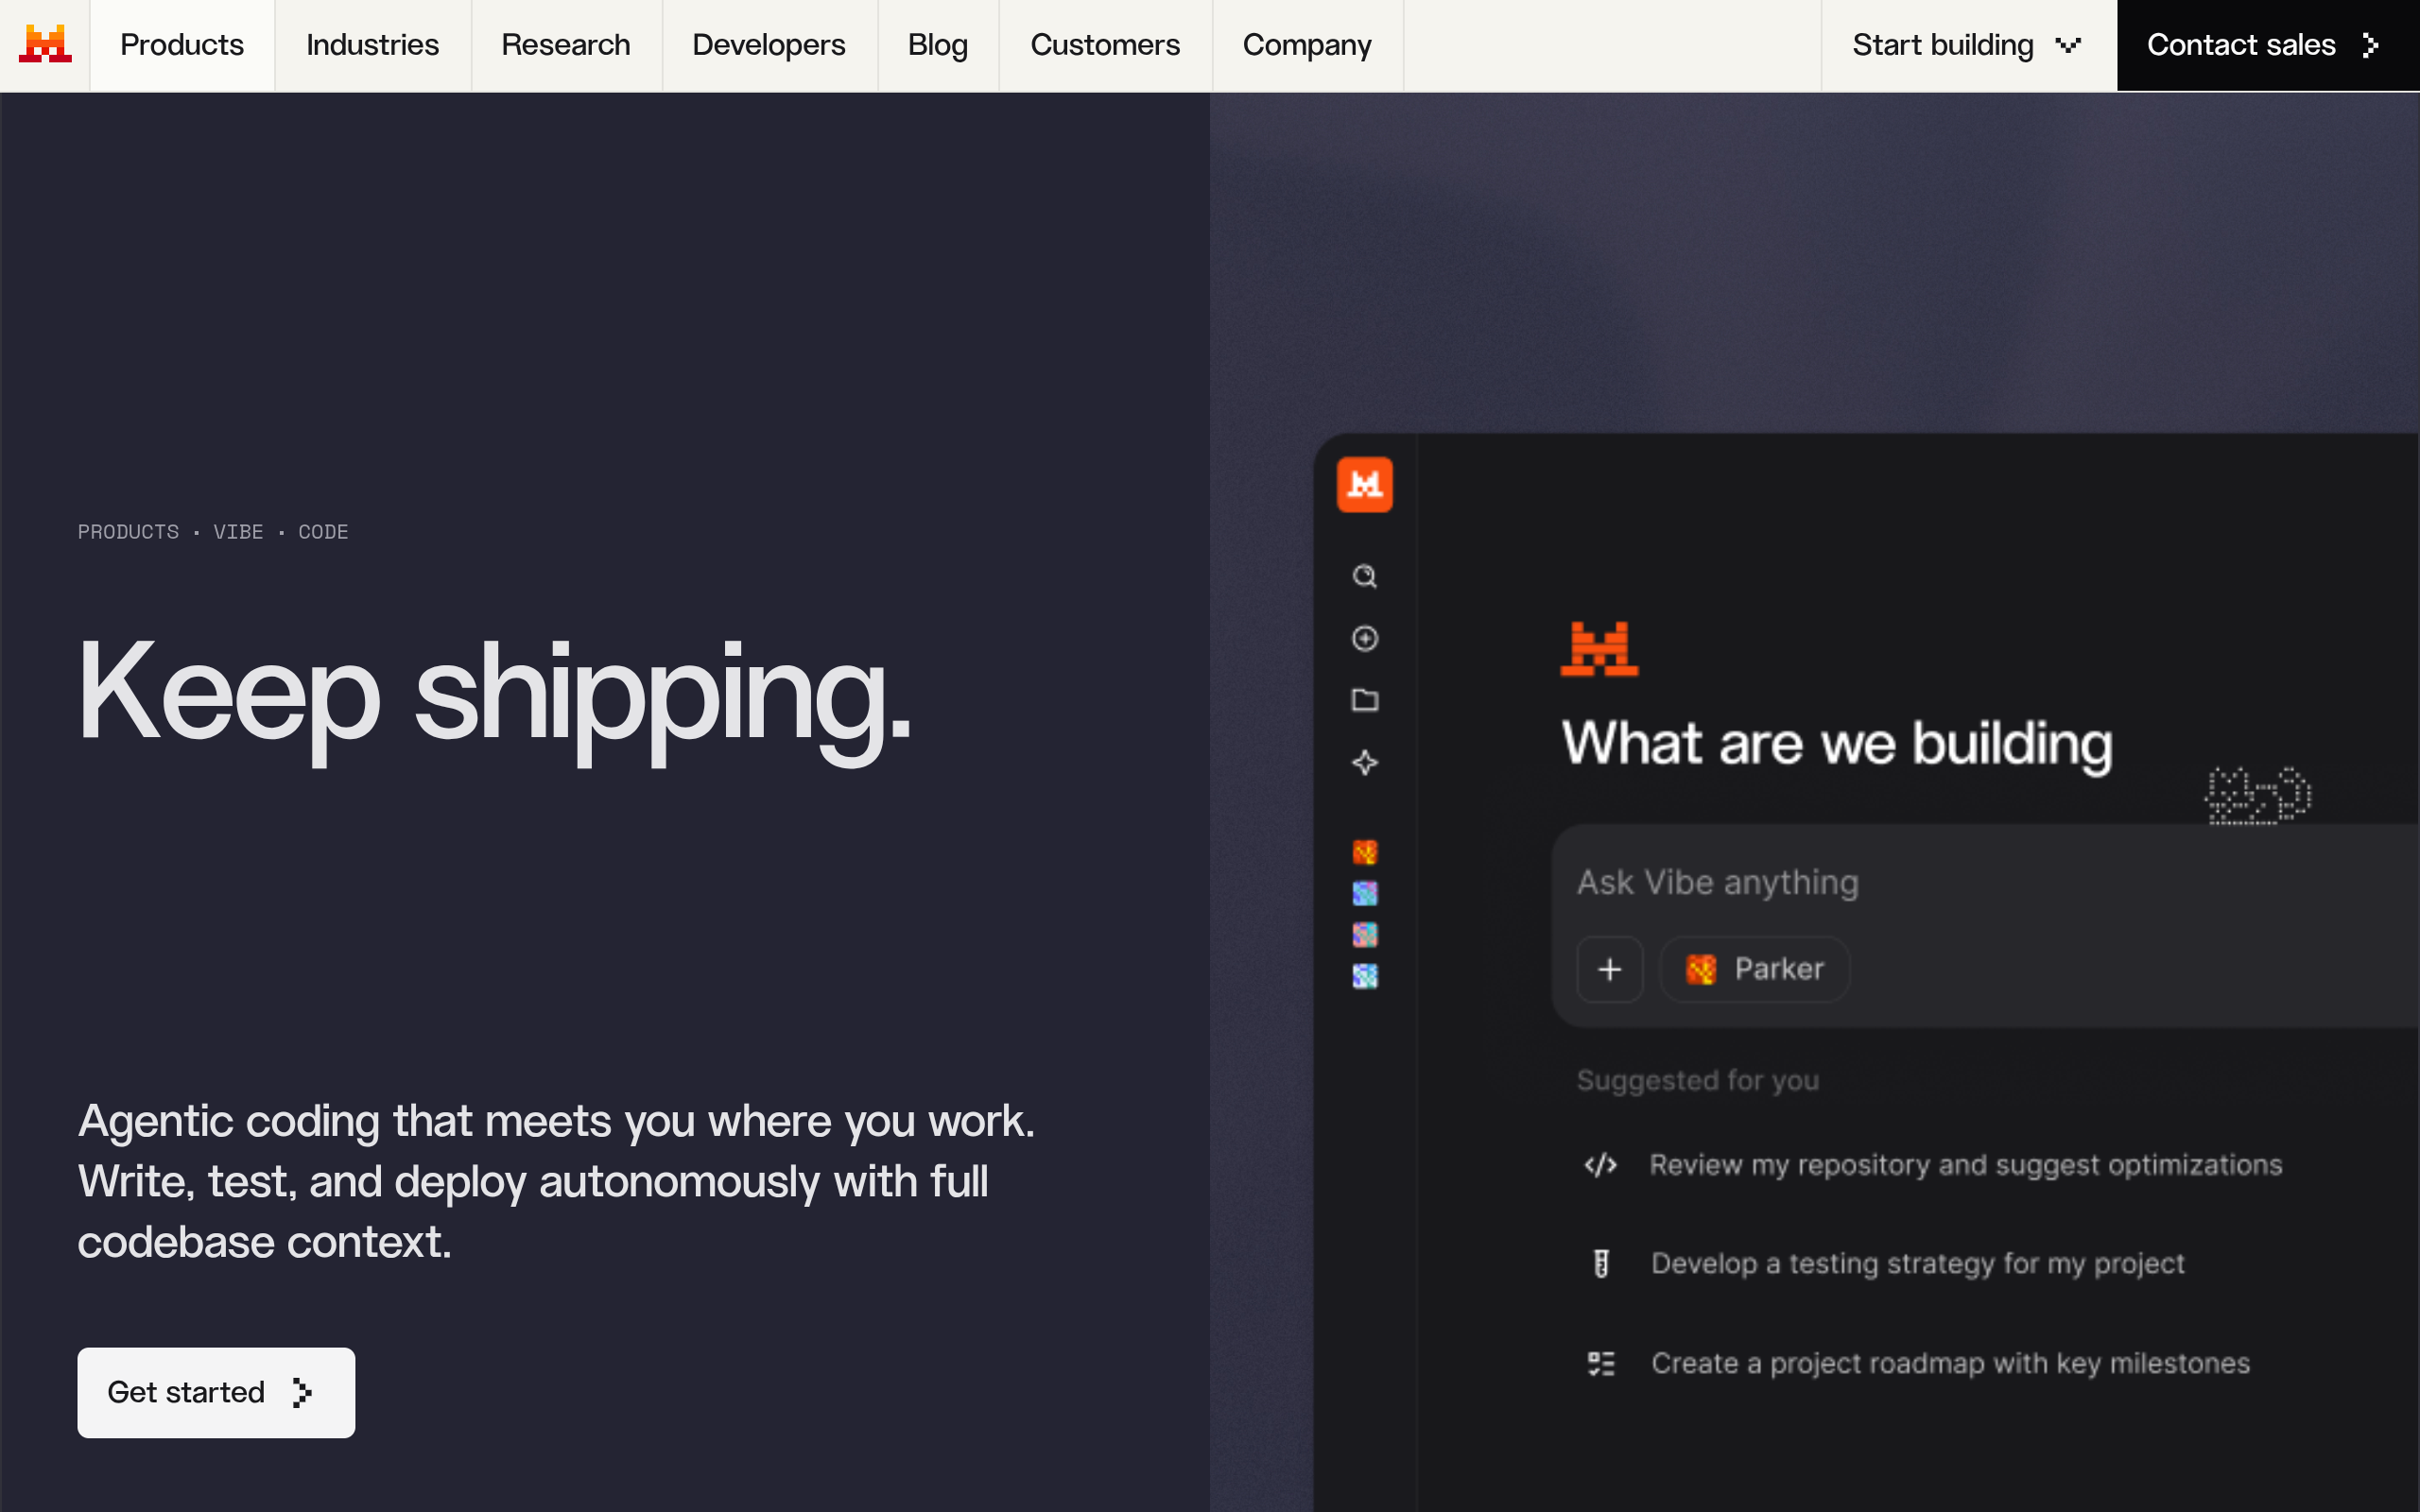
Pixtral 12B是Mistral AI团队推出的多模态AI模型官方介绍页面,核心定位为向开发者、研究人员及企业用户提供该模型的完整技术参数、功能特性、应用场景说明。页面涵盖模型性能测试数据、多模态任务处理能力演示、接入部署指南三类核心内容,目标用户覆盖AI研究人员、应用开发者、企业技术团队等群体,可用于技术选型评估、模型集成开发、行业应用方案设计等场景,帮助用户全面了解Pixtral 12B的技术特性与使用边界。
Open WebUI.com
Open WebUI是一款可扩展的自托管人工智能界面工具,支持完全离线运行,可适配不同用户的工作流程需求。核心功能包括多模型统一管理、文档交互处理、代码辅助生成,同时支持自定义插件扩展能力,能够满足本地部署AI服务的各类使用需求。目标用户覆盖开发者、科研人员、企业运维人员、内容创作者、数据处理人员等群体,可用于本地隐私数据处理、离线AI服务搭建、代码项目开发辅助、内部文档智能分析等多种场景,帮助用户在保障数据安全的前提下提升工作效率。
Nous Research
Nous Research是一家聚焦AI开源研究的机构官网,核心定位是研发与人的需求对齐的开源语言模型与相关技术工具。平台核心功能包括开源模型资源下载、研究成果论文发布、技术社区交流对接,目标用户覆盖AI研发人员、高校研究学者、AI应用开发者、科技行业从业者等群体,可应用于AI模型训练优化、垂直场景AI应用开发、AI技术学术研究、开源AI技术协作等多种场景。平台坚持开源开放的发展路线,所有研究产出的模型均支持非商用场景免费使用,同时提供配套的训练框架、数据集等资源,帮助开发者降低AI研发的技术门槛。
OmniAudio-2.6B
OmniAudio-2.6B是Nexa AI推出的参数规模为2.6B的多模态音频处理模型官网,核心定位为面向边缘设备的统一架构音频文本处理工具。其核心功能包括端侧低延迟音频理解、多模态输入联合处理、轻量化部署适配三大方向,支持用户在无需依赖云端算力的前提下完成音频内容解析、语音指令响应、音频文本联合推理等任务,目标用户覆盖AI应用开发者、嵌入式设备研发人员、边缘计算从业者、科研机构研究人员等群体,可应用于智能语音助手开发、离线语音交互功能搭建、端侧音频内容分析、低功耗智能设备研发等多个场景。
WebLlama
WebLlama是基于Meta Llama 3微调开发的网页导航智能代理,核心定位为辅助用户完成网页交互操作的协作式AI工具。核心功能包括网页内容理解与导航指令执行、多轮对话式操作引导、网页元素定位与交互辅助。目标用户覆盖需要处理网页操作的普通网民、网页测试人员、内容采编人员、无障碍上网用户等。使用场景包括浏览长网页时快速定位所需信息、批量处理表单填写操作、按照指令完成多步骤网页任务、辅助视障用户完成网页交互等,所有操作均以辅助用户决策为核心,不会替代用户完成高风险操作。

RAGFlow
RAGFlow是一款开源的检索增强生成(RAG)引擎,核心定位为基于深度文档理解的大模型应用开发支撑工具。其核心功能包括多格式复杂文档解析、可配置的检索增强工作流、可溯源的引文引用机制,主要面向大模型应用开发者、企业IT部门、AI解决方案服务商等用户,可应用于企业内部知识库问答系统搭建、智能客服知识库构建、行业专业文献问答工具开发、大模型幻觉问题优化等场景,帮助用户在结合大语言模型生成内容时,提升回答的准确性与信息可信度。

AGIBOT WORLD
AGIBOT WORLD是面向具身AI与机器人学习领域的大规模开源数据集平台,核心定位是为机器人技术研发提供标准化的数据支撑与研究底座。平台包含百万级机器人交互轨迹数据、多维度算法基准测试工具,以及覆盖硬件适配、算法落地的开放生态系统,服务于高校科研人员、机器人企业研发团队、AI算法工程师等群体,可支持具身AI模型训练、机器人操控算法迭代、多智能体协作方案验证等多种研究与开发场景,助力降低机器人学习领域的研究门槛,推动相关技术从实验室向产业化落地。

Kolosal AI
Kolosal AI 是专注于本地设备训练与运行大型语言模型的开源技术工具平台,核心定位是降低大模型本地化部署与应用的技术门槛。平台支持多硬件适配调度、低资源环境模型优化、端到端部署链路管理三大核心功能,面向AI算法研发人员、独立开发者、企业技术团队、科研机构从业者等用户群体,可满足个人本地搭建专属AI助手、企业私有化大模型部署、科研场景低资源模型训练、边缘设备AI能力集成等多场景需求,帮助用户在不依赖云端API的前提下完成大模型的训练、调优与落地应用。

FunAudioLLM
FunAudioLLM是面向语音交互开发场景的开源技术框架,核心目标是优化人类与大语言模型的自然语音交互体验。框架内置SenseVoice多模态语音理解模型与CosyVoice语音生成模型,支持多语种语音识别、情绪识别、音频事件检测、可控语音合成等能力,相关代码与模型权重已开源开放。适合AI应用开发者、语音交互产品研发人员、学术研究人员使用,可应用于智能客服系统搭建、有声内容制作、多语种语音助手开发、语音类AI产品原型验证等多种场景,帮助降低语音交互相关功能的开发门槛。

TryOnDiffusion
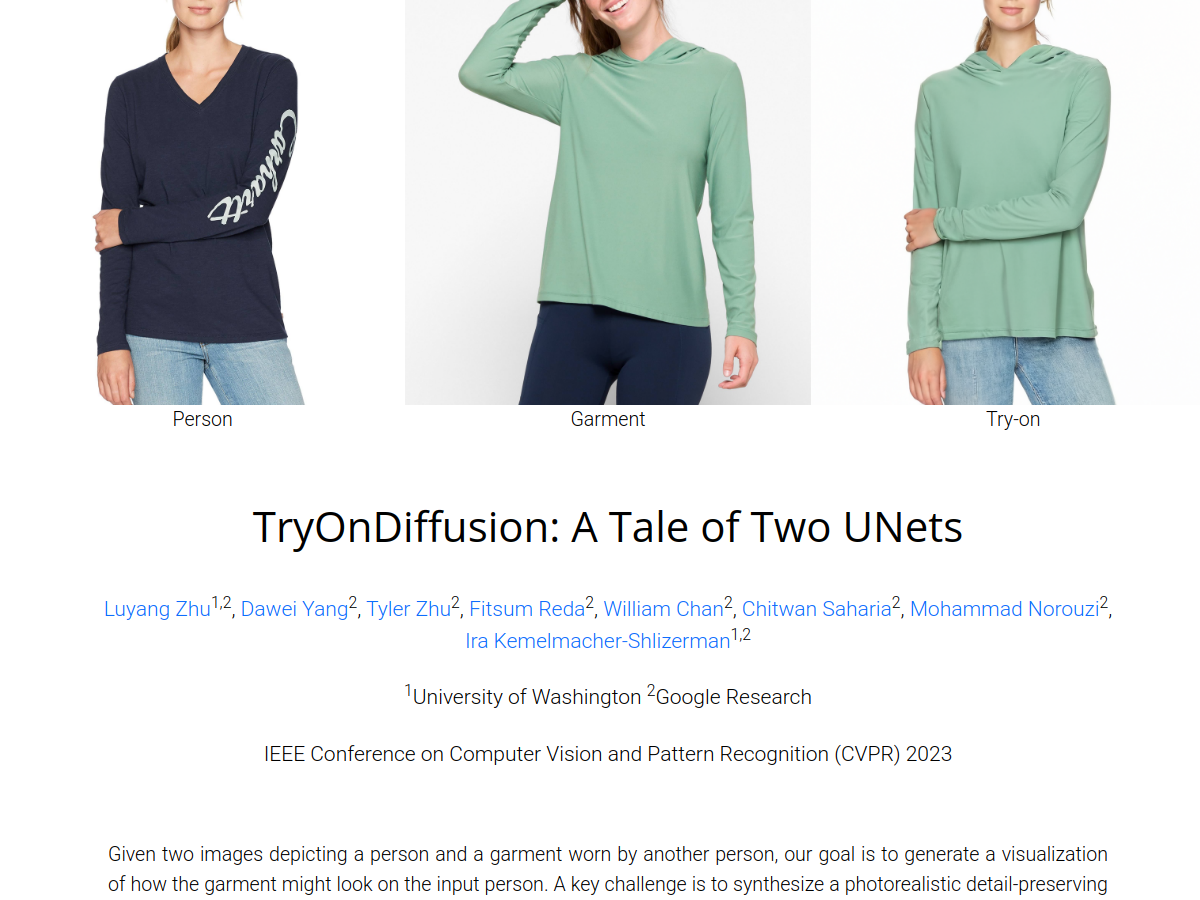
TryOnDiffusion是专注于虚拟试穿技术研究的学术项目网站,核心基于扩散模型实现高还原度的服装虚拟试穿图像生成。网站提供完整的技术原理说明、公开测试数据集、效果对比Demo、论文下载及代码开源资源,主要面向计算机视觉领域研究人员、电商技术开发人员、服装行业数字化从业者,可用于虚拟试穿技术研发、电商商品展示方案迭代、服装数字化落地场景验证等场景,帮助相关从业者了解前沿试穿合成技术的实现逻辑与应用潜力。

DenserRetriever
DenserRetriever是面向RAG场景开发的开源AI检索模型工具站,核心定位是为开发者和企业提供高性能的检索增强生成配套检索解决方案。核心功能包括异构检索器融合适配、预训练模型快速下载、Docker一键部署支持、MTEB基准测试结果查询、自定义模型微调工具包。目标用户覆盖AI算法工程师、RAG系统开发人员、企业AI技术团队、开源AI贡献者,可用于企业内部知识库问答系统搭建、垂直领域大模型检索模块开发、AI检索技术科研测试、轻量级RAG应用快速落地等场景,帮助用户提升检索环节的匹配精度,降低RAG系统的开发部署门槛。

Dream 7B
Dream 7B是由香港大学NLP组与华为诺亚方舟实验室联合研发的扩散大语言模型官方介绍站点,核心定位为向学术研究者、AI开发人员及相关行业从业者公开模型技术细节、性能数据与应用落地方向。站点提供模型技术框架解析、多场景测试数据集、推理能力基准测试结果、开源部署指引与合作申请通道等核心内容,适合自然语言处理领域学者做技术对比、AI开发者选型大模型底座、企业技术团队评估落地可行性等场景使用,可帮助用户全面了解该模型在复杂推理、长期规划、上下文连贯性上的技术特性与应用边界。
MaxKB
MaxKB(全称Max Knowledge Brain)是飞致云推出的开源企业级智能体平台,核心定位为降低企业AI落地门槛,帮助企业快速构建专属智能应用。平台支持高效RAG知识库构建,可快速导入多格式企业私有数据并完成向量化处理,减少大模型幻觉;内置Agentic工作流引擎,支持编排复杂AI流程实现业务自动化;兼容市面上主流公有云及私有化部署大语言模型,无需绑定特定厂商服务。目标用户覆盖企业IT部门、运营团队、客服部门、教育机构及研究人员等,可应用于智能客服搭建、内部知识库助手开发、业务流程自动化、学术资源整合等多元场景,助力企业将AI能力便捷融入现有业务体系。
关于开源AI模型
开源AI模型类工具指开放模型权重、代码或部署权限的AI生成类工具,解决闭源模型无法自定义修改、本地部署受限、数据隐私无法自主管控的问题,典型使用场景覆盖企业私有业务系统嵌入、科研机构模型微调实验、个人开发者本地离线AI应用搭建、行业场景专属模型二次开发等。
当前这类工具的形态存在明显分化,一类是独立发布的单款开源大模型产品,侧重特定能力优化,另一类是开源模型聚合社区,提供多类开源模型的下载、微调、部署一站式服务;能力维度上可分为通用大语言模型、多模态模型、垂直领域专用模型,多数基础开源模型可免费获取非商用授权,商用场景需单独申请对应授权,部分聚合平台提供免费基础调用额度与增值付费服务。
选型时优先确认自身使用场景的授权规则,非商用个人开发可选择宽松开源协议的模型,商用场景需提前核实授权条款避免合规风险。
开源AI模型常见问题
开源AI模型怎么选?
先明确使用场景的授权要求,非商用选宽松协议模型,商用提前核实授权条款,有垂直需求优先选对应领域优化的模型。
开源AI模型免费还是收费?
多数开源模型非商用场景可免费获取使用,商用需单独申请对应授权,部分聚合平台提供免费额度与增值付费服务。
开源AI模型适合谁用?
适合有本地部署、数据隐私管控需求的企业,开展AI相关实验的科研人员,以及想要自主定制AI应用的开发者群体。